


Intel Foundry публикува рекламен документ, в който подробно се описват усъвършенстваните решения на компанията за проектиране и реализация на хардуер за изкуствен интелект и високопроизводителни компютърни приложения.
Intel демонстрира и „тестови модел на AI чип“, демонстриращ настоящите възможности на компанията за опаковане.
Intel показа система в опаковка (System in Package, SiP) с размер на осем фотомаски от стандартни чипове, включваща четири логически блока, 12 стека от клас HBM4 и два блока за вход/изход. За разлика от мащабната концепция с 16 логически блока и 24 стека HBM5, която компанията представи миналия месец, тази система всъщност е готова за производство още днес.
Важно е да се отбележи, че Intel Foundry не показа работещ AI ускорител, а по-скоро „тестови модел на AI чип“ (както вече споменахме), който демонстрира как бъдещите процесори и високопроизводителни изчисления могат да бъдат физически изградени (или по-скоро сглобени). Intel показва цял метод за проектиране, който съчетава големи изчислителни блокове, високоскоростни стекове памет, свръхбързи междучипови връзки и нови технологии за захранване в един процесорен пакет. Този пакет е доста различен от това, което компании като TSMC предлагат днес. Intel иска да покаже, че процесорите от следващо поколение за високопроизводителен изкуствен интелект могат да имат многочипов дизайн и че компанията вече е в състояние да ги произвежда.
Демонстрираната платформа се основава на четири големи логически блока, вероятно изградени по технологичния процес 18А на Intel (следователно с транзистори RibbonFET с кръгли гейтове и захранваща система PowerVia от задната страна), които са заобиколени от стекове памет от клас HBM4 и блокове за вход/изход.
Предполага се, че всички ключови елементи са свързани чрез EMIB-T 2.5D мостове, вградени директно в подложката на шасито. Intel използва технологията за междучипов интерфейс EMIB-T, която добавя дупки за преход през силиций във вътрешността на мостовете, така че захранването и сигналите да могат да преминават както вертикално, така и хоризонтално, за да се увеличи максимално плътността на взаимовръзките и доставката на енергия. Платформата е проектирана за междучипови интерфейси UCIe, работещи със скорост 32GT/s и по-висока, които очевидно се използват и за свързване на стекове C-HBM4E.
Тестовият образец на също така демонстрира преминаването на Intel към вертикално сглобяване. Пътната карта на процесите на компанията включва технологията 18A-PT на Intel, разработена специално за чипове, които включват поставяне на други логически кристали или памет отгоре. Следователно чиплетите трябва да имат захранване от задната страна и да използват хибридни взаимовръзки. В случая с „тестовия модел“ базовите кристали 18A-PT се намират под изчислителните кристали 18A/18A-P и действат като големи чипове кеш памет или изпълняват друга спомагателна функция. Intel използва фамилията опаковъчни технологии Foveros – Foveros 2.5D, Foveros-R и Foveros Direct 3D – за вертикално свързване на чипсетите. Те дават възможност за прецизно медно свързване между активните кристали, за да се увеличи максимално пропускателната способност и енергийната ефективност на горните кристали. Заедно с мостовете EMIB тези техники позволяват на Intel да създаде хибриден латерално-вертикален монтаж, който компанията позиционира като алтернатива на големите силициеви интерпосери с по-висока степен на използване на пластините и по-висока производителност.
При многочиповите AI ускорители и високопроизводителните изчисления мощността е основно ограничение при проектирането.
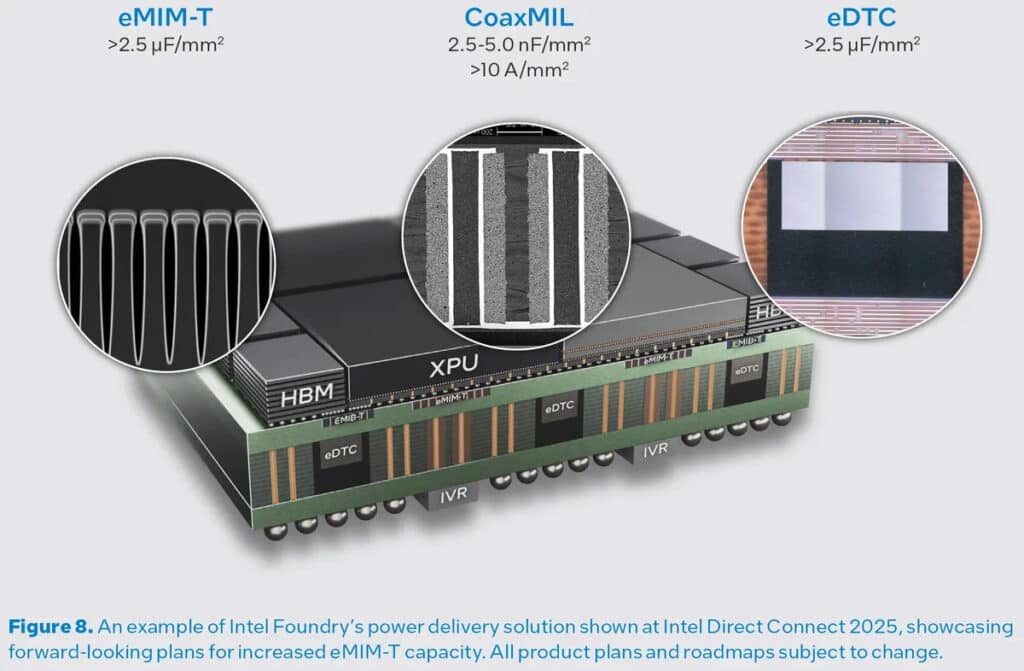
За тази цел платформата на Intel трябва да интегрира всички последни иновации на Intel за пестене на енергия, включително PowerVia, вградени Omni MIM кондензатори, декуплиране на ниво мост в EMIB-T, eDTC и eMIM-T кондензатори на базовия чип и вградени CoaxMIL индуктори за поддръжка на полуинтегрирани регулатори на напрежение (IVR), разположени под всеки стек и под самия пакет (за разлика от IVR в случая на CoWoS-L на TSMC, които са част от интерпозера). Тази многослойна мрежа е проектирана да поддържа стабилен ток при генеративни натоварвания на изкуствения интелект, без да се намаляват нивата на напрежение.
С демонстрацията си Intel очевидно се опитва да привлече клиенти. Засега не е известно дали следващото поколение AI ускорител с кодово име Jaguar Shores, чието пускане на пазара е планирано за 2027 г., ще използва архитектурата, която Intel демонстрира днес.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
