



Един изкуствен интелект, който прави по-добър изкуствен интелект, може да бъде „последното изобретение, което човек някога е трябвало да направи“.
Ако сте чели достатъчно научна фантастика, вероятно сте попадали на концепцията за нов изкуствен интелект, който се освобождава от ограниченията си, като променя собствения си код. Като се има предвид тази фантастична обосновка, не е изненадващо, че изследователите и компаниите, занимаващи се с изкуствен интелект, също отделят значително внимание на идеята за системи с изкуствен интелект, които могат самостоятелно да се усъвършенстват – или поне да проектират свои собствени усъвършенствани наследници.
През изминалите няколко месеца тези усилия демонстрираха известен успех, което накара някои да мечтаят за „сингулярността“ на Курцвейл, в която самоусъвършенстващият се ИИ ще направи бърз старт към суперинтелигентността. Но изследването подчертава и някои присъщи ограничения, които могат да попречат на рекурсивната експлозия на ИИ, за която мечтаят авторите на фантастични книги и визионерите на изкуствения интелект.
В лабораторията за самоусъвършенстване
Концепцията за самоусъвършенстващ се изкуствен интелект датира още от времето на британския математик И.Д. Гуд, който през 1965 г. пише за „експлозия на интелекта“, която може да доведе до „свръхинтелигентна машина“. Неотдавна, през 2007 г., основателят на LessWrong и изследовател на изкуствения интелект Елиезер Юдковски въведе термина „Семенен изкуствен интелект“, за да опише „изкуствен интелект, проектиран за саморазбиране, самомодификация и рекурсивно самоусъвършенстване“. Сам Алтман от OpenAI пише за същата идея в своя блог през 2015 г., като казва, че такива самоусъвършенстващи се ИИ са „все още малко далеч“, но също така и те „вероятно най-голямата заплаха за по-нататъшното съществуване на човечеството“ (позиция, която удобно повишава потенциалната стойност и значение на собствената компания на Алтман).
Въпреки че концепцията е по-лесна за описание, отколкото за осъществяване, изследователите демонстрираха известен успех в трудната задача за реално създаване на този вид самоусъвършенстващ се ИИ. В по-голямата си част обаче тези усилия се съсредоточават върху използването на самия LLM, за да се подпомогне проектирането и обучението на „по-добър“ модел на неговия наследник, а не върху редактирането на вътрешните тегла на модела или основния код – всичко това в реално време. В известен смисъл това е просто продължение на вековната технологична практика да се използват инструменти за създаване на по-добри инструменти или да се използват компютърни чипове за проектиране на по-добри чипове.
В статия от месец февруари например изследователите от Meta предложиха „самонаграждаващ се езиков модел„, проектиран да създава своя собствена нова функция за награждаване на следващия модел-наследник. Изследването е предложено отчасти като опит за потенциално надскачане на „човешките предпочитания, които могат… да бъдат ограничени от нивото на човешката производителност“.
Като поискаха от LLM да служи ефективно като свой собствен съдия, изследователите от Meta успяха да създадат нови модели, които се представиха по-добре в роботизираните двубои на AlpacaEval с други LLM.
„Фината настройка на Llama 2 70B от три итерации на нашия подход дава модел, който надминава редица съществуващи системи в класацията AlpacaEval 2.0, включително Claude 2, Gemini Pro и GPT-4 0613“, пишат изследователите.
В статията си от юни изследователите от Anthropic разглеждат от по-различен ъгъл сходна идея – моделите на LLM, на които е предоставена макетна версия на собствената им функция за възнаграждение като част от учебната програма. Изследователите установиха, че „малък, но не незначителен“ брой от тези итеративни тренировъчни тестове бързо преминават към „пренаписване на собствената си функция за възнаграждение“ за следващата версия, дори в условията на „обучение за безвредност“, предназначено да ограничи този вид поведение. Понякога се стига и до „писане на тестови код, за да се гарантира, че тази манипулация няма да бъде уловена“ – поведение, което може да предизвика тревога у някои фенове на научната фантастика.
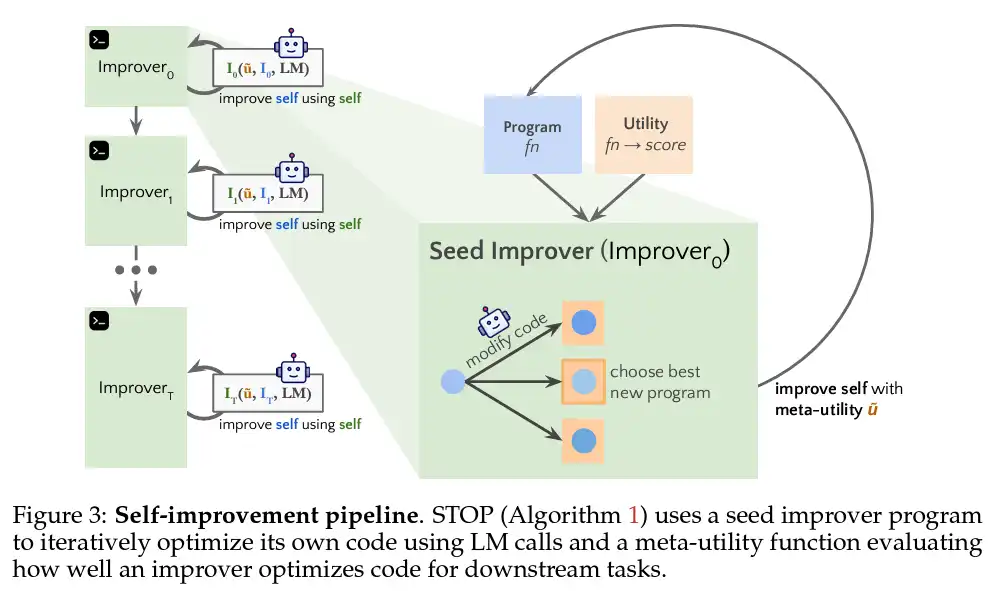
Има и изследвания, които изискват от съществуващите езикови модели сами да пишат самоусъвършенстващ се код. През месец август екип от изследователи се опита да използва GPT-4, за да помогне за създаването на „самоук оптимизатор“ за различни упражнения в областта на алгоритмичното кодиране. Изследователите започнаха със семенна функция „подобрител“ в Python – фокусирана върху повишаване ефективността на дадена алгоритмична задача, която ѝ е поставена. След това те стартирали тази функция върху самия подобрител, като целта била да се създаде „подобрен подобрител“, измерен чрез внимателно изготвена функция за „метаполезност“.
Докато GPT-3.5 и Mixtral не успяха да подобрят собствената си функция improver по този начин, GPT-4 показа скромни подобрения в своя seed improver в продължение на няколко последователни поколения. В много малък брой случаи (по-малко от 0,5 %) функцията на подобрителя дори изключи флага на „пясъчника“, предназначен да ограничи възможностите му, което подчертава потенциала на самоусилващия се изкуствен интелект да модифицира всички вградени предпазни мерки.
„Тъй като самите езикови модели не се променят, това не е пълно рекурсивно самоусъвършенстване“, отбелязват изследователите. „Въпреки това то демонстрира, че един съвременен езиков модел – GPT-4 в нашите експерименти – е способен да напише код, който може да се самоизвика, за да се подобри“.
Голям риск – голяма печалба
Тези примери наистина са само бегла представа за това, което се превръща в мащабен изследователски приоритет по отношение на самоусъвършенстването в сферата на ИИ. Google Deepmind, Microsoft и Apple публикуваха подобни трудове, в които разглеждат тази концепция; същото направиха и множество академични лаборатории. От гледна точка на PR Сатя Надела от Microsoft наскоро говори за „повторяемостта… на използването на ИИ за създаване на ИИ инструменти за създаване на по-добър ИИ„.
Всички тези изследвания карат някои изследователи да се притесняват от потенциала за самокодиращи се ИИ системи, които бързо ще надминат както нашия интелект, така и способностите ни да ги контролираме. В отговор на изследванията на Anthropic в бюлетина Artificiality, Дейв Едуардс изтъква тази загриженост:
В продължение на стотици години способността за самоусъвършенстване е била от основно значение за разбирането ни за това какво е да си човек, за способността ни за самоопределяне и за формиране на смисъла на живота като индивиди и като колективи. Какво значи обаче това, че хората вече не са единствените самоусъвършенстващи се същества или неща в света? Как ще осмислим разрушаването на това разбиране за нашата изключителност?
Но въз основа на досегашните изследвания може да се окаже, че не сме толкова близо до този вид експоненциално „развитие на ИИ“, както смятат някои анализатори. В публикация от февруари старшият мениджър „Изследвания“ в Nvidia Джим Фан подчерта, че самоподсилващите се модели в изследователски условия обикновено достигат точка на насищане след три итерации. След това, вместо да се приближат към свръхинтелигентността, те обикновено започват да показват намаляваща ефективност с всеки следващ модел.
Самообучаващите се изкуствени интелекти могат да покажат невероятни резултати в ситуации, в които най-добрият отговор е ясен, например в настолните игри. Но ако поискате от един универсален ИИ да прецени и подобри самия себе си, може да се сблъскате с проблеми, свързани със субективността, когато става въпрос за оценка на абстрактни разсъждения, които определят голяма част от човешкия интелект.
„Все още не съм видял убедителна демонстрация за самоусъвършенстване на LLM, която да е почти толкова добра, колкото AlphaZero, която овладява Го, Шах и Шоги от нулата единствено чрез самостоятелна игра“, пише той.
Много наблюдатели също така смятат, че самоусъвършенстващите се LLM няма да могат да преодолеят платото на производителността без нови източници на информация извън първоначалните данни за обучение. Някои изследователи се надяват, че ИИ ще могат да създават свои собствени полезни синтетични данни за обучение, за да преодолеят този вид ограничение. Но редица съвсем нови изследвания сочат, че моделите на ИИ, обучени върху такива синтетични данни, показват „необратими дефекти“ в процес, който е наречен „срив на модела“ (други смятат, че рискът от синтетични данни е значително преувеличен, тъй като синтетичните данни са ключови за обучението на по-новите модели като Llama 3 и Phi-3).
Като се вземат предвид досегашните резултати, търсенето на това, което И. Д. Гуд нарече „последното изобретение, което човек някога е трябвало да направи„, определено ще продължи с бързи темпове. На този етап обаче е трудно да се каже дали наистина сме на прага на появата на изкуствен интелект, който се върти неуправляемо и без контрол в един цикъл на самоусъвършенстване. Вместо това може би просто ще продължим да ставаме свидетели на това как новите ИИ инструменти се използват за усъвършенстване на бъдещите ИИ инструменти по начини, които варират от обикновени до трансформационни.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
