



В ново проучване от Hugging Face, изследователите демонстрираха как малките SLM езикови модели могат да бъдат настроени, за да превъзхождат много по-големите модели. Техните резултати показват, че моделът Llama 3 с параметри 3B може да надмине версията със 70B на модела при сложните математически проблеми. Hugging Face е документирал напълно целия процес и е предоставил пътна карта за фирмите, които търсят повече инструменти и техники, за да помогнат за извличането на максимума от своите ресурси.
Основната идея зад модели като o1 е по време на теста да се мащабира изчислението, което по същество означава използване на повече кръгове на изчисление при изводите и тестване и валидиране на различните отговори и пътища на разсъждение, преди да се получи окончателният отговор. Мащабируемите изчисления по време на тестовете са били особено полезни, когато няма достатъчно памет за изпълнение на големия модел.
Тъй като o1 е патентован модел и OpenAI мълчи относно вътрешните му механизми, изследователите спекулират как работи и се опитват да извършат обратна разработка на процеса. Вече има и няколко отворени алтернативи на o1.
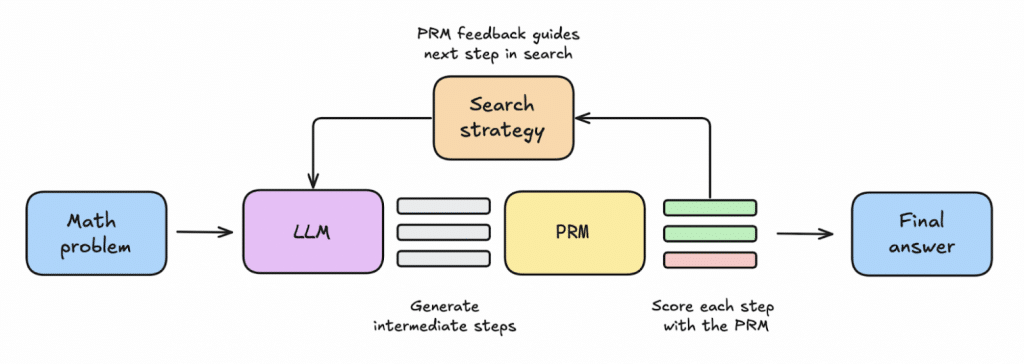
Работата на Hugging Face се основава на публикувано през август изследване на DeepMind, което изследва компромисите между времето за извод и предварителното изчисление. Проучването предоставя изчерпателни препоръки за балансиране на обучението и изчисленията на резултатите, за да се получат най-добрите резултати при фиксиран бюджет. Освен използването на допълнително време за изчисляване на изхода, успехът на метода зависи и от два ключови компонента: моделът на възнаграждение, който оценява отговорите на SLM, и алгоритъмът за търсене, който оптимизира пътя, използван за прецизиране на неговите отговори.
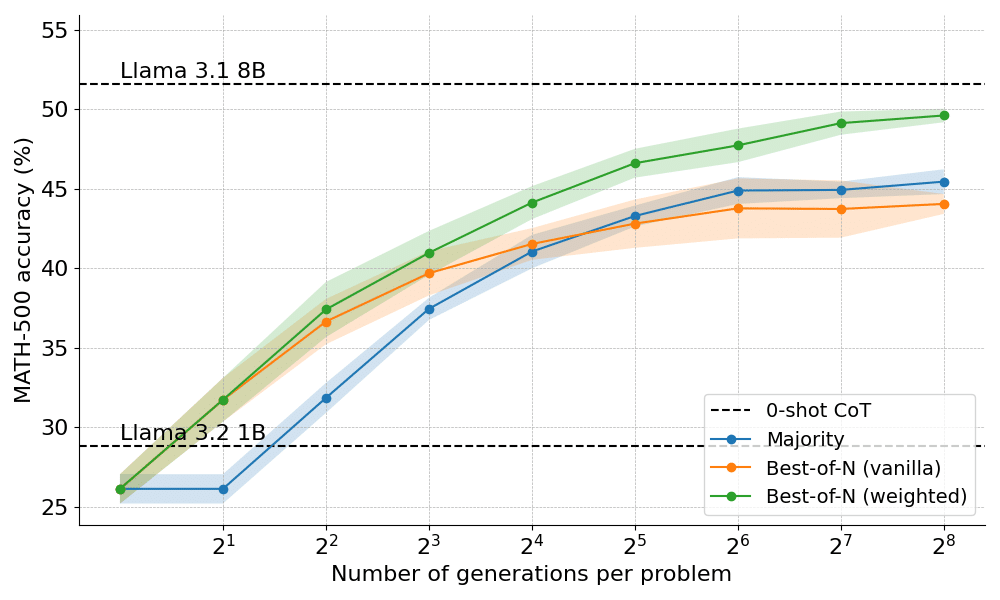
Най-лесният начин за използване на мащабирането на времето за тестване — чрез гласуване на мнозинството, при което една и съща подсказка се изпраща на модела няколко пъти и се избира тази с най-много гласове. За простите проблеми множественото гласуване може да бъде полезно, но резултатите му бързо остават маловажни при решаване на сложни проблеми с разсъждения или проблеми, при които грешките са последователни през поколенията.
По-усъвършенстваният метод за разсъждение е Best-of-N. При този метод SLM генерира множество отговори, но вместо множествено гласуване се използва модел на възнаграждение за оценка на отговорите и избор на най-добрия. Weighted Best-of-N – по-фината версия на този метод, взема предвид последователността, за да избере отговорите, които са едновременно валидни и се срещат по-често от други.
Изследователите са използвали PRM, който оценява реакцията на SLM не само по крайния отговор, но и по многобройните етапи, през които преминава, за да стигне до там. Техните експерименти показаха, че Weighted Best-of-N и PRM доближават Llama-3.2 1B до Llama-3.2 8B на предизвикателния бенчмарк MATH-500.
За да подобрят допълнително производителността на модела, изследователите са добавили алгоритми за търсене към процеса на разсъждение на модела. Вместо да генерират отговора с едно преминаване, те са използвали лъчево търсене.
На всяка стъпка SLM генерира няколко частични отговора. Алгоритъмът за търсене използва модел на възнаграждение за оценката на отговорите и избира подмножество, което си заслужава допълнително проучване. Процесът се повтаря, докато моделът изчерпи изходния си бюджет или достигне правилния отговор. По този начин бюджетът за изводи може да бъде стеснен, за да се съсредоточи върху най-обещаващите отговори.
Изследователите са установили, че докато лъчевото търсене подобрява производителността на модела при сложните проблеми, то съществува тенденция да бъде по-лош от другите методи при простите проблеми. За да разрешат недостатъка са добавили още два елемента към своята стратегия за изводи.
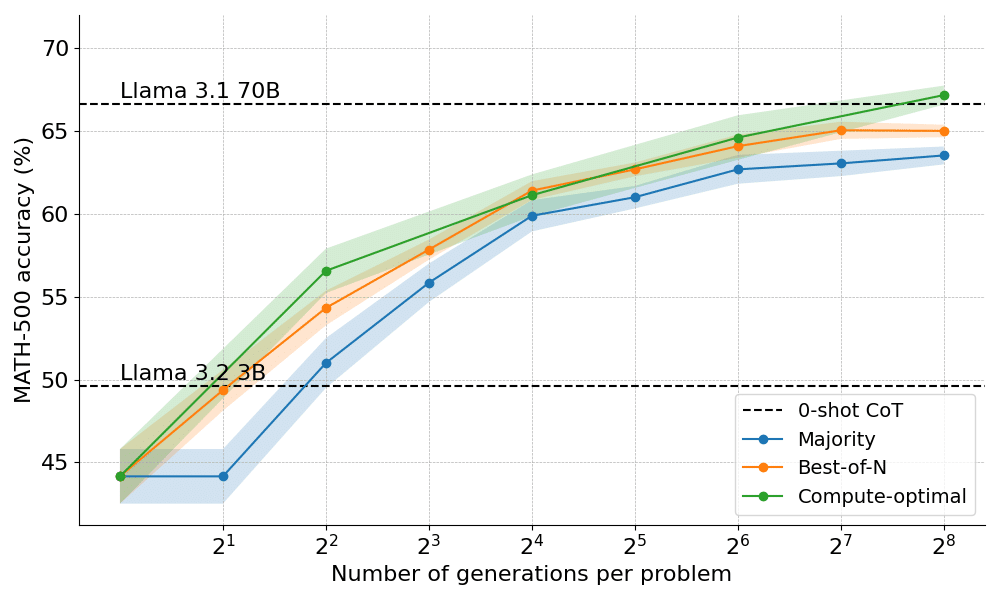
Първата беше Diverse Verifier Tree Search (DVTS), вариант на лъчево търсене, който гарантира, че SLM няма да заседне във фалшиви пътища на разсъждения и разнообразява своите отговори. Второ, разработили са „стратегия за оптимално изчисление за мащабирането“, както е предложено в документа на DeepMind, която динамично избира най-добрата стратегия за мащабиране на времето за тестване въз основа на сложността на входната задача.
Комбинацията от тези техники позволи на Llama-3.2 1B да надмине теглото си и да изпревари моделите с 8B със значителна разлика. Те също така са установили, че стратегията е мащабируема и когато се приложи към Llama-3.2 3B, са успели да надминат много по-големия модел 70B.
Мащабирането на изчисленията по време на тестване променя динамиката на разходите на моделите. Предприятията вече могат да избират къде да разположат своите изчислителни ресурси. Например, ако имате малко памет или можете да толерирате по-бавните времена за реакция, можете да използвате малък модел и да отделите повече времеви цикли за изводи, за да получите по-точни отговори.
Въпреки това времето за тестване на мащаба също има своите ограничения. Например, в експериментите, проведени от Hugging Face, изследователите са използвали специално обучения модел Llama-3.1-8B като PRM, който изисква паралелно изпълнение на два модела.
Техниката за мащабиране на времето за тестване, представена в това проучване, също е ограничена до задачи, при които отговорът може да бъде ясно оценен, като кодиране и математика. Разработването на модели за възнаграждение и верификатори за субективните задачи като творческо писане и продуктов дизайн изисква допълнителни изследвания.
Но е ясно, че мащабирането предизвика голям интерес и активност по време на тестването и можем да очакваме, че през следващите месеци ще се появят повече инструменти и методи.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
