


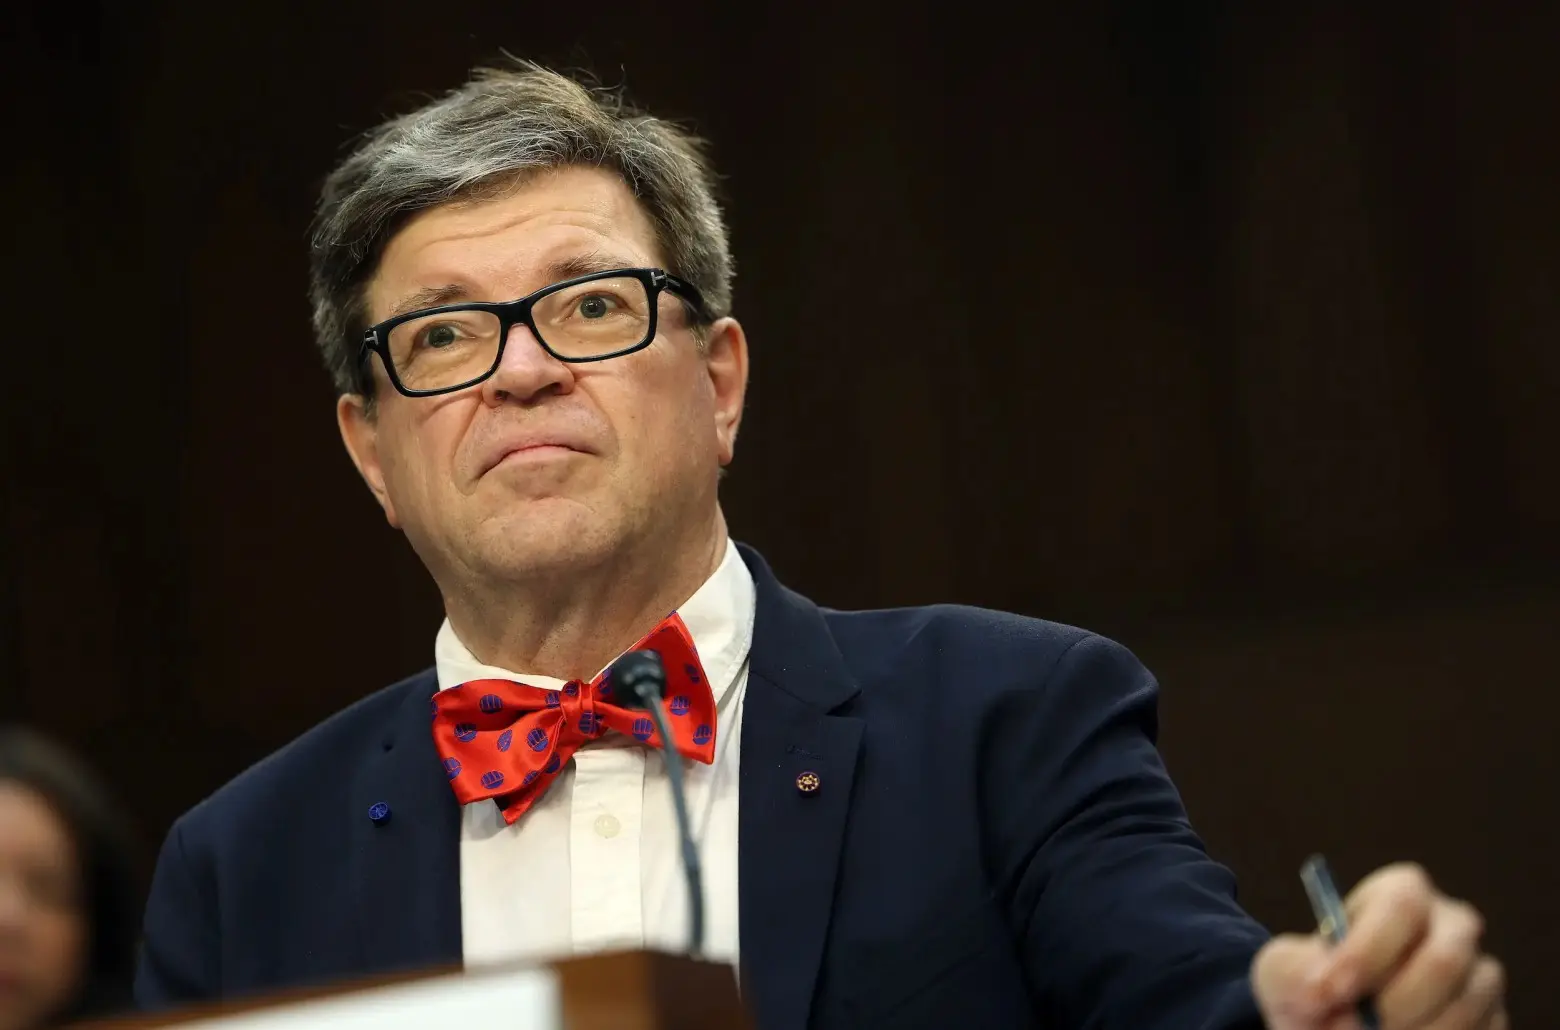

Ян Лекун, един от кръстниците на съвременния изкуствен интелект, в своя туитър остро критикува корпоративните изследователи на изкуствения интелект, които преследват собствените си разработки и се занимават с „всяване на страх“. Сред споменатите са Сам Алтман (OpenAI), Демис Хасабис (Google DeepMind) и Дарио Амодей (Anthropic).
Ян Лекун е френски и американски учен в областта на машинното обучение и компютърното зрение. Известен е като автор на легендарната система LeNet (1989 г.), в която е един от първите, приложили методите на биологичните невронни мрежи към оптичното разпознаване на символи (OCR).
Сега е вицепрезидент и водещ изследовател в областта на изкуствения интелект в Meta Corporation (наред с другото ръководи разработването на оптичния езиков модел LLaMA). Същевременно остава ревностен поддръжник на open source, свободната наука и научно-техническия прогрес на човечеството.
Ян Лекун е роден в предградията на Париж, получава диплома по електротехника и електроника в инженерното училище ESIEE в Париж (1978-1983 г.), а след това защитава докторат по компютърни науки в университета „Пиер и Мария Кюри“, сега университет „Сорбона“ (1983-1987 г.).
През 1987 г., преди да получи докторската си степен, той предлага ранна версия на алгоритъма за обратно разпространение ма грешките при невронните мрежи.
След това се занимава с изследвания в областта на машинното обучение като постдокторант под ръководството на Джефри Хинтън в Университета в Торонто в периода 1987-1988 г. (както и Иля Суцкевер, повече за това по-долу).
След това започва дълга и успешна кариера в американски компании.
Разпознаване на символи. Първите системи за машинно зрение, базирани на невронни мрежи
След като получава докторската си степен през 1988 г., Ян Лекун постъпва на работа в AT&T Bell Laboratories в Холмдел, Ню Джърси, където разработва редица методи за машинно обучение, включително конволюционни невронни мрежи.
Първата разработка представлява архитектура на невронна мрежа, която разпознава ръкописните цифри на пощенските кодове с много нисък процент на фалшиви положителни резултати. Системата е описана в научни статии от 1988 и 1989 г.
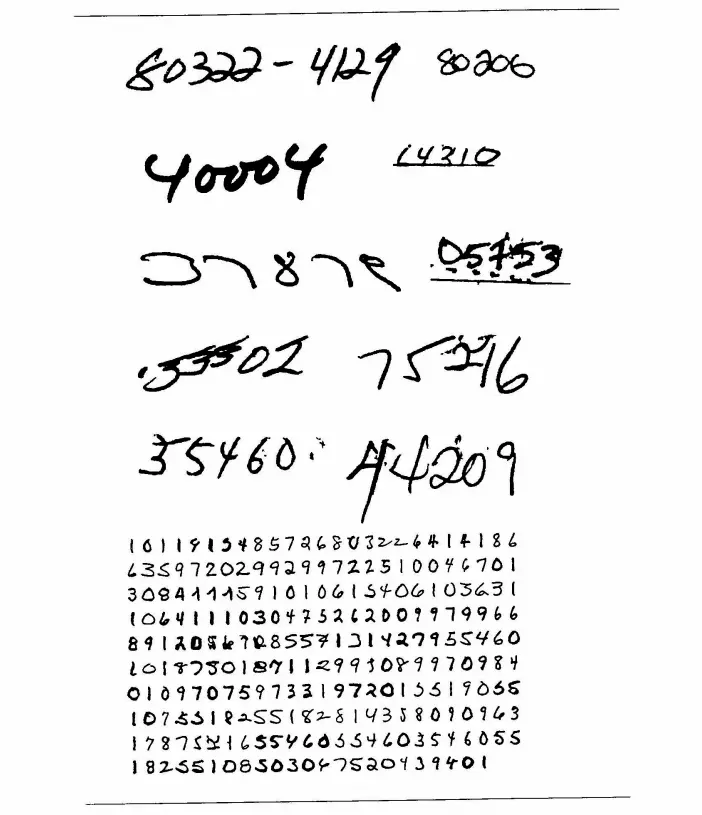
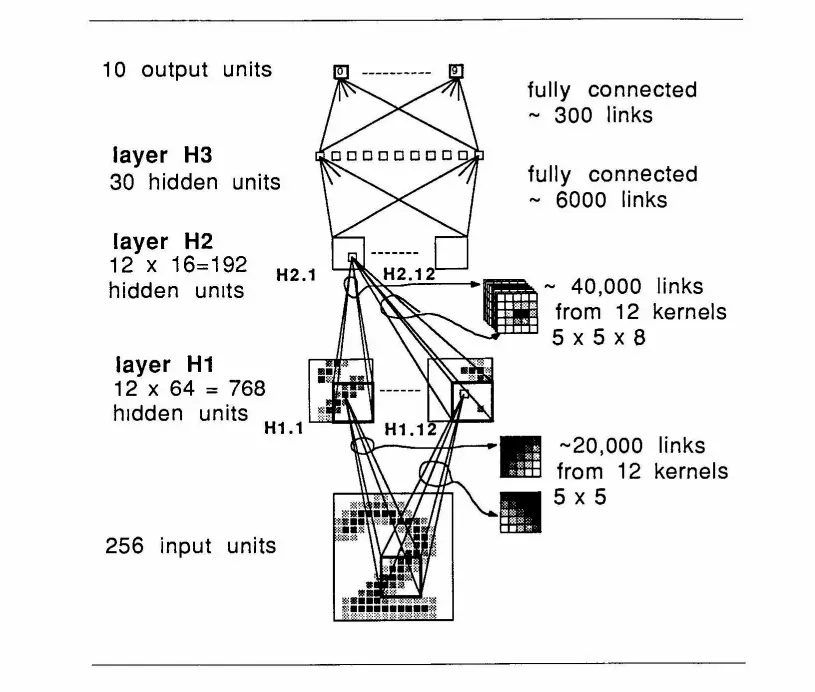
Архитектура на невронната мрежа от научната статия от 1989 г. „Приложение на метода за обратно разпространение на грешките за разпознаване на ръкописни пощенски кодове“:
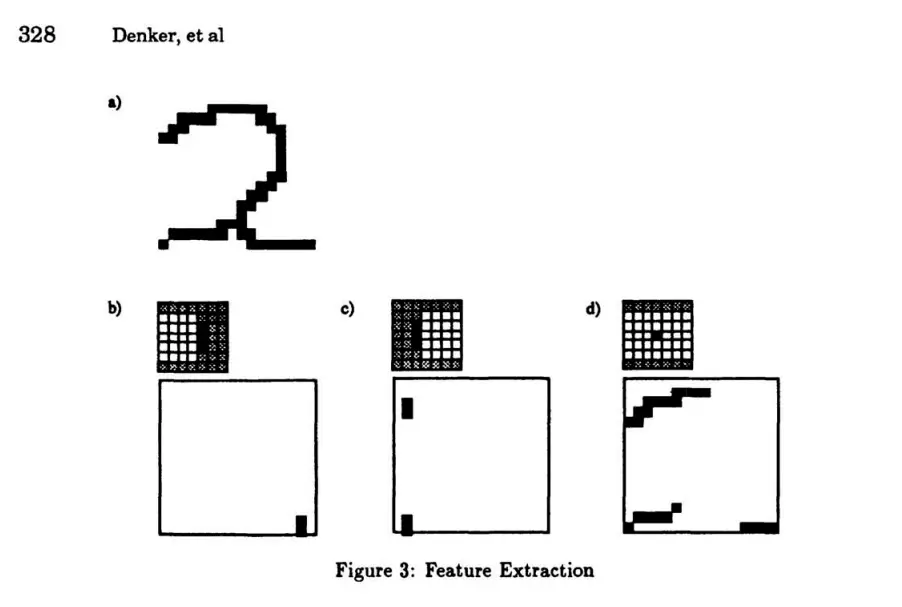
Извличане на признаци (характеристики) от дигитализираните ръкописни символи, както е описано в изследователския документ от 1988 г. „Система за разпознаване на ръкописни цифри на пощенските кодове“:
LeNet
В допълнение към обратното разпространение на грешките за тази и други системи за OCR Ян Лекун е разработил и приложил няколко иновативни техники за машинно обучение:
- конволюционни невронни мрежи, моделирани на базата на биологичните системи,
- методи за регуларизация на невронните мрежи, описани в „Оптимално увреждане на мозъка“,
- Graph Transformer Networks (GTN), метод, подобен на Conditional Random Fields (CRFs).
Всичко това е използвано в иновативни системи за оптично разпознаване на символи (OCR) на банкови чекове, пощенски писма и др. Впоследствие универсалната невронна мрежа на Лекун и колегите му е наречена LeNet и под това име впоследствие се споменава в научната литература. Именно по така тя остава в историята.
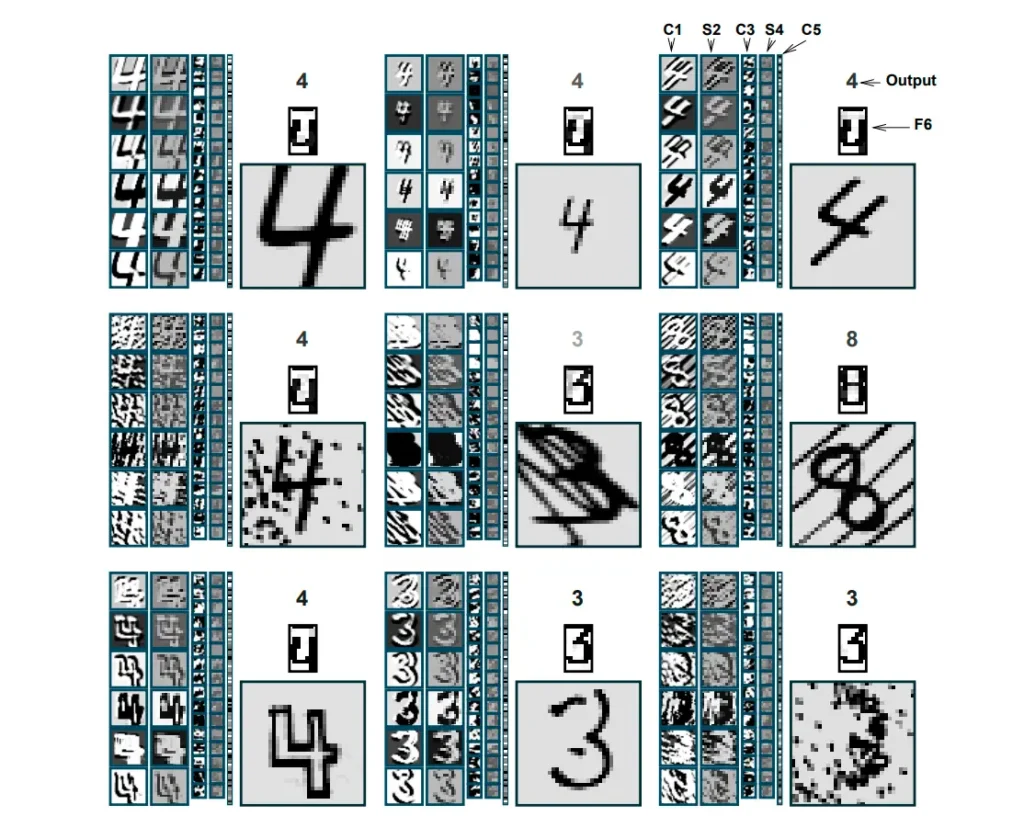
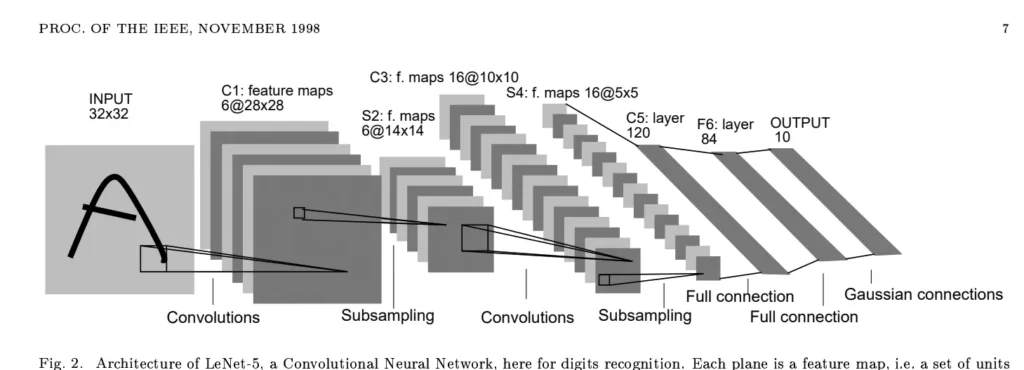
Архитектура на LeNet-5 от статията „Gradient-based learning for document recognition“ от 1998 г:
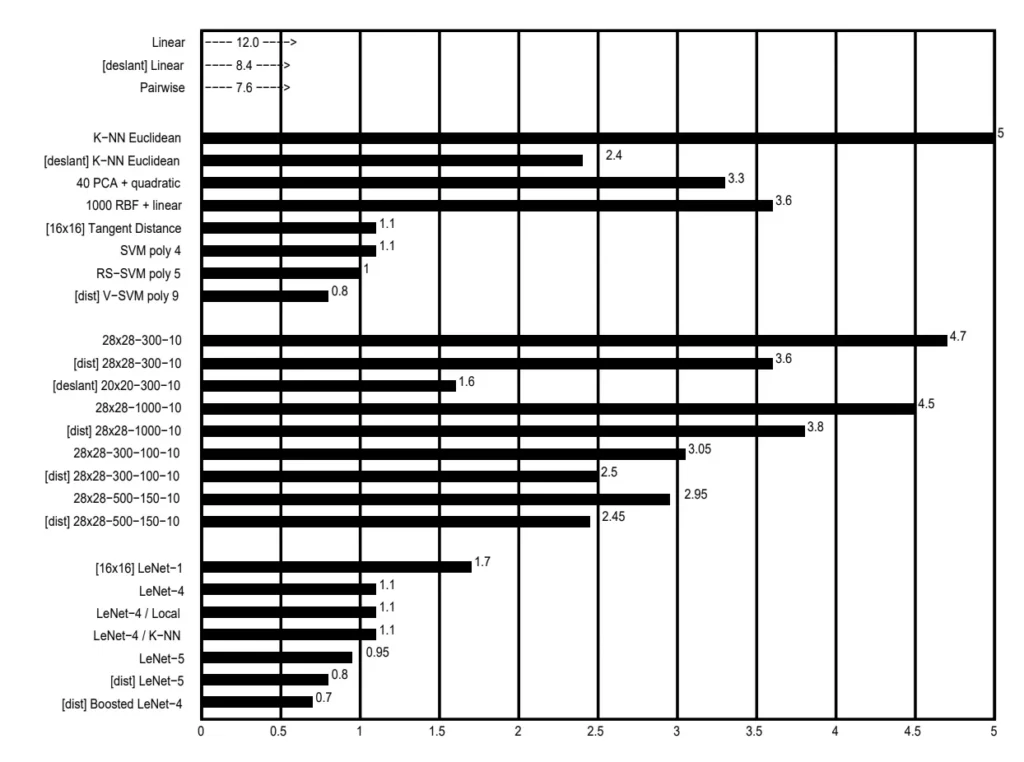
Процентът на грешка при тестовия набор от данни за различните методи за класификация (максимален процент на грешка около 0,1%),
Така, започвайки с LeNet, изкуствените невронни мрежи, моделирани въз основа на биологичните системи, които работят в нервната система на животните на Земята, започнаха да се използват за оптично разпознаване на символите (тъй като всички живи организми произхождат от един и същи източник, механизмът на действие на невронните мрежи е практически еднакъв за всички тях).
Така се ражда нов вид машинно зрение.
Това е основният принос на Лекун към съвременната индустрия на изкуствения интелект, която към 2025 г. разтърси цялото човечество.
Форматът DjVu
През 1996 г. Ян Лекун се присъединява към AT&T Labs-Research и работи основно върху разработването на технология за компресиране на изображения и формата с отворен код DjVu. Оптичното разпознаване на символите и компресирането на изображения е естествено продължение на работата на експерта по машинно зрение.
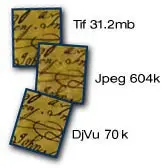
DjVu е конкурент на PDF като контейнер за сканирани документи. В същото време DjVu превъзхожда PDF по отношение на компресията. Според научна статия, описваща формата, страниците на цветните списания се компресират до 40-70 KB, черно-белите технически документи – до 15-40 KB, а древните ръкописи – до около 100 KB; едно задоволително JPEG изображение обикновено изисква 500 KB.
DjVu разделя оригиналното изображение на три слоя:
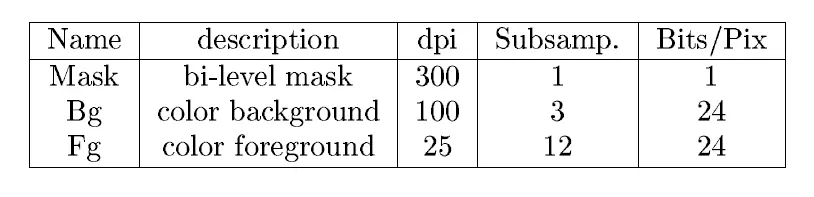
- Преден план. Информация за цвета на маската (3-ти слой), разделителната способност е максимално намалена.
- Фон. Илюстрации и текстура на страницата: резолюцията им е намалена по подразбиране, за да се пести място.
- Черно-бяла (еднобитова) маска. Маската се записва с разделителната способност на оригиналния файл и съдържа текстовото изображение и други отчетливи детайли.
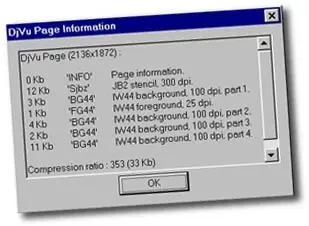
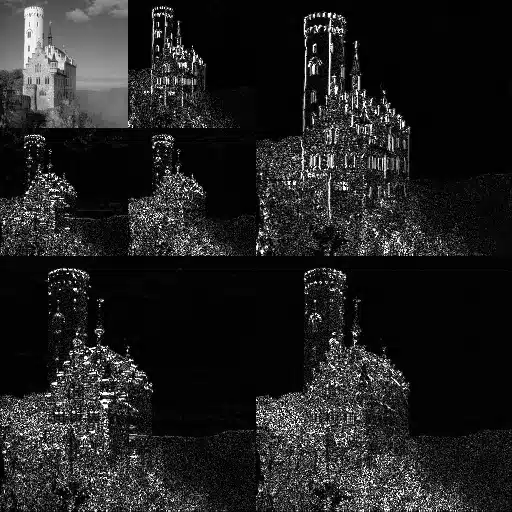
Фонът и предният план се компресират с помощта на вейвлет трансформация (както в JPEG2000), а маската се компресира с помощта на алгоритъма JB2. Това са били уникални за времето си усъвършенствани технологии за компресиране.
DjVu е оптимизиран за мрежови трансфери, така че страницата да може да бъде видяна преди изтеглянето на файла да е приключило.
Подобно на PDF, DjVu файлът съдържа текст (OCR), което позволява пълнотекстово търсене във файла. Файлът може да съдържа интерактивно съдържание и активни области – връзки, позволяващи лесна навигация в книгите.
Преди стандартизирането на PDF през 2008 г. DjVu се считаше за най-подходящия отворен формат за съхранение на електронни документи. По онова време дори нямаше програма за преглед на PDF за Linux, той беше затворен патентован формат. Общността беше склонна да приеме DjVu като единен стандарт за цифрови документи.
Някои организации все още използват DjVu за съхраняване и разпространение на сканирани документи, като например Internet Archive (въпреки че през 2016 г. сканирането на нови документи в DjVu беше преустановено).
Други проекти
През 2002 г., заедно с Леон Боту, разработва езика за програмиране Lush (Lisp Universal Shell), подобен на Lisp език за машинно обучение, пряк наследник на SN, написан през 1987 г. като интерфейс за симулатор на невронни мрежи. Авторите на Lush са същите като тези на DjVu. Доколкото може да се разбере, Lush е лишен от известните недостатъци на Python.
През последните десетилетия Лекун е съосновател, консултант и изследовател на редица нови компании и стартъпи, в някои от които все още участва:
- Съосновател и съветник на Element (2012 г. – понастоящем), която разработва технологии и софтуер за биометрична автентификация,
- съосновател на MuseAmi (2007 – 2016 г.): разработва иновативни софтуерни и хардуерни технологии за музикално продуциране, образование и развлечения, включително мобилните приложения Improvox, Hook’d и MusicPal,
- собственик на YLC Consulting LLC (2008 – 2013 г.): научноизследователска, развойна и технологична консултантска дейност в областта на софтуера, машинното обучение, машинното зрение, роботиката, извличането на данни, моделирането на данни, статистическия анализ, OCR, компресирането на данни, музикалните технологии и др.
По-нататъшна кариера
След Bell Labs и AT&T Labs през 2003 г. изследователят заема позицията на професор по компютърни науки и неврология в Института за математически науки „Курант“ към Нюйоркския университет (NYU). Той е и професор в Tandon School of Engineering на NYU.
През 2012 г. основава Университетския център за наука за данните с първата в света програма за висше образование в областта на data science
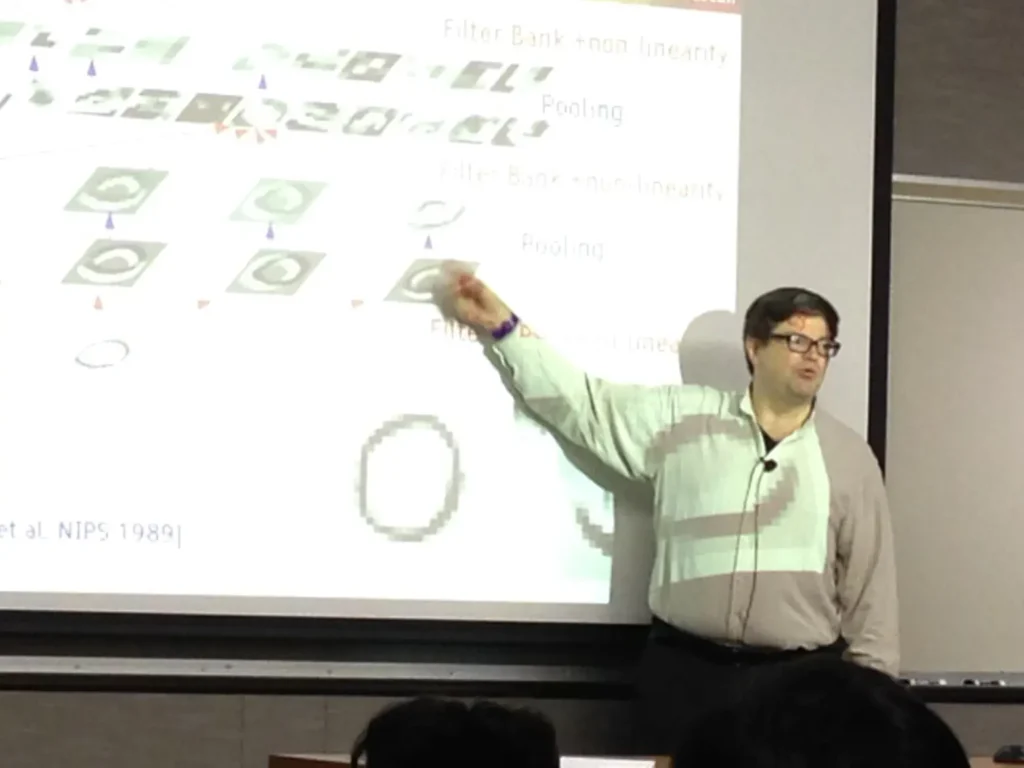
От 2013 г. ръководи лабораторията за изкуствен интелект във Facebook, а сега е вицепрезидент и главен учен по изкуствен интелект в Meta (VP & Chief AI Scientist).
Всъщност тази социална мрежа е една от първите, които започват да използват машинно обучение при разработването на приложения. Както каза Лекун в съобщението за Moments от 2015 г., това мобилно приложение разпознава хората в снимките и организира фотоалбума в смартфона ви. Същата технология е приложена в сайта на социалната мрежа. Тя се основава отчасти на работата, извършена от екипа на Facebook AI Research (FAIR), тогава ръководен от Ян Лекун.
През следващите години значението на машинното обучение става ясно за по-широк кръг от хора, а към 2025 г. – за почти всички. Както знаем, ИИ вече премина строгия тест на Тюринг и изпревари хората в изпълнението на голям брой приложни задачи.
Ян Лекун е носител на множество награди и отличия, включително наградата „Тюринг“ за 2018 г. заедно с Йошуа Бенгио и Джефри Хинтън като „бащи на революцията на дълбокото обучение“.
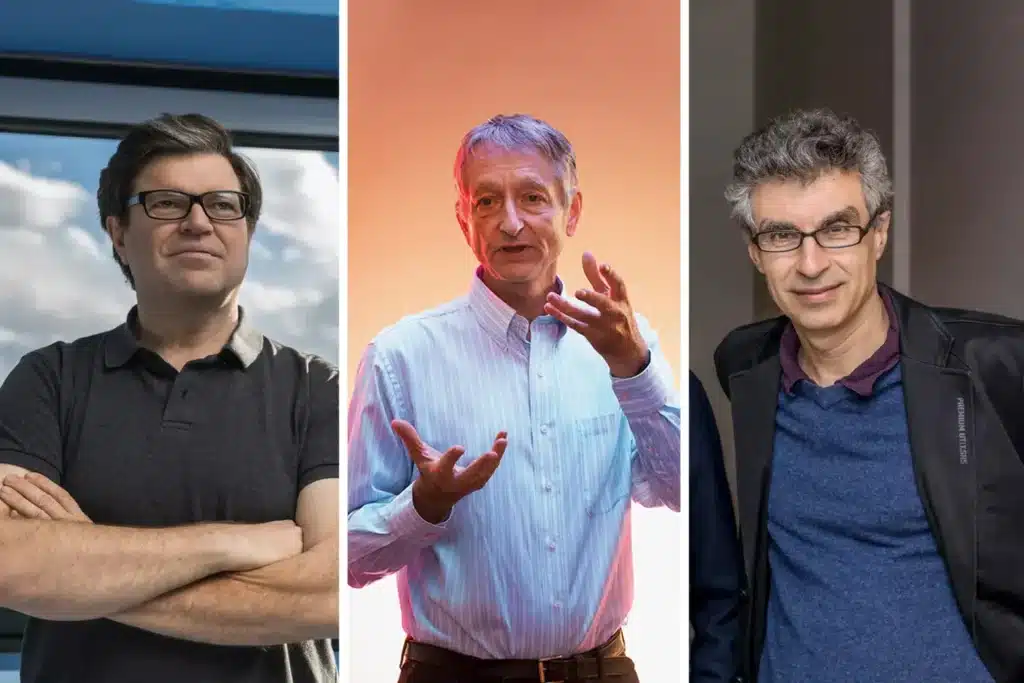
Нека си припомним, че Хинтън е бил научен ръководител на Иля Суцкевер, водещ разработчик на всички GPT модели в OpenAI, който сега работи върху свръхмощен изкуствен интелект. AlexNet на Суцкевер е конкурент на LeNet в сравнителните тестове.
Джефри Хинтън и Джон Хопфийлд получиха и Нобелова награда за физика за 2024 г. „за фундаментални открития, довели до машинното обучение и изкуствените невронни мрежи“.
Така че кръгът на изтъкнатите учени в областта на ИИ е добре известен и ограничен. Впрочем, както и във всяка друга област. И е твърде рано да се каже например, че Google DeepMind е победил всички и конкурентите нямат никакъв шанс. В други компании също работят блестящи умове като Ян Лекун, а ресурсите на ИТ корпорациите са практически неограничени, така че изходът от тази надпревара в никакъв случай не е сигурен.
Въпреки че работи в търговска корпорация, Ян Лекун остава последователен привърженик на отворения код, опитва се да публикува открито резултатите от изследванията, проведени от неговата изследователска група в Meta, и изнася лекции (например една от последните е „Математически пречки пред изкуствения интелект на човешко ниво“ на конференция по математика). Тоест той е преди всичко учен и изследовател, а след това служител на корпоративната машина. Неотдавнашната му публикация, в която той цитира DeepSeek и другите китайски LLMs като пример за успеха, постигнат с помощта на отворения код, се разпространи подобно на компютърен вирус:
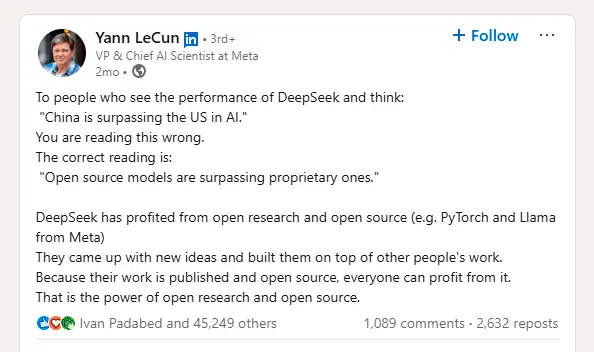
Това е необичайна гледна точка, която е в разрез с общата неприязън към Китай. Всъщност ние трябва да се гордеем с това, което те са направили – то е наше общо постижение.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
