


Alibaba Cloud отвори достъпа до „теглата“ и кода на фамилията модели Qwen3-TTS – набор от невронни мрежи за синтез на реч, които съчетават три търсени функции в един пакет наведнъж: генериране на глас от текст, „проектиране“ на глас чрез описание в текст и клониране на глас чрез кратка аудио референция. Публикацията обхваща не само самите модели (в два размера – 0,6 млрд. и 1,7 млрд. параметри), но и токенизатора на речта, благодарение на който системата може да работи в режим на поточно предаване на глас със закъснение от около 97 ms – т.е. на ниво, подходящо за разговорни интерфейси и „живи“ асистенти.
Отворената версия включва три клона: Base (основният модел за висококачествен TTS и бързо клониране), CustomVoice (контролирано озвучаване със „стилови“ профили) и VoiceDesign – най-представителният компонент на линията, който ви позволява да зададете параметрите на бъдещия глас на естествен език: от тембъра и начина на говорене до емоционалния модел и прозодията. В практически смисъл това е опит да се изведе настройката на синтеза от света на акустичните „копчета“ и фините инженерни настройки – в познати подсказки, които продуцентите, редакторите и разработчиците могат да разберат.
В техническо отношение Qwen3-TTS разчита на подходи от следващо поколение, които през последните две години активно заменят „класическите“ TTS конвенции. В техническия доклад екипът описва архитектура с „две писти“, предназначена за различни сценарии – от максимално качество до реално време – и две семейства токенизатори на речта едновременно.
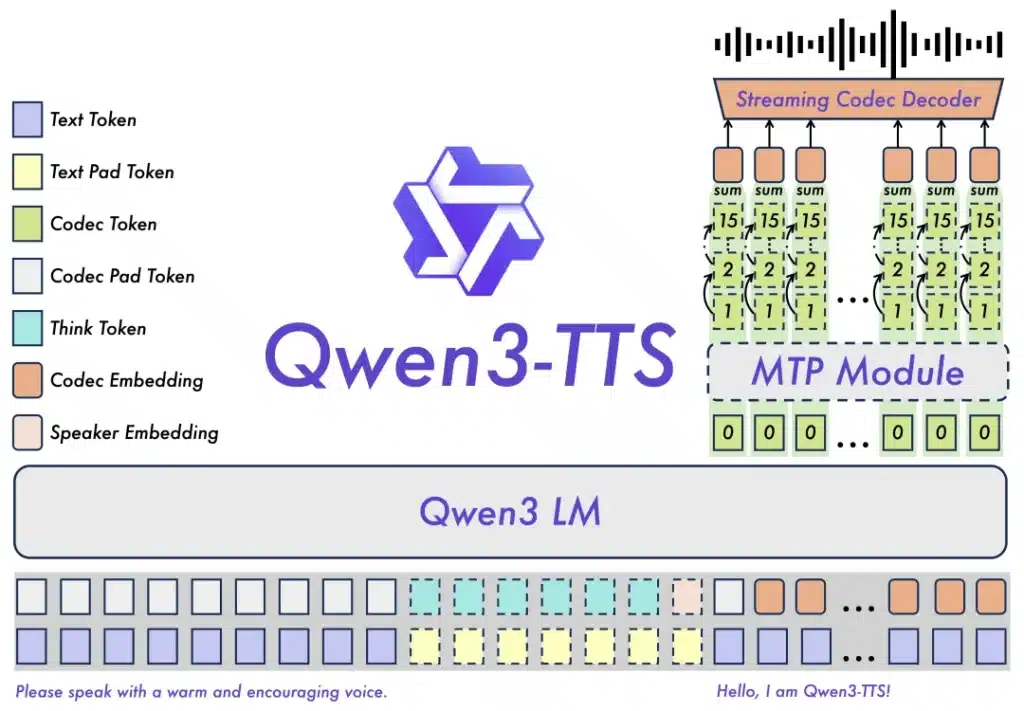
Ако се съди по хранилището и моделите на Hugging Face, първият от тях е токенизаторът с честота 12 Hz (Tokenizer-12Hz в бележките към изданието): той компресира речта до изключително нисък битрейт и позволява на системата да изпрати „първия пакет“ звук почти незабавно, което дава заявеното забавяне от десетки милисекунди.
Най-чувствителната за пазара функция е клонирането на гласа за секунди. В доклада се говори за „3-секундно клониране на глас“, а независимите разработчици вече демонстрираха механизма чрез публична демонстрация на Hugging Face: потребителят записва кратък референт и получава глас зад кадър на друг текст в „неговия“ тембър. Именно това е границата, отвъд която технологията престава да бъде екзотика за студията и се превръща в ежедневен инструмент – достатъчна е видеокарта с няколко гигабайта видеопамет или дори браузър, ако изчисленията се поемат от външна услуга.
Отделен практически показател за зрялост е лицензирането. Alibaba публикува моделите и токенизаторите под Apache-2.0, което е един от най-„комерсиалните“ лицензи: той се избира, когато искат да насърчат внедряването в продуктите и екосистемите на партньорите. От гледна точка на разпространението можем да видим разчитане на позната инфраструктура с отворен код: хранилище в GitHub и колекция от модели в Hugging Face, където са налични вариантите 0,6B и 1,7B, както и отделните артефакти на токенизаторите.
Контекстът на изданието е по-широката стратегия на Alibaba, която прекара последните две години в изграждане на присъствие в областта на изкуствения интелект както в корпоративните услуги, така и в потребителските продукти. Ройтерс отбелязва, че компанията непрекъснато разширява състава на Qwen и го популяризира като инфраструктурна платформа, а през януари 2026 г. съобщи за актуализация на приложението Qwen с акцент върху сценариите за „приложения“ – от планиране до транзакции в екосистемата на Alibaba.
Внасянето на семейството TTS в публичното пространство изглежда логично тук: гласът се превръща в интерфейс, а „собствената“ реч става също толкова актив, колкото текстът и изображението.
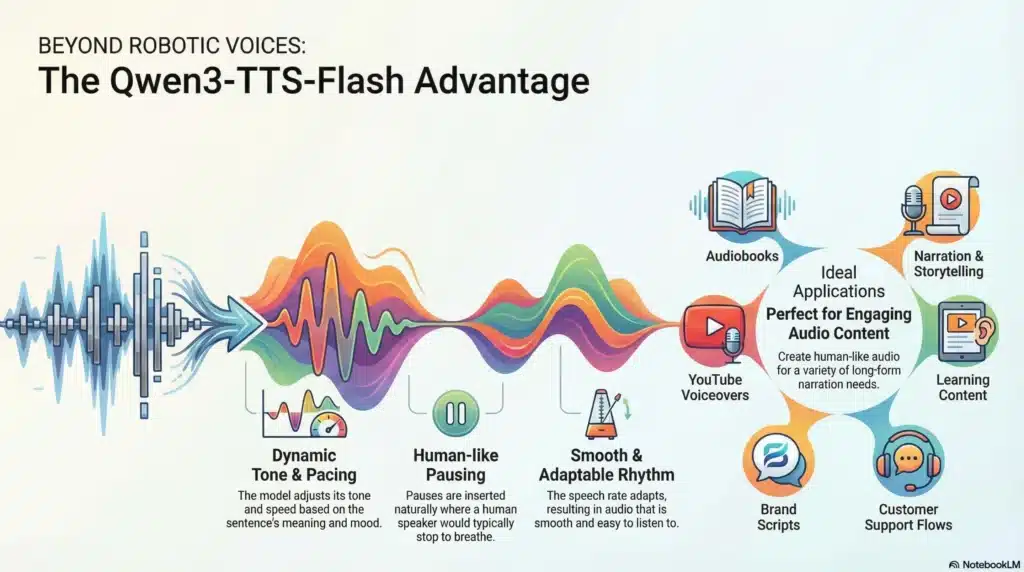
Показателно е, че в същото време компанията поддържа търговски контур: в документацията на Alibaba Cloud Model Studio се препоръчва услугата Qwen3-TTS-Flash с 49 гласа, поддръжка на няколко езика и таксуване по 0,10 долара за 10 000 знака с ограничение за въвеждане на 600 знака на заявка в международен режим. Това е типична двойна стратегия за големите доставчици: отворените „тежести“ тласкат общността към интеграции и разклонения, докато облачният продукт остава удобен вариант под ключ – с готови гласове, SLA и таксуване.
Но демократизацията има и обратна страна. Масовото клониране на гласове увеличава и без това острите рискове от „аудиодипфайкове“: от измамни обаждания до „роднини“ до фалшиви публични изяви и компрометиране на марката. Единствената разлика е, че сега прагът за влизане е още по-нисък: докато преди се изискваха затворени услуги или сложни постройки на изследователските модели, сега е достатъчно да изтеглите няколко гигабайта и да следвате README. И затова настоящата версия може да се разглежда не просто като поредното обновяване на отворен код, а като промяна в мащаба: генерирането на глас излиза от лабораториите и се превръща във всекидневна норма – наравно с текста и снимките.
Казано накратко основното предимство на Qwen3-TTS е способността му да възпроизвежда гласовите характеристики на конкретен потребител въз основа на аудио мостра с продължителност от едва 3 секунди. Според техническите данни, предоставени от разработчиците, моделът успява да улови не само тембъра, но и специфичните интонационни нюанси, които правят човешката реч уникална.
За разлика от предходни поколения алгоритми, които изискваха дълги часове записи за обучение, новата архитектура на Alibaba постига висока степен на автентичност при минимално количество входящи данни.
Очаква се Qwen3-TTS да бъде достъпен чрез облачната платформа на Alibaba за корпоративни клиенти и разработчици, което ще даде тласък на нова вълна от иновации в сферата на персонализираното дигитално съдържание.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
