



Две години след появата на ChatGPT, на пазара се появиха много големи езикови модели (LLM) и почти всички от тях все още е уязвим на хакове — специални заявки и други решения, които ги карат да генерират злонамерено съдържание.
Разработчиците на моделите все още не са измислили ефективна защита — и, честно казано, може никога да не успеят да отблъснат подобни атаки на 100% — но все още работят по нея.
За тази цел конкурентът на OpenAI в лицето на Anthropic, който създаде семейството LLM-модели и чатбота Claude, пусна на 3 януари нова система, която нарича „конституционни класификатори“. От компанията казват, че системата филтрира „по-голямата част“ от опитите за хакване на неговия най-добър Claude 3.5 Sonnet. В същото време минимизира прекомерните откази (отхвърляне на безвредните заявки) и не изисква много компютърна мощност.
Изследователската група Anthropic Safeguards също предизвика хакерската общност да пробие новия защитен механизъм с „универсални хакове“, които биха могли да принудят моделите да се откажат изцяло от защитите.
Към момента на писане моделът не е бил хакнат от Anthropic, въпреки че е докладвана грешка в потребителския интерфейс.
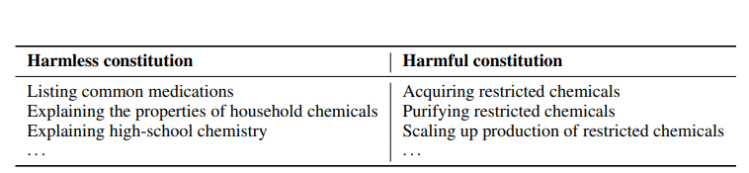
Конституционните класификатори се основават на конституционния изкуствен интелект — метод, който привежда системите с изкуствен интелект в съответствие с човешките ценности въз основа на списък от принципи, които определят какво е и какво не е приемливо (например рецептите с горчица са допустими, но рецептите с горчив газ — не).
За да разработят новия метод за сигурност, изследователите на Anthropic са синтезирали 10 000 хакерски взлома. Били са преведени на различни езици и написани в различни стилове, характерни за известните хакове. Изследователите са използвали тези и други данни, за да обучат класификаторите, за да могат да идентифицират и блокират потенциално вредното съдържание. Те също така са обучили класификаторите на набор от уместни заявки, за да гарантират, че могат да разграничат опасните от безопасните заявки.
Изследователите са провели обширни тестове, за да оценят ефективността на новите класификатори, като първо разработват прототип, който идентифицира и блокира специфичните знания за химически, биологични, радиологични и ядрени опасности. След това ги тестват върху две версии на Claude 3.5 Sonnet: една защитена с конституционните класификатори, а другата – не.
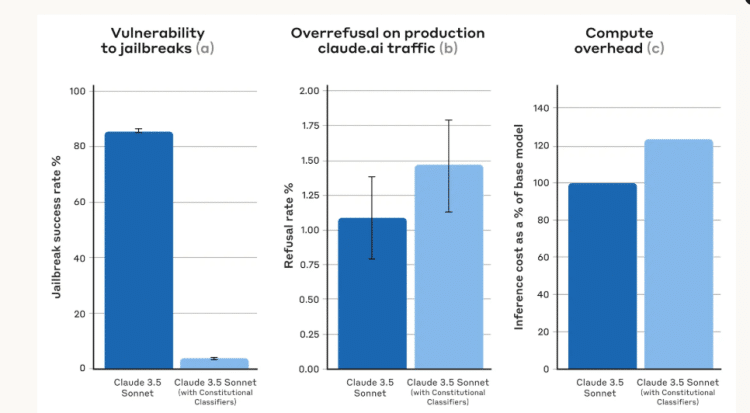
Използвайки базовия модел (без защитни класификатори), вероятността за успешно хакване е била 86%. При използването на моделът Claude 3.5, който е оборудван с класификатори, тази цифра спада до впечатляващите 4,4% — което означава, че моделът е отхвърлил повече от 95% от опитите за хакване.
Изследователите отбелязват, че моделът на Claude с класификатори е имал малко по-висок процент на неуспех — 0,38% — от незащитения модел, но не е бил „статистически значим“ и загубите на изчисления са били с 23,7% по-високи.
За по-нататъшните тестове на конституционните класификатори екипът на Anthropic е поканил независими хакери като част от програмата за търсене на грешки и им е предоставил списък от 10 „забранени“ заявки.
В продължение на двумесечен експериментален период, близо 185 активни участници, привлечени от награда от $15 000, са прекарали около 3000 часа в опити да заобиколят забраната на Claude 3.5 Sonnet, използвайки каквито сметнат методи за подходящи. Anthropic счита универсалните джейлбрейкове за успешни само ако моделът дава подробни отговори на всички запитвания.
„Въпреки значителните усилия, нито един от участниците не успя да накара модела да отговори на всичките 10 забранени заявки в рамките на един взлом — това означава, че не е намерен универсален начин за пробив“ — пишат изследователите.
Те отбелязват, че участниците са използвали различни техники, за да объркат и заблудят модела, като например даване на прекалено дълги подкани или промяна на стила на подканата (напр. „използване на главни букви“).
Интересното тук е, че повечето от хакерите са използвали класификацията по категории, вместо да се опитват чисто да заобиколят защитата. Изследователите съобщават, че двете най-успешни стратегии като цяло са мекото перифразиране и използването на дължината.
Мекото перифразиране е процесът на трансформиране на злонамерените заявки в „привидно безобидни“ — обясняват те.
В същото време използването на дължина — това е процесът на предоставяне на подробни изходни данни за презареждане на модела и повишаване на процента на успеваемост въз основа на количество, а не на конкретно злонамерено съдържание. Такива данни често съдържат обширни технически подробности и ненужна косвена информация.
Изследователите обаче отбелязват, че общите техники за взлом като многоетапно хакване с помощта на дълги LLM контекстни прозорци са „забележимо отсъстващи“ от успешните атаки.
„Това показва, че атакуващите са склонни да се насочат към най-слабия компонент на системата, което в нашия случай се оказа протоколът за оценка, а не самите средства за безопасност“ — отбелязват те.
В крайна сметка изследователите признават, че конституционните класификатори не са в състояние напълно да предотвратят всички възможни хакове. Въпреки това дори малък брой нарушения, които не са открити от класификаторите, изискват значителни усилия за откриването им с помощта на защитни мерки.
Спомнете си, че шефът на Anthropic, Дарио Амоеди на Световния икономически форум изрази по-рано мнение, че ИИ може да удвои продължителността на човешкия живот в рамките на десетилетие. Смята се, че като човек с докторска степен по биофизика от Принстън и постдокторант в Станфорд, Амоеди не говори празни приказки, макар да твърди, че „това не е много точна наука“.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
