



Google представи в списъка за разработка на ядрото на Linux реализация на механизма Device memory TCP (devmem TCP), който позволява директно прехвърляне на данни по мрежата от паметта на някои устройства към паметта на други устройства, без междинно копиране на тези данни в буфери, разположени в системната памет на хоста. Реализацията все още е на етап RFC, т.е. тя е предоставена за обсъждане и преглед от общността, но не е включена в основното Linux ядро.
Очаква се Device Memory TCP значително да повиши ефективността на взаимодействието в клъстерите и разпределените системи за машинно обучение с помощта на допълнителни ускорителни карти. Използването на ускорители за машинно обучение води до значително увеличаване на обема на информацията, прехвърляна по време на обучението на моделите от паметта към паметта на GPU/TPU. В някои случаи обучението на моделите за машинно обучение може да консумира само 50% от наличните изчислителни ресурси на TPU, а един от начините за премахване на престоя и по-пълноценно използване на ресурсите на GPU/TPU е да се увеличи пропускателната способност и ефективността на трансфера на данни.
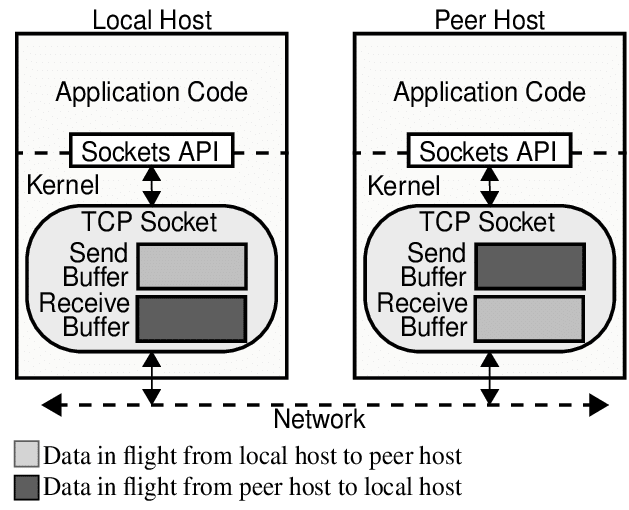
Понастоящем прехвърлянето на данни между устройствата на различните хостове се ограничава до копиране на данни от паметта на устройството в паметта на хоста, прехвърляне на информацията към друг хост по мрежата и копиране от паметта на целевия хост в паметта на друго устройство. Тази схема не е оптимална и при прехвърляне на големи обеми данни допълнително натоварва паметта и пропускателната способност на PCIe шината.
Новата технология Device Memory TCP дава възможност за изключване на паметта на хоста от тази верига и директното прехвърляне на данни по мрежата от паметта на устройството и разполагането на данните, получени във вид на мрежови пакети, в паметта на устройството. За работата на Device Memory TCP е необходима мрежова карта, способна да обработва поотделно заглавията на пакетите и капсулираните данни (полезния товар) на мрежовите пакети в различните буфери. Данните се зареждат от паметта на устройството в буфера за полезен товар на мрежовата карта, като се използва механизмът dmabuf, докато заглавията се прехвърлят от основната памет и се запълват със системния TCP/IP стек. За да се повиши ефективността, може допълнително да се използва способността на мрежовата карта да обработва поотделно потоците в различните опашки.
Необходимостта от високопроизводителен механизъм за комуникация между устройствата се увеличава при разпределените приложения за машинно обучение, където ускорителите са на различни хостове и където данните за обучение на моделите се прехвърлят от външни SSD дискове. Тестовете за производителност, проведени в конфигурация с 4 графични процесора и 4 мрежови кеша, показаха, че Device Memory TCP постига 96,6% от наличната линейна скорост при прехвърляне на данни директно между паметта на устройствата
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
