



Meta съобщи за резултатите от най-новите изследвания в областта на изкуствения интелект в рамките на проектите FAIR (Fundamental AI Research). Специалистите на компанията са разработили AI-модел, който отговаря за правдоподобните движения на виртуални герои; модел, който оперира не с токени — езикови единици – а с понятия; и много повече.
Моделът Meta Motivo контролира движенията на виртуални хуманоидни герои при изпълнение на сложни задачи. Обучена е с подкрепа на масив от данни за движенията на човешкото тяло — тази система може да се използва като спомагателна при проектирането на движенията и позициите на тялото на героите. „Meta Motivo може да решава широк набор от задачи за контрол на цялото тяло, включително и проследяване на движение, приемане на целева поза <..> без никакво допълнително обучение или планиране“ — казва компанията.
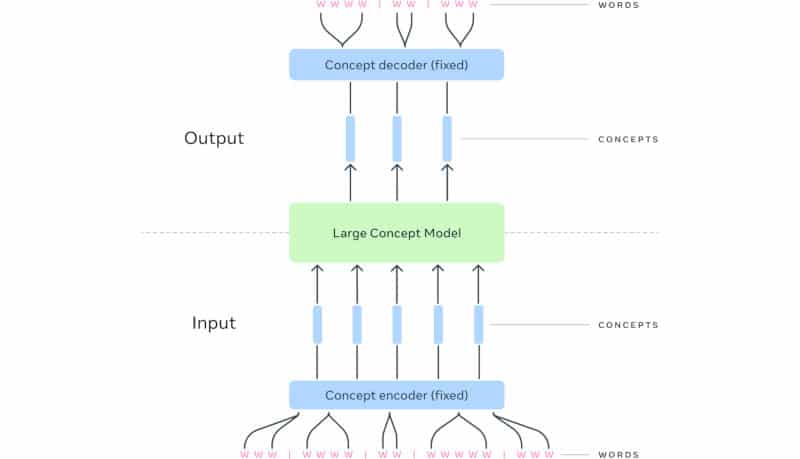
Важно постижение беше създаването на голям концептуален модел (Large Concept Model или LCM) – алтернатива на традиционните големи езикови модели. Изследователите на Meta са забелязали, че днешните усъвършенствани AI системи работят на ниво токени — езикови единици, които обикновено представляват фрагмент от дума, но не показват изрично йерархично разсъждение. В LCM механизмът на разсъждение е отделен от езиковото представяне — по подобен начин човек първо формира последователност от понятия, а след това я поставя във вербална форма. Така, когато провежда поредица от презентации по една тема, говорителят вече има формирана поредица от концепции, но формулировката в речта може да се променя от едно събитие на друго.
Когато генерира отговор на запитване, LCM предвижда последователност не от токени, а от концепции, представени от пълни изречения в мултимодално и многоезично пространство. Тъй като контекстът на входа се увеличава, LCM архитектурата, според разработчиците, изглежда по-ефективна на изчислително ниво. На практика тази работа ще помогне за подобряване на производителността на езиковите модели с всякаква модалност, тоест формат на данни или при извеждане на отговори на всеки език.
Механизмът Meta Dynamic Byte Latent Transformer също предлага алтернатива на езиковите токени, но не като ги разширява в концепции, а напротив, чрез формиране на йерархичен модел на ниво байт. Това, според разработчиците, повишава ефективността при работата с дълги последователности при обучение и пускане на модели. Спомагателният инструмент Meta Explore Theory-of-Mind е предназначен за възпитаване на умения за социална интелигентност в AI-моделите при тяхното обучение, за оценка на ефективността на моделите при тези задачи и за фина настройка на вече обучените AI-системи. Meta Explore Theory-of-Mind не се ограничава до даден набор от взаимодействия, а генерира свои собствени сценарии.
Технологията Meta Memory Layers at Scale има за цел да оптимизира действителните механизми на паметта на големите езикови модели. Тъй като броят на параметрите в моделите се увеличава, работата с действителната памет изисква все повече и повече ресурси и новият механизъм е насочен към спестяването им. Проектът Meta Image Diversity Modeling, който се изпълнява с участието на експерти от трети страни, има за цел да повиши приоритета на генерираните от AI изображения, които по-точно съответстват на обектите от реалния свят; също така допринася за повишаване на безопасността и отговорността на разработчиците при създаване на изображения с помощта на AI.
Моделът Meta CLIP 1.2 е нова версия на системата, предназначена да установи връзка между текст и визуални данни. Използва се и за обучение на други AI-модели. Инструментът Meta Video Seal е предназначен за създаване на водни знаци върху генерираните от изкуствен интелект видеоклипове — тази маркировка е невидима с просто око при гледане на видеоклипа, но може да бъде открита, за да се определи произходът на видеоклипа. Водният знак се запазва чрез редактиране, включително замъгляване и кодиране с помощта на различни алгоритми за компресиране. И накрая, Meta припомни парадигмата Flow Matching, която може да се използва за генериране на изображения, видео, звук и дори триизмерни структури, включително и протеинови молекули — това решение помага при използване на информацията за движението между различните части на изображението и действа като алтернатива на механизма за дифузия.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
