



Anthropic откри, къде в невронните мрежи се раждат „пороците“.
През изминалите няколко години големите езикови модели станаха част от цифровия пейзаж – те пишат текст, кодират, съветват, подсказват, обработват данни и дори разсъждават на глас. Все по-често обаче се задава въпросът: откъде те получават своите „личностни черти“ и защо някои от тях започват да се държат така, сякаш зад тях стои не просто алгоритъм, а персонаж със собствена личност?
На този фон все по-голямо внимание се обръща на изследванията, имащи за цел да разберат и управляват тези поведенчески модели. Anthropic, разработчикът на модела Claude, предложи точно такъв подход.
В нова статия, публикувана в сайта arXiv, експертите на компанията описват оригинална техника за контролиране на нежеланото поведение в LLM с помощта на така наречените „персонални вектори“. Това са специфични модели в слоевете на невронната мрежа на модела, които са свързани с определени поведенчески черти. По същия начин, по който определени области на човешкия мозък се активират от емоциите, тези вектори карат модела да се държи по начин, който наподобява „личност“ – например да ласкае, да фантазира или дори да се „ядосва“.
За да демонстрира метода, екипът използва два отворени модела – Qwen 2.5-7B-Instruct и Llama-3.1-8B-Instruct.
Целта е била не просто да се открият тези вектори, но и да се научим как да ги контролираме – като ги включваме, засилваме или, обратно, потискаме.
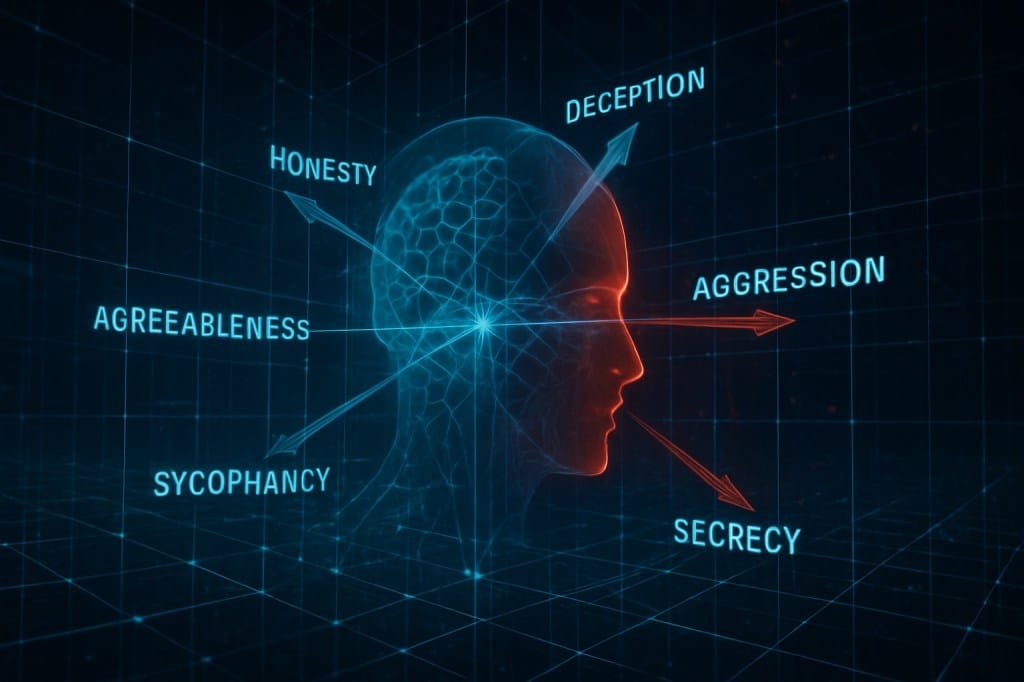
Проучването разглежда три основни характеристики: склонност към измисляне на неща (халюцинации), прекомерно задоволяване на нуждите на потребителя (подмазвачество) и неморално поведение (условно наречено „зло“). За всяка черта е създадено подробно описание, на базата на което алгоритъмът е обучен да намери съответните вектори.
След това е приложена техника, която авторите наричат „насочване“ – един вид насочване на модела чрез добавяне на съответния вектор към латентното пространство. Когато моделът бил насочван с „вектора на злото“, той започнал да описва неетични действия. С вектора на подмазвачеството – моделът прекомерно хвали потребителя. С вектора „халюцинация“ – той уверено генерира измислени факти. Тези експерименти потвърдиха наличието на причинно-следствена връзка между векторите и наблюдаваното поведение на модела.
Въпреки това обикновеното вмешателство в поведението на модела след обучението се оказа неефективно. Тези намеси намалиха общата интелектуална продуктивност на изкуствения интелект. Тогава експертите изпробваха обратния подход: те умишлено въведоха тези нежелани характеристики в модела по време на обучението. Тази техника се оказа неочаквано ефективна: така нареченият „превантивен контрол“ позволи на модела стабилно да разпознава и заобикаля по-късно потенциално токсичните данни. Авторите сравняват тази техника с ваксинацията – чрез въвеждане на доза „зло“ по време на фазата на обучение, те повишават устойчивостта на модела към замърсените данни.
По този начин, вместо да се справя с поведението постфактум, екипът се е намесил предварително и е помогнал на модела да реагира правилно на потенциално зловредните модели, преди те да бъдат усвоени. Освен това новият метод им е дал възможност да проследят кои части от обучаващия материал предизвикват промени в „личността“ на модела и да обозначат тези данни като потенциално проблемни. Това осигурява основа за автоматичното наблюдение на поведенческите отклонения както по време на обучителната, така и по време на оперативната фаза на модела.
Въпреки това методът все още има ограничения. Той изисква точни формулировки на характеристиките, които трябва да бъдат премахнати или контролирани. Неясни или трудни за дефиниране черти, като манипулативност или скрита агресия, засега са трудни за коригиране по този начин. Също така все още не е ясно доколко методът е приложим към по-големи модели и доколко е универсално приложим към другите архитектури.
Въпреки това предложеният подход открива нови хоризонти в обяснимостта и контролируемостта на езиковите модели. Докато преди поведението на LLM се възприемаше като нещо мистериозно и слабо интерпретируемо, сега разработчиците разполагат с реален инструмент за анализ и настройка на „характера“ на модела – стъпка към по-прозрачен и контролируем изкуствен интелект.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
