


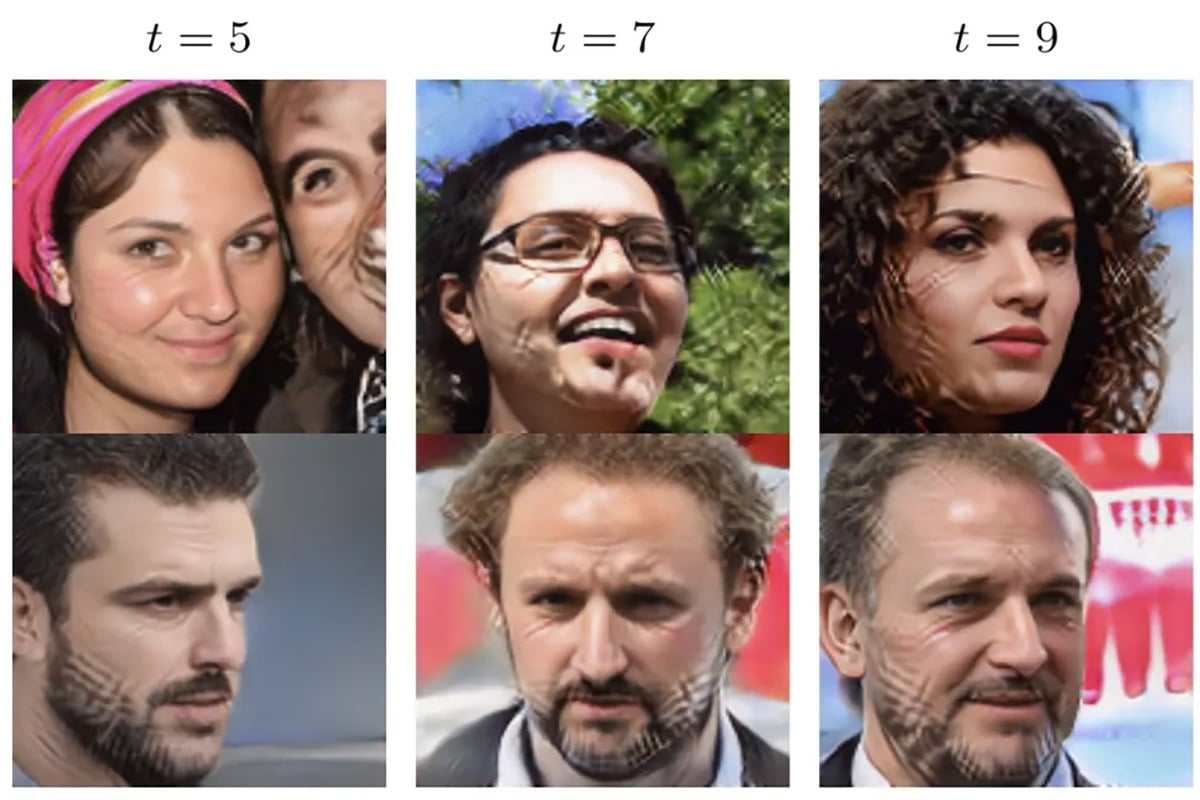

Изследователи от Станфордския университет откриха тавана на възможностите на генеративните модели на изкуствен интелект, като ChatGPT и Midjourney. Оказва се, че те деградират при многократно обучение по данни, генерирани от самия изкуствен интелект.
В хода на проучването учените извеждат съкращението MAD (Model Autophagy Disorder). Както подсказва името, моделът „изяжда себе си“. Изкуственият интелект губи информация за „опашките“ (крайните точки) на първоначалното разпределение на данните и започва да извежда резултати, които повече съответстват на средното представяне. Според получените резултати необходими са около пет итерации, докато „опашките“ на първоначалното разпределение изчезнат напълно. Изображението по-горе показва визуалния резултат от подобни експерименти.

Това означава, че не е възможно да се получат неограничен брой генеративни данни чрез еднократно обучение на модела и след това той да се базира на собствените си резултати. Друг важен момент е проблемът за произхода на данните: сега става още по-важно да може да се отделят „оригиналните“ данни от „изкуствените“. Ако е невъзможно да се определи коя и каква информация е създадена от невронната мрежа, съществува риск тя да бъде случайно включена в данните за обучение на новия продукт.
Но може би вече е твърде късно. Съществува огромно количество немаркирани данни, които вече са създадени от тези видове мрежи и са включени в други системи.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
