


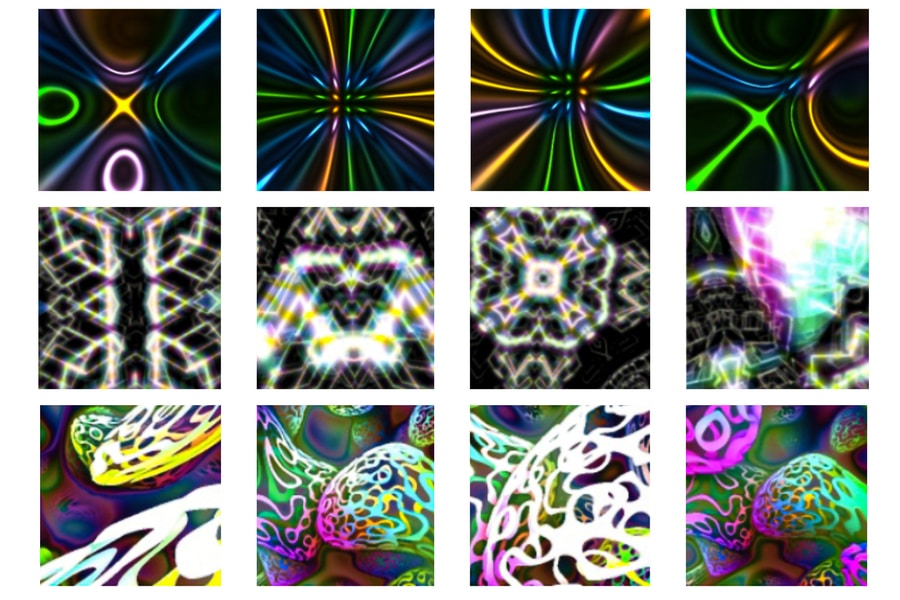

Ново изследване разкрива мащабируема техника, която използва синтетични данни за подобряване на точността на AI моделите, които разпознават изображения.
Преди модел с машинно обучение да може да изпълни задача, като например идентифициране на рак в медицински изображения, моделът трябва да бъде обучен. Обикновено включва показване на модела на милиони примерни изображения, събрани в масивен набор от данни.
Въпреки това, използването на реални данни от изображения може да породи практически и етични опасения: Изображенията могат да противоречат на законите за авторското право, да нарушават личния живот на хората или да бъдат предубедени към определена расова или етническа група. За да се избегнат тези капани, изследователите могат да използват програми за генериране на изображения, за да създадат синтетични данни за обучение на модели. Но тези техники са ограничени, защото често са необходими експертни познания за ръчно проектиране на програма за генериране на изображения, която може да ги създаде ефективни.
Изследователи от MIT, MIT-IBM Watson AI Lab и други, предприеха различен подход. Вместо да проектират персонализирани програми за генериране на изображения за конкретна задача за обучение, те събраха набор от данни от 21 000 публично достъпни програми от интернет. След това използваха тази голяма колекция, за да обучат модел на компютърно зрение.
Тези програми произвеждат различни изображения, които показват прости цветове и текстури. Изследователите не са ги подготвяли или променяли. Всяка от тях се състои само от няколко реда код.
Моделите, които те обучиха с този голям набор от данни от програми, класифицираха изображения по-точно от други синтетично обучени такива. И макар техните модели да са по-слаби от тези, обучени с реални данни, изследователите показаха, че увеличаването на броя на програмите за изображения в набора от данни също повишава производителността на модела, разкривайки път към постигане на по-висока точност.
„Оказва се, че използването на много програми, които не са подготвени, всъщност е по-добро от използването на малък набор от изображения, които хората трябва да манипулират. Данните са важни, но ние показахме, че може да се стигне доста далеч и без реални такива“,
казва Манел Барадад студент по електроинженерство и компютърни науки (EECS), работещ в Лабораторията по компютърни науки и изкуствен интелект (CSAIL, Computer Science and Artificial Intelligence Laboratory) и водещ автор на документът, описващ тази техника .
Съавторите включват Тонжу Уанг, студент от EECS в CSAIL; Роджерио Ферис, главен учен и мениджър в MIT-IBM Watson AI Lab; Антонио Торалба, професор по електротехника и компютърни науки на Delta Electronics и член на CSAIL; и старши автор Филип Изола, доцент по EECS и CSAIL; също и с други от JPMorgan Chase Bank и Xyla, Inc.
Изследването ще бъде представено на Конференцията за системи за обработка на невронна информация.
Преосмисляне на предварителната подготовка
Моделите за машинно обучение обикновено са предварително обучени, което означава, че първо се обучават на един набор от данни, за да им помогнат да изградят параметри.
Един модел за класифициране на рентгенови лъчи може да бъде предварително обучен с помощта на огромен набор от данни от синтетично генерирани изображения, преди да бъде обучен за действителната си задача с помощта на много по-малък набор от данни от реални рентгенови лъчи.
Тези изследователи по-рано показаха, че могат да използват шепа програми за генериране на изображения, за да създадат синтетични данни за предварително обучение на модел, но програмите трябваше да бъдат внимателно проектирани, така че синтетичните изображения да съвпадат с определени свойства на реалните такива. Това направи техниката трудна за мащабиране.
Вместо това, в новата работа те използваха огромен набор от данни за генериране на изображения.
Те започнаха със събиране на колекция от 21 000 програми за генериране на изображения от интернет. Всички те са написани на прост език за програмиране и се състоят само от няколко фрагмента код, за да генерират изображения бързо.
„Тези програми са проектирани от разработчици от цял свят, за да произвеждат данни, които имат някои от свойствата, които ни интересуват. Те създават изображения, които изглеждат като абстрактно изкуство“
обяснява Барадад.
Тези прости програми могат да работят толкова бързо, че изследователите не е необходимо да създават изображения предварително, за да обучат модела. Те откриха, че могат да генерират и да обучават модела едновременно, което рационализира процеса.
Използваха своя огромен набор от данни от програми за генериране на изображения, за да обучат предварително модели на компютърно зрение както за контролирани, така и за неконтролирани задачи за класифициране на изображения. При контролирано обучение, данните за изображението са етикетирани, докато при неконтролирано, моделът се научава да категоризира изображения без етикети.
Подобряване на точността
Когато сравняват своите предварително обучени модели с най-съвременните модели за компютърно зрение, които са били предварително обучени с помощта на синтетични данни, техните модели са по-точни. Това означава, че поставят изображенията в правилните категории по-често. Докато нивата на точност бяха все още по-ниски от моделите, обучени на реални данни, тяхната техника намали разликата в производителността между моделите, обучени на реални данни, и тези, обучени на синтетични данни с 38 %.
„Важно е, че показваме, че за броя на програмите, които събираме, производителността се мащабира логаритмично. Ние не насищаме производителността, така че ако съберем повече програми, моделът ще се представи още по-добре. Така че, има начин още да разширим подхода си“
казва Манел.
Изследователите също така са използвали всяка отделна програма за генериране на изображения за предварително обучение, в опит да разкрият фактори, които допринасят за точността на модела. Те откриха, че когато една програма генерира по-разнообразен набор от тях, моделът се представя по-добре. Също така и, че цветните изображения със сцени, които изпълват цялото платно, са склонни да подобряват представянето на модела най-много.
Сега, след като демонстрираха успеха на този подход за предварително обучение, изследователите искат да разширят техниката си към други типове данни, като мултимодални, които включват текст и изображения. Искат и да продължат да проучват начини за подобряване на производителността на класификацията на изображенията.
„Все още има празнина, която трябва да се запълни с модели, обучени от реални данни. Това дава на нашите изследвания посока, която се надяваме и други да следват“
казва той.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
