



Миналата есен се появиха призиви за „забрана на отворения код“ в отговор на решението на Meta и други компании да отворят кода на големите езикови модели (LLM). Лобистите активно използваха тази фраза по време на политическите митинги и в политическите кръгове. Много от критиците обаче не можеха да обяснят какво е отворен код и не бяха запознати с определението за отворен код. Непознаването на техническите детайли не им попречи да изразяват отрицателни мнения.
Този спор не се отнася до софтуера с отворен код, а до откриването кода на изкуствения интелект, където отвореният код се използва като общ термин за всякакъв вид откритост в областта на изкуствения интелект.
Вниманието към проблема продължава да расте
Макар да е трудно да приемем, че тази тема се обсъжда в сериозните среди, една статия в San Francisco Examiner потвърждава, че войната срещу отворения код е реална и продължава.
The Examiner обяснява, че отвореният код отдавна се ползва с подкрепата на Силициевата долина, като не става дума за изкуствения интелект, а за софтуера с отворен код, който е в основата на бизнес иновациите.
Шокиращо може да се окаже изказването на рисковия капиталист Винод Косла, който нарече отворения код „заплаха за националната сигурност„. Examiner цитира контрааргумент на Марк Андрисен, който смята, че ограничаването на достъпа до ИИ с отворен код ще доведе до доминиране на големите компании и ще подкопае академичните изследвания.
Open Washing
Ключов проблем е объркването между понятията „отворен код“ и „отворен код в областта на ИИ“.
Софтуерът с отворен код е споделен и лицензиран в съответствие с определението OSD, което съществува от повече от 25 години и се поддържа от Инициативата за отворен код (OSI, Open Source Initiative). Концепцията за „отворен код“ обаче, що се отнася до ИИ, не е ясно дефинирана и се използва от някои медии, лобисти и законодатели като общ термин за всякакъв вид отвореност в ИИ.
Това погрешно тълкуване на термина „отворен код“ доведе до статии в издания като New York Times, в които се обясняват рисковете от „отвореното измиване“ в ИИ. „Изпирането на отворения код“ означава, че софтуер, който не е съвместим с отворения код, погрешно се обозначава като такъв, за да се получат предимства като бързо приемане и възможност да се превърне във фактически стандарт, като същевременно не се предоставят всички предимства на отворения код.
Софтуерът с отворен код, съгласно определенията за отворен код 5 и 6, предоставя на потребителите широк спектър от възможности за приложение и разпространение. Всеки може да използва такъв софтуер за всякакви цели, стига той да остане свободно разпространяван.
Важно е обаче да се разбере, че лицензите за софтуер с отворен код, както и всички останали лицензи, не са над закона. Въпреки принципите на свободното разпространение, софтуерът с отворен код е обект на приложимите закони, включително разпоредбите за контрол на износа.
Следователно свободата на използване на софтуер с отворен код не е абсолютна и е ограничена от правната рамка. Потребителите и разработчиците трябва да вземат предвид както лицензионните условия, така и приложимите правни изисквания, когато работят със софтуера с отворен код.
Законодателите са отговорни за вземането на решения по етични и други въпроси, но не и за лицензирането на софтуера с отворен код.
„Open Washing“ означава, че лицензът, приложен към софтуера, не е в съответствие с OSD, което обикновено включва ограничение за свободното разпространение. Лицензът не може да бъде одобрен, тъй като не отговаря на изискванията на OSD. Класически погледнато, тези лицензи са били ограничени от търговска гледна точка, като например софтуер, който не може да се използва за цели, различни от търговските.
Монетизирането на софтуера с отворен код е предизвикателство поради свободното му разпространение, което прави невъзможно ограничаването на конкуренцията. Отвореният код всъщност означава, че споделяте иновациите си с вашите конкуренти. При „отвореното изпиране“ разпространителят може да запази известно ниво на контрол, като фалшиво твърди, че неговият софтуер е с отворен код.
Терминът „отворен код“ не е регистриран като търговска марка, така че е трудно да се контролира използването му. Този факт често се пренебрегва, но той е съществен и служи за урок на всички.
Откритостта в ИИ
Examiner описва, че системите с изкуствен интелект се състоят от много компоненти, които обикновено включват архитектурата на модела – основния алгоритъм, който определя какво прави системата с входните данни и какво научава; тежестите на модела – променливите, които определят как входните данни се превръщат в изходни, като например илюстрации или есета; софтуерния код, използван за обучение на модела или за неговото стартиране след обучението; и данните за обучение.
С други думи, изкуственият интелект, в този контекст генеративният ИИ и LLM, се състои от нещо повече от софтуер, независимо дали е с отворен код или не. Компонентите на ИИ могат да бъдат отделени и всеки от тях може да бъде отворен, затворен или да се намира между тези състояния. Когато даден компонент е отворен, тази отвореност може да бъде пълна – със свободно разпространение и добри практики, свързани със софтуера с отворен код. Но може да бъде ограничена или напълно затворена.
Meta нарича своя модел Llama 2 „отворена иновация“, но Марк Зукърбърг твърди, че той е с отворен код, което може да е пример за „отворено изпиране“.
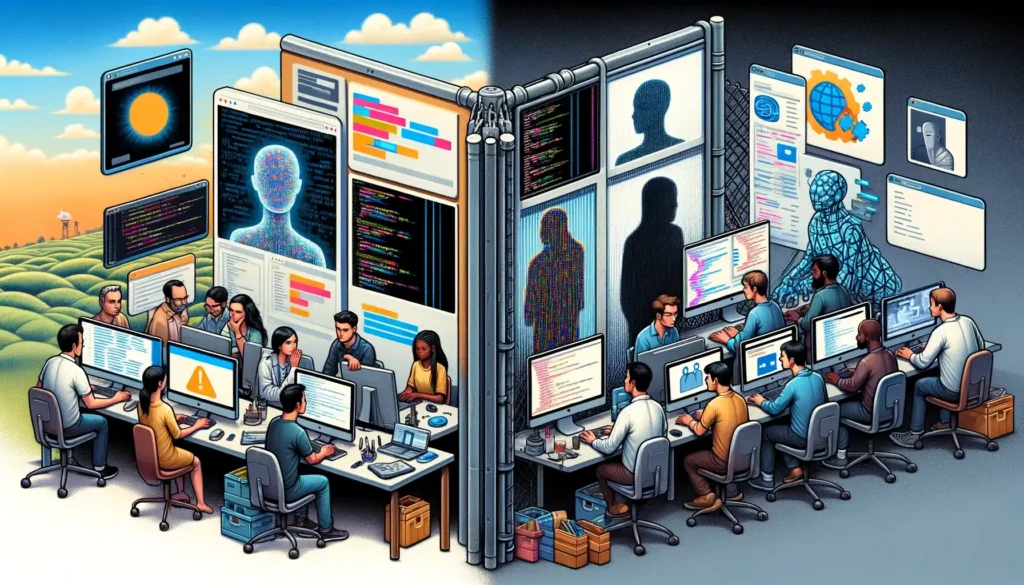
През декември миналата година в доклад на Станфордската HAI се посочва, че системите за изкуствен интелект се различават по степента си на отвореност, а през февруари Комитетът по комуникациите към Камарата на лордовете на Обединеното кралство отбеляза в доклада си относно разследването на LLM, че използването на термина „модел с отворен код“ остава спорно. Установени са и степените между напълно отворените и напълно затворените модели.
През юни Центърът за езикови изследвания към университета „Радбуд“ в Неймеген, Нидерландия, определи 14 „измерения“ като критерии за оценка на степента на отвореност.
Важността на този анализ и оценка е двояка:
Първо, необходимо е да се разберат компонентите и нивата на отвореност, за да се определят рисковете и ползите от всеки отворен компонент.
На второ място, в него се изразява основателна загриженост относно преждевременното приемане на първото в света законодателство в областта на изкуствения интелект – Закона за изкуствения интелект на Европейския съюз. В него се използва терминът „отворен код“, за да се предложи специален статут със специално изключение за ИИ, който отговаря на критериите за отворен код.
Този подход за декомпозиране и оценка на компонентите на ИИ е важен за управлението на оценката на рисковете, ползите и отговорностите, свързани с ИИ.
Моделът за отворен код на Linux Foundation има за цел да премахне неяснотите и да създаде прозрачност чрез изясняване на наличността на компонентите на ИИ, лицензирането и пригодността им за търговска употреба. Днес това се подкрепя от инструмента за оценка IsItOpen . Инструментите с отворен код, като например платформата за оценка Inspect на британския Институт за сигурност на ИИ, към която се присъединиха няколко държави и 16 ключови доставчици на ИИ, дават възможност за оценка на съответствието без регулиране.
Създаване на определение за „отворен ИИ“
Концепцията за „ИИ с отворен сорс код“ се разработва съвместно с Инициативата за отворен код (OSI, Open Source Initiative). Очаква се това определение да обхваща всички компоненти на една ИИ система, включително данните. Този подход би могъл да се превърне в еталон за напълно отворен ИИ, представляващ противоположност на напълно затворените системи.
Между тези крайности има спектър от междинни варианти, които формират своеобразна плъзгаща се скала на отвореност на системите за ИИ. Това отразява разнообразието от подходи към разработването и разпространението на ИИ технологиите.
Трябва да се има предвид обаче, че всяко определение в областта на ИИ може бързо да остарее поради бързото развитие на технологиите. Подобно на Закона за ИИ, определението за „ИИ с отворен код“ може да има ограничен период на приложимост.
Независимо от това е от решаващо значение определението да бъде в съответствие с принципите на OSD. Това ще осигури съответствие с основните идеи на софтуера с отворен код и ще спомогне за запазване на целостта на концепцията за отворен ИИ в условията на бързо променяща се технологична среда.
Въздействието върху софтуера с отворен код
През последните няколко години регулаторните органи активно търсят начини за разпределяне на отговорностите и оценка на рисковете в сектора на информационните технологии. Особено внимание се обръща на сигурността на софтуера с отворен код. Тази загриженост е отразена в инициативите на Белия дом в САЩ и в приетия през последните няколко години Закон за кибер устойчивост на Европейския съюз.
Процесът на създаване, разпространение и комерсиализиране на софтуер с отворен код обаче има много нюанси, които често остават неясни за законодателите и регулаторните органи. Тази сложност води до трудности при опитите да се преведат принципите на отворения код в регулаторни рамки.
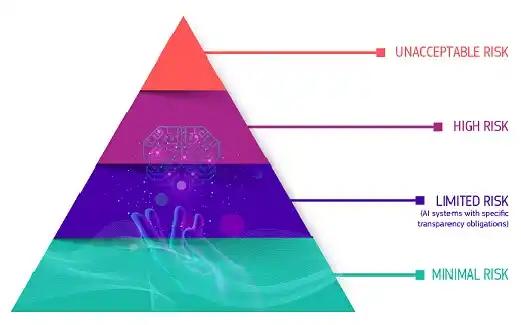
Липсата на задълбочено разбиране на спецификата на софтуера с отворен код може да доведе до неефективни или дори вредни регулаторни мерки. Това крие риск от ограничаване на иновациите и забавяне на развитието на технологиите, основани на принципите на отворения код.
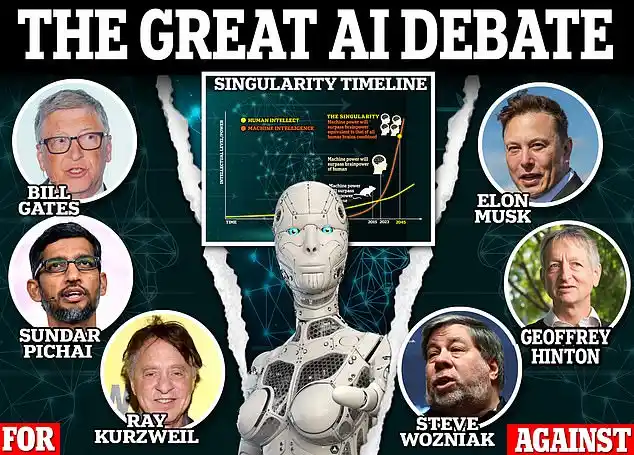
Отвореният код вече е подложен на изпитания и разговорите за „забрана на отворения код“ в областта на изкуствения интелект пораждат основателни опасения.
Дебатът около изкуствения интелект крие значителни рискове за бъдещето на софтуера с отворен код. Неотдавнашният безпрецедентно бърз ръст на популярността на ИИ доведе до масово приемане на софтуера с отворен код, което от една страна показва неговото приемане, но от друга страна създава проблеми поради липсата на компетентност от страна на много нови потребители при управлението на такива системи.
Софтуерът с отворен код със сигурност спечели важна победа в разработването на софтуер. Остава обаче въпросът: дали тази победа ще бъде дългосрочно постижение в борбата за демократизиране на технологиите, или ще се окаже само временен успех?
В светлината на тези предизвикателства защитниците на софтуера с отворен код трябва да заемат активна позиция. Тяхната задача е да защитават принципите на софтуера с отворен код в контекста на развитието на изкуствения интелект, като предотвратяват възможните отрицателни последици от това влияние. Това включва работа за запазване на отвореността, прозрачността и достъпността на технологиите в ерата на изкуствения интелект.
Изключително важно е да се намери баланс между иновациите в областта на изкуствения интелект и запазването на основните ценности на движението за отворен код. Това ще изисква тясно сътрудничество между разработчиците, потребителите, регулаторните органи и експертите по ИИ за разработване на стратегии, които ще гарантират, че технологиите за ИИ се развиват, без да се нарушават принципите на отворения код.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
