



Ако се използва невронна мрежа като „голям речник на символи“ за някой архиватор, можете да разработите архиватор с рекордно съотношение на компресията. Например в световния бенчмарк Large Text Compression Benchmark (LTCB) сега лидер е компресиращата програма NNCP, в която Фабрис Белард е приложил приблизително следната идея:
| Резултатите от LTCB за текстовия корпус enwik9 (първите 1 000 000 000 байта текст на английски език в Уикипедия – enwiki-20060303-pages-articles.xml, 4,7 GB), юни 2026 г. | ||||
| Програма | Резултат (байтове) | Коефициент на компресията | Размер на декодера (zip, байтове) | Всичко (байтове) |
|---|---|---|---|---|
| gzip 1.3.5 | 322 591 995 | 3,10 : 1 | 38 801 | 322 630 796 |
| xz 5.2.1 | 197 331 816 | 5,07 : 1 | 36 752 | 197 368 568 |
| CMIX (v21) | 107 693 380 | 9,24 : 1 | 223 485 | 108 244 767 |
| NNCP 3.2 | 106 632 363 | 9,32 : 1 | 628 955 | 107 261 318 |
Токенизацията на текста
Както можем да видим, с помощта на невронната мрежа текстовете в Уикипедия се компресират в съотношение 9:1. Ние просто преобразуваме текста в токени с помощта на токенизатор с отворен код. Например OpenAI от много години използва същия токенизатор tiktoken, който се инсталира чрез PyPi:
pip install tiktokenТози токенизатор използва алгоритъма за кодиране на двойки байтове BPE, първоначално създаден през 1994 г. специално за компресиране на данни.
BPE заменя най-често срещаната двойка байтове с нов байт, който не се съдържа в оригиналния набор от данни:
- ABABCABCD ––Входеният низ от данни
- XXCXCD–––-Двойката AB се заменя с неизползваната X
- XYYD––––Двойката XC се заменя с неизползвана двойка Y.
Запазва се таблица за заместване, за да се възстанови оригиналният набор от данни. Токените съответстват на различните части от изходния текст: от единични символи (включително единични цифри или препинателни знаци) до цели думи (дори дълги сложни думи):
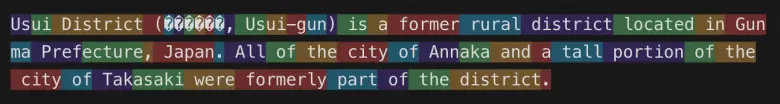
Токенизаторът SentencePiece на Google също се основава на алгоритъма BPE.
Превръщането на текста в токени е обратим процес, така че получените токени винаги могат да бъдат превърнати обратно в оригинален текст. А компресията е без загуби, т.е. това е класически кодек без загуби.
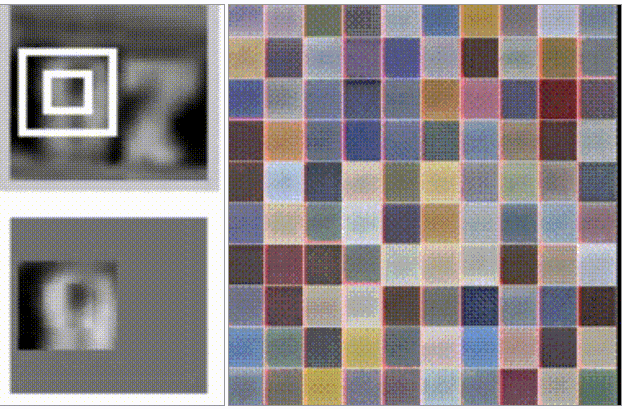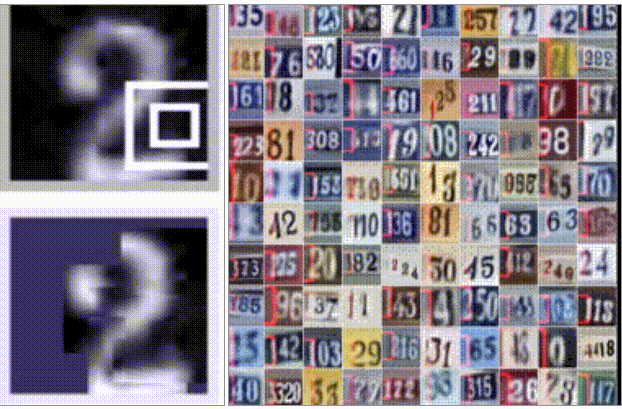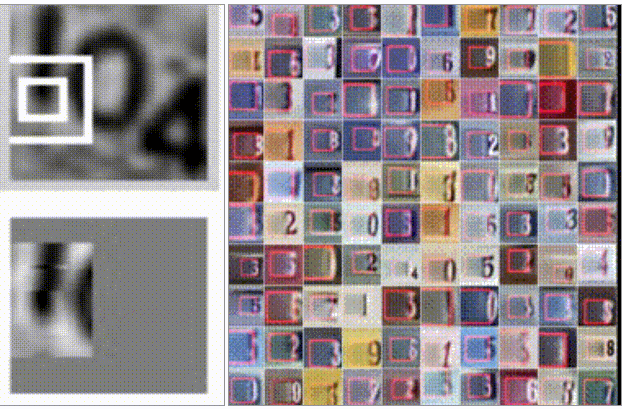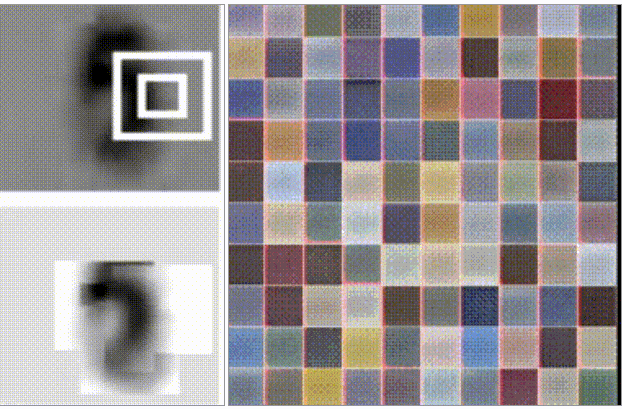
Многослойните невронни мрежи RNN са изключително ефективни в прогнозирането на следващата дума, а не само на думите. След обучението невронната мрежа научава основните характеристики на всякакъв вид данни и е в състояние сама да синтезира или реконструира тези данни въз основа на оскъдна информация:
Прогнозиране на аудио семпли
Въпросът е: възможно ли е този подход да се възпроизведе при компресирането на аудио? Т.е. да се разработи аудиокодек, базиран на трансформър, който надеждно да прогнозира не следващата дума, а следващата аудио извадка/семпъл?
През 2016 г. DeepMind публикува генеративния звуков модел WaveNet, който доста реалистично синтезира човешката реч в режим на преобразуване на текста в реч, въпреки че в „творчески“ режим на свободен текст той явно се запъва при избора на думите.
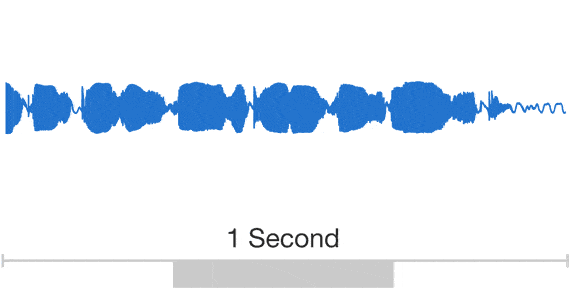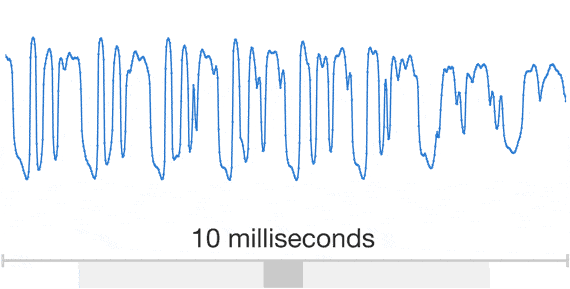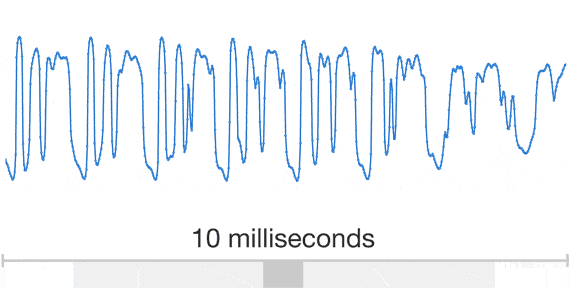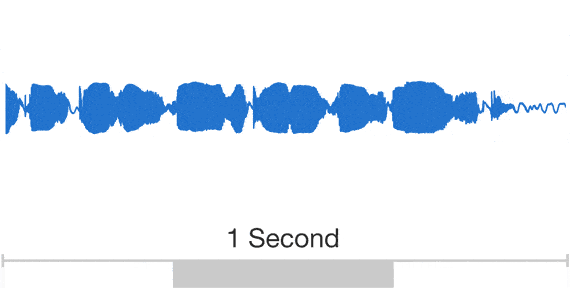
Оттогава технологията значително се е усъвършенствала и сега синтезираната реч в Gemini Neuron, ChatGPT Advanced Voice Mode, Qwen и Moshi е почти неразличима от истинската реч.
Невронният аудиокодек Mimi
През юли 2024 г. френската компания Kyutai публикува речевия модел Moshi. Това беше първият в света гласов изкуствен интелект с отворен код от край до край, способен на диалог в реално време и безплатен за използване от всеки.
Моделът може да мисли и да говори едновременно, като синтезира свободен поток от думи по всяка тема, разпознава речта и генерира отговори. Демонстрацията работи във всички браузъри, като разговорите са ограничени до 5 мин.
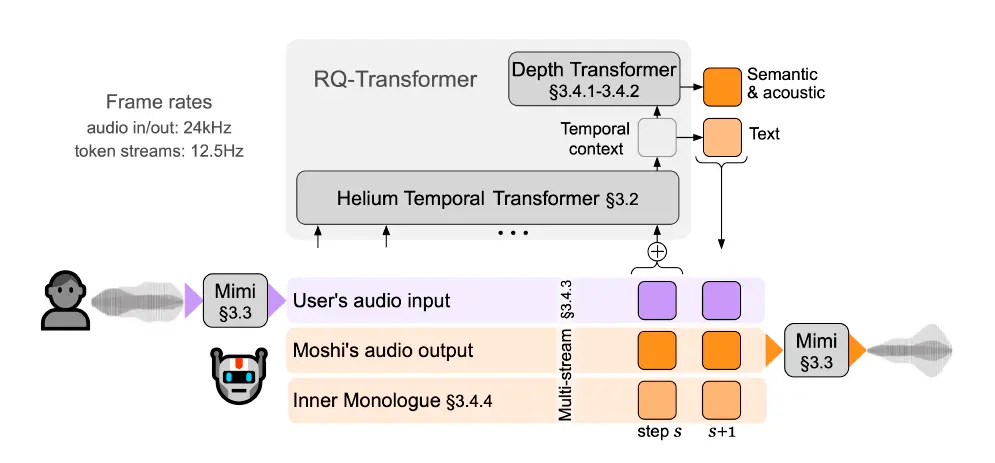
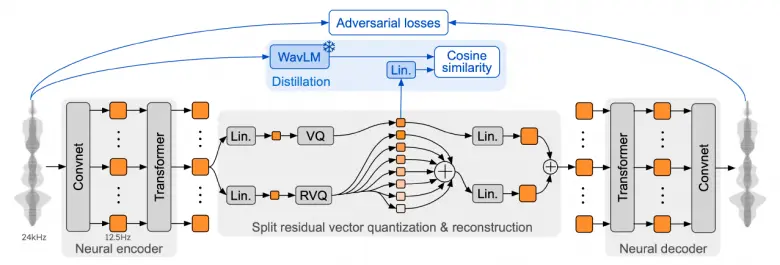
Един от основните компоненти на модела е невронният аудиокодек Mimi с квантуване на остатъчните вектори и семантичните знания, извлечени от самонастройващ се модел на речта.
Аудио токенизацията
та Аудиокодекът всъщност извършва аудио токенизация по приблизително същия начин, по който гореспоменатият алгоритъм BPE обработва текста. Процесът на семплиране на звуковите вълни в аудио токенизацията е описан по-подробно в научните статии „SoundStream: end-to-end neural audio codec“ (Zeghidour et al., 2021) и „Compressing high quality audio using neural networks“ (D´efossez et al., 2023, arXiv:2210.13438v1). Mimi работи като автоенкодер.
В научната литература тези токени се наричат акустични токени, тъй като моделират фините характеристики на звука и са оптимизирани за висококачествено възстановяване на звука. Въпреки че акустичните токени са подходящи за моделите за преобразуване на текст в аудио (текст в реч, текст в музика), генерирането на реч изисква комбинирането им със семантичните токени, извлечени от самонаблюдаваните моделите на речта.
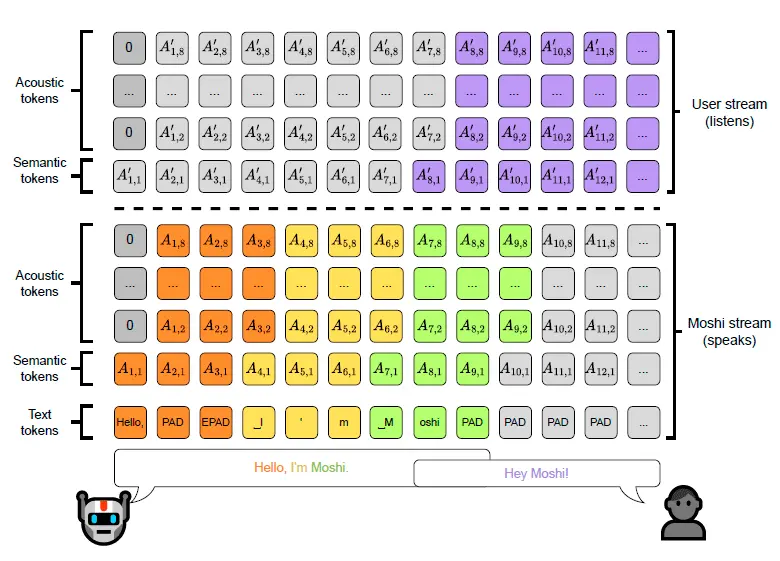
За разлика от акустичните си аналози, семантичните лексеми не позволяват възстановяването на даден висококачествен аудиофайл, но са силно свързани с езиковото съдържание. Това сходство с езика позволява генерирането на разбираема и последователна реч дори без текстово описание, като семантичните аудиотокени се използват като префикс за предсказване на акустичните токени.
Този хибриден подход за токенизация обаче е несъвместим с генерирането в реално време. Семантичните токени обикновено не са каузални и поради това могат да бъдат изчислени само в офлайн режим. Освен това генерирането на акустични и семантични токени с помощта на отделни енкодери представлява значителна изчислителна тежест. Затова Mimi използва дестилация за прехвърляне на безусловната семантична информация от високо ниво в токени, произведени от каузалния модел, което позволява поточно кодиране и декодиране на семантично-акустични токени.
Разработчиците са публикували отделна статия в блога, в която описват работата на невронните аудиокодеци, използвайки Mimi като пример.
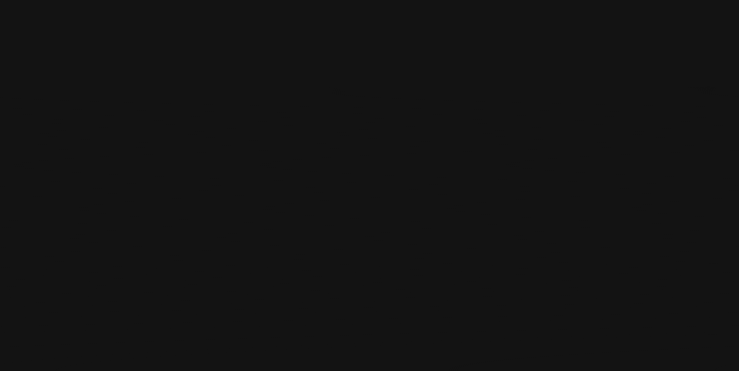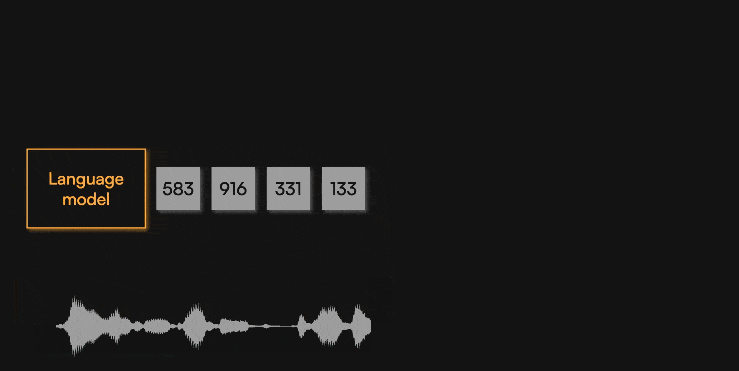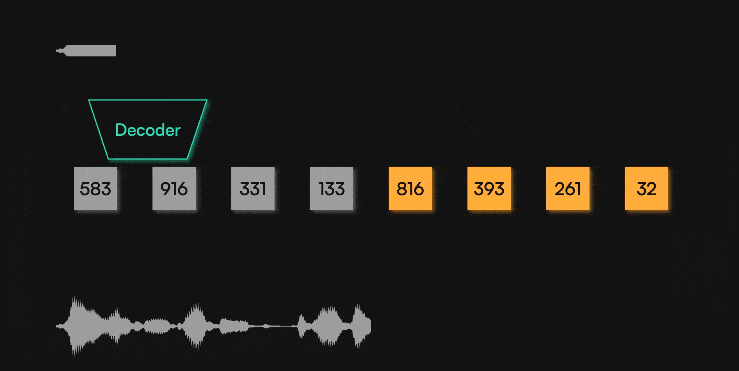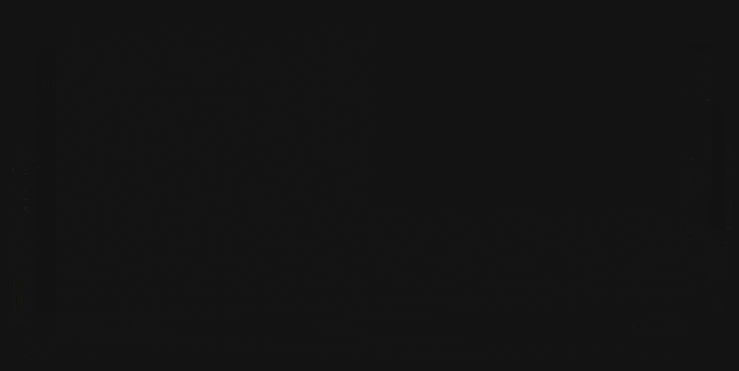
Базовата архитектура на Mimi е създадена по модела на SoundStream (от Google) и Encodec (от екстремистите в Meta) и включва автоенкодера SeaNet и квантификатора Residual Vector Quantizer (RVQ).
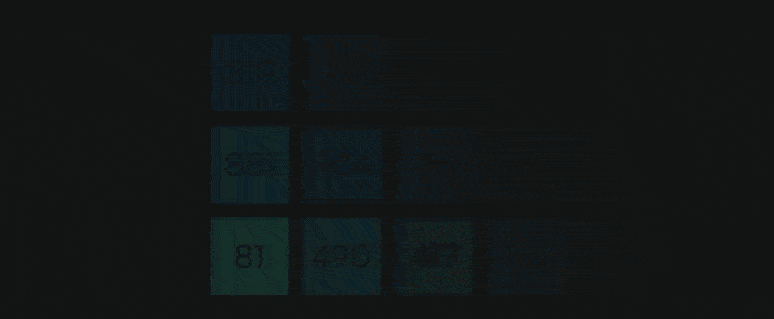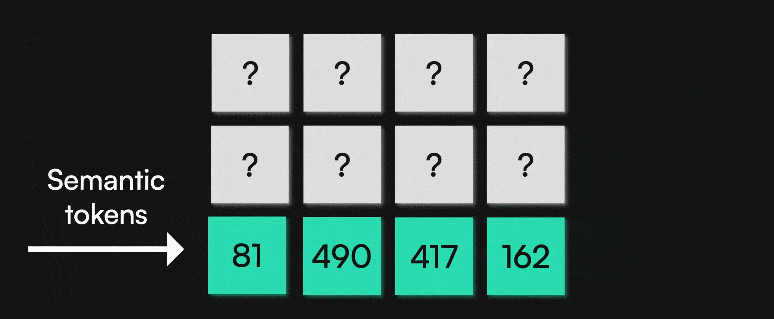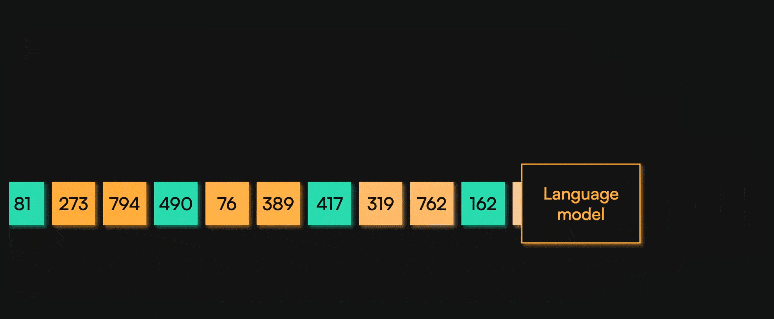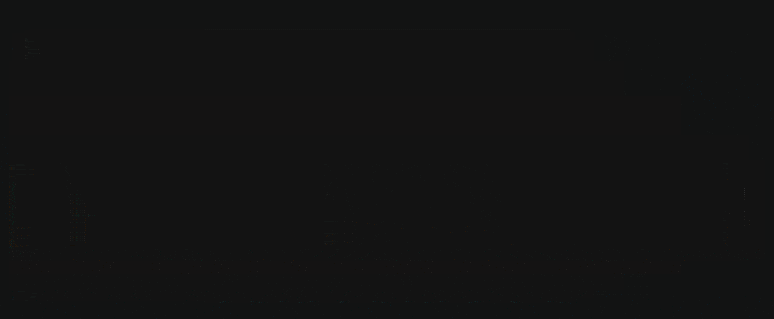
Квантификаторът RVQ преобразува набора от данни в едноизмерен вид с формата (t/128 * 8), а LLM прогнозира осем нива на отделните стъпки във времето:
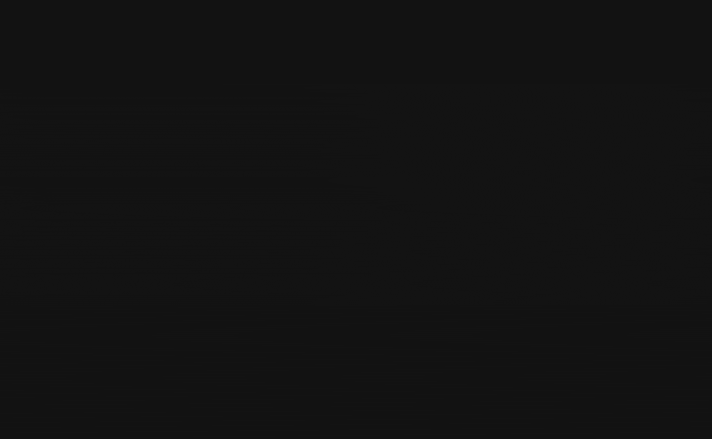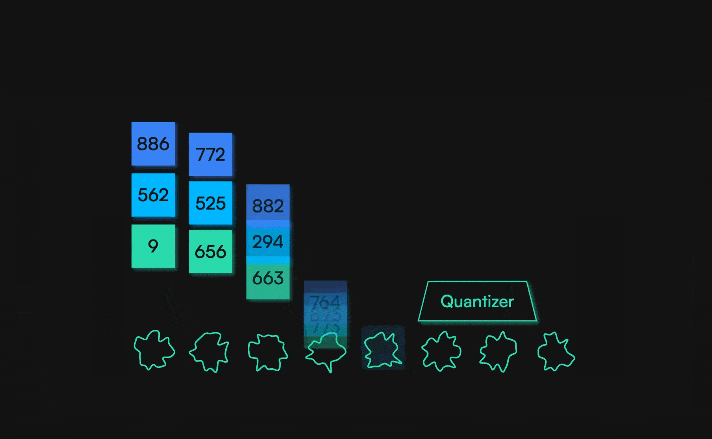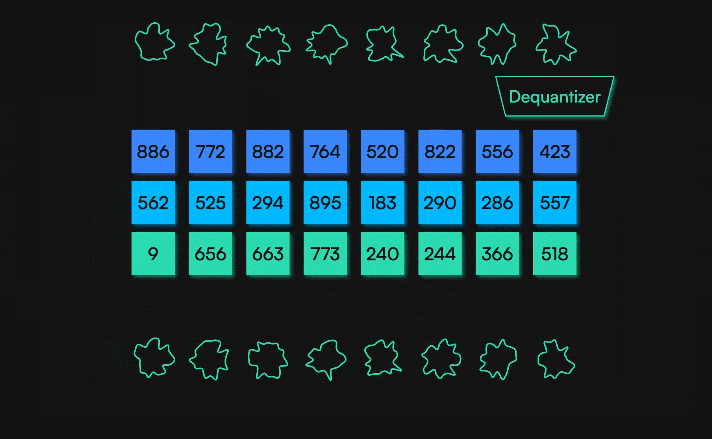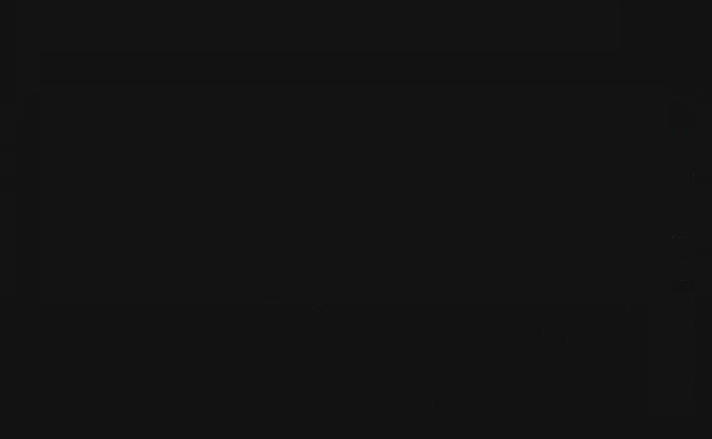
По този начин, вместо да прогнозира пряко образците, невронният аудиокодек работи на три етапа:
- Токенизиране на звука.
- Прогнозиране на следващите токени в LLM.
- Възстановяване на оригинала.
Kyutai е един от редките примери за европейски успехи в областта на ML и AI, тъй като в тази област Старият свят е малко по-назад от САЩ и Китай. Но пък тук е разработен един от първите невронни аудиокодеци.
Други модели и кодеци
През 2025 г. аудиокодекът Mimi се превърна в почти стандарт за компресиране на аудио в токени; той токенизира аудио със скорост 12,5 Hz (около 24 токена в секунда за всеки слой на квантуване), като ефективно компресира гласа и околните звуци.
След Moshi се появяват и други модели, които поддържат аудио в естествен вид, ето някои от тях:
- CSM (Sesame, 2025 г.): гласов чат, Llama + Mimi;
- Qwen3-Omni (Alibaba, 2025 г.): мултимодален LLM от Alibaba. Аудиоизходът се генерира от отделен модел на говорещия и изходът му не се връща обратно, така че по същество това е модел за преобразуване на текст в реч;
- MiMo-Audio (Xiaomi, 2025 г.): само аудио;
- LFM2-Audio (Liquid AI, 2025 г.): аудио/текст, използва кодека Mimi.
Но пазарът се развива много бързо и много неща могат да се променят още през 2026-2027 г. Освен споменатите по-горе SoundStream и Encodec, можем да споменем и невронните аудио кодеци DAC (Descript Audio Codec) и SNAC (Neural Audio Codec).
Като бонус. Специализиран компресор за FP64
Като цяло технологиите за компресиране на данни не стоят на едно място, всяка година се появяват нови научни трудове в тази област, изследвания и конкретни приложни разработки, които могат да се прилагат на практика. Така например наскоро беше пуснат любопитният архиватор fc (Floating-Point Compressor), който представлява нов ефективен компресор без загуби за 64-битови потоци от числа с плаваща запетая във формат IEEE-754 (FP64, float64, double-precision numbers или double). Той не извършва токенизация, но теоретично може да се използва и за компресиране на звука, подобно на невронните аудиокодеци, или заедно с тях.
64-битовите числа се състоят от знак (1 бит), експонента (11 бита преди десетичната запетая) и мантиса (останалите 52 бита, след десетичната запетая).
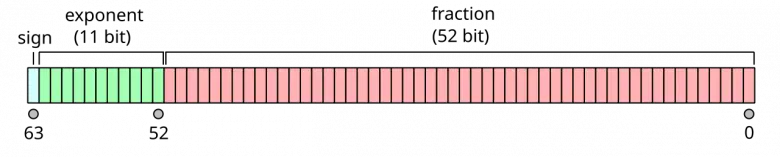
При най-малката промяна на дадено число мантисата в двоичния код се променя значително, така че за обикновените архиватори тя представлява случаен шум. Например числата 2,5439 и 2,5438 имат един и същ знак, експонента и първите 13 цифри на мантисата, а след това има 39 бита случаен шум, който е практически некомпресируем:
- Мантисата 2,5439 в double: 01000101100111101000000111110010000100101101011101110
- Мантисата 2,5438 в double: 01000101100110110011110100000111110010000100101101106
Специализираните кодеци разделят потока на три независими писти и прилагат математическо прогнозиране към мантисите на съседните числа, като превръщат случайния шум в по-лесно компресируеми вериги от данни. По-конкретно fc разделя потока на адаптивно променящи се блокове и след това използва набор от специализирани предсказващи/конвертиращи/кодиращи устройства за числа с плаваща запетая – и проверява кое от тях е най-ефективно за конкретен блок от числа. Това означава, че работи като метаархиватор, който използва няколко различни метода за компресиране и избира най-добрия от тях.
В резултат на това fc е няколко пъти по-ефективен от стандартните архиватори и също така е доста добър (малко под средното ниво) по отношение на скоростта на кодиране и декодиране:
| Кодек | Степен на компресия | Кодиране (МБ/с) | Декодиране (МБ/с) |
|---|---|---|---|
| fc | 3,07 | 120 | 1277 |
| zstd -3 | 2,07 | 528 | 1556 |
| zstd -9 | 2,09 | 111 | 1572 |
| fpzip | 1,71 | 123 | 121 |
| lz4hc -9 | 1,69 | 51 | 5835 |
| gorilla | 1,66 | 683 | 971 |
| lz4 | 1,62 | 2176 | 5353 |
Компресорът е проектиран за времеви редове, научни данни, симулации и анализи, където числата често имат структура: гладки криви, повтарящи се стойности, фиксирани стъпки, периодични сигнали, предсказуеми делти или мантиси с ниска ентропия.
Ако в бъдеще авторът разшири програмата, за да поддържа 32-битови плаващи числа, тя ще бъде подходяща и за компресия на висококачествено аудио без загуби.
Оказва се, че вместо просто да компресираме файловете, ние почти учим модела да разбира данните и да ги отгатва допълнително. Ако това наистина се доведе до съвършенство, архиваторите като цяло ще се променят до неузнаваемост.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
