


Специализираният модел за задачи и теореми показва резултати, които са по-достоверни от тези на много хора, и открива нова надпревара в областта на математическия изкуствен интелект.
Китайската компания DeepSeek представи новия специализиран модел за решаване на математически задачи – DeepSeek-Math-V2. Това е голям езиков модел, специализиран за доказване на теореми и задачи за олимпиади, а основната му разлика се състои в това, че той не просто дава отговор, а проверява собствените си разсъждения за правилност.
По същество DeepSeek-Math-V2 дава отговор на отдавнашен въпрос за изкуствения интелект: как да се уверим, че моделът е стигнал до правилното решение по честен начин, а не е отгатнал резултата или е намерил кратък, но неправилен обходен път. Повечето съвременни модели се обучават по такъв начин, че да уцелват по-често правилния краен отговор, за което се поощряват чрез система за възнаграждение в стила на подсиленото обучение. Но в математиката това не е достатъчно: при много задачи не е важен самият отговор, а строгото и прозрачно доказателство. Авторите изрично пишат, че точният краен резултат не гарантира правилността на разсъжденията, а за теоремите няма готово „правилно число“, което да се провери.

DeepSeekMath-V2 се основава на експерименталната база DeepSeek-V3.2-Exp-Base. Екипът е обучил отделен модел-проверител, който оценява математически доказателства, като търси логически пропуски и грешки стъпка по стъпка, и след това използва този модел-проверител като „съдник“ за основния модел на генератора на доказателства. Генераторът се възнаграждава не само за правилния краен отговор, но и за това колко добре неговите разсъждения са преминали строгата проверка. Ако проверката се провали, моделът се възнаграждава за това, че сам се опитва да намери слабости в решението си и да пренапише доказателството така, че то вече да премине проверката.
Зада предотвратят „сриването“ на системата в момента, в който генераторът стане по-умен от проверителя, разработчиците отделно мащабират изчислителните ресурси само за проверителя. Той се учи от все по-сложни, трудни за проверка примери, които самият модел генерира с нарастването на неговите възможности. Подобен затворен цикъл „генериране – проверка – усъвършенстване на проверяващия“ позволява да се запази разликата в уменията между двете части на системата и да не се загуби способността за самокоригиране. В статия в GitHub екипът заявява, че DeepSeekMath-V2 е достигнал „златното“ ниво на Международната математическа олимпиада 2025 г. и Китайската математическа олимпиада 2024 г., а на състезанието Putnam 2024 г. моделът е получил 118 от максималните 120 точки при използване на мащабируеми изчисления във фазата на решаване.
На IMO-ProofBench, специализиран бенчмарк, разработен от екипа на Google DeepMind за собствения му модел Gemini DeepThink, DeepSeekMath-V2, според независимия технически разбор, китайският модел побеждава DeepThink на базовите тестове.

Неофициалните обобщения на резултатите, публикувани от изследователи и ентусиасти, предоставят по-конкретни цифри: DeepSeekMath-V2 постига около 99% в основната и 61,9% в разширената част на IMO-ProofBench. В същото обобщение се твърди, че това е повече от моделите GPT-5 и Gemini при този набор от задачи, въпреки че това не е официална оценка, а сравнение въз основа на частни тестове.
Друг важен момент за общността: DeepSeek-Math-V2 се позиционира като първия отворен математически изкуствен интелект, който достига „златното“ ниво при задачите на ниво IMO. За това вече се пише в профилните форуми, където се публикуват линкове към статията и самите тегла на модела.
Моделът е достъпен в GitHub и Hugging Face, като хранилището е под Apache 2.0, с отделен лиценз за самите модели, който урежда условията за използване, включително за комерсиална употреба. Стартирането и характерът на отворения код на DeepSeekMath-V2 се съобщават допълнително от профилните блогове и публикациите в социалните медии, в които се подчертава, че тежестите могат да бъдат свободно изтеглени и използвани в предприятието, при спазване на условията на лиценза за модела.
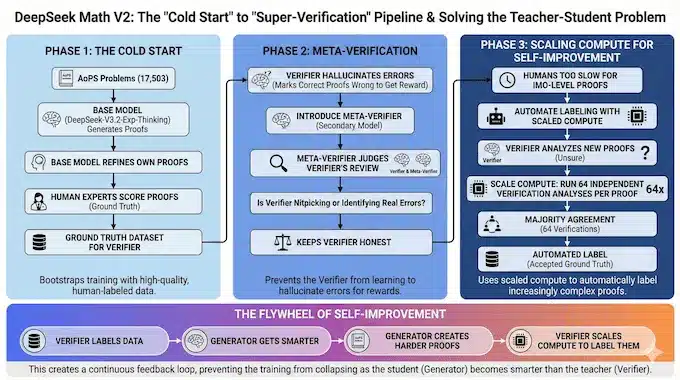
Борсовите и финансовите медии, отразяващи темата за ИИ, подчертават, че DeepSeek продължава целенасочено да инвестира в математически модели и формални доказателства. Според техните формулировки DeepSeek-Math-V2 използва самоодобряващ се цикъл на обучение, в който моделът автоматично прави партньорска проверка на своите доказателства, като подобрява качеството чрез сложни примери и по-мощен етап на проверка, което следва да повиши доверието в резултатите в научен и инженерен контекст.
Важно е да се разбере, че DeepSeek-Math-V2 не се появява от нищото. По-рано тази година компанията вече представи DeepSeek-Prover-V2 – гигантски модел с 671 милиарда параметри за формално доказване на теореми в системата Lean 4. Там акцентът беше поставен именно върху формалния език и строгите, подлежащи на машинна проверка доказателства. Новият DeepSeek-Math-V2 работи с по-познатите задачи от олимпиадите и текстови задачи, но чрез самопроверка се опитва да се доближи до света на формалните доказателства от гледна точка на надеждността.
За по-широката общност на изкуствения интелект тази работа е интересна не само заради числата в таблиците, но и заради самия подход. Ако успеем да се научим да мащабираме не само генерирането, но и проверката на разсъжденията, подобни модели биха могли да се прилагат по-безпроблемно в науката, инженерството, формалната проверка на софтуера и дори в образованието, където е по-важно да се обясни решението, отколкото числото в самия отговор. Авторите изрично пишат, че резултатите им показват: насоката на самопроверяващите се разсъждения изглежда като реалистична и обещаваща стъпка към по-стабилен математически изкуствен интелект.
Засега DeepSeek-Math-V2 остава тясно специализиран, но много показателен пример за това как се измества фокусът в ИИ: от „отгатване на правилния отговор“ към контролиране на мисловния поток на модела. А начинът, по който разработчиците, изследователите и почитателите на математическите олимпиади реагираха на новостта, показва, че надпреварата вече не е само за общия интелект, но и за качеството и проверимостта на разсъжденията.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
