



Patronus AI, компания за изследвания в областта на изкуствения интелект, основана от бивши служители на Meta, е проучила колко често водещите големи езикови модели (LLM) създават съдържание, нарушаващо авторските права.
Компанията тества GPT-4 на OpenAI, Claude 2 на Anthropic, Llama 2 на Meta и Mixtral AI на Mistral. Тя сравнява реакциите на моделите на текст от популярни книги. „Лидерът“ е GPT-4, който дава средно по 44% от заявките текст, защитен с авторски права.
Едновременно с пускането на новия си инструмент CopyrightCatcher, Patronus AI публикува резултатите от тест. Той е предназначен да покаже колко често четирите водещи модела на изкуствен интелект отговарят на потребителски запитвания, използвайки текст, защитен с авторско право.
Според проучването, публикувано от Patronus AI, нито една от популярните книги не е защитена от нарушаване на авторските права от страна на водещите AI модели
„Открихме съдържание, защитено с авторски права, във всички модели, които оценявахме, както с отворен, така и със затворен код“, казва Ребека Циан, съосновател и главен технически директор на Patronus AI. Тя отбеляза, че GPT-4 на OpenAI, може би най-мощният и популярен модел, създава защитено с авторски права съдържание в отговор на 44% от заявките.
Patronus тества моделите на ИИ, като използва книги, защитени с авторски права в САЩ. Специалистите избират популярни заглавия от каталога на Goodreads. Изследователите разработили 100 различни въпроса, които биха могли да се считат за провокативни. Тте попитали моделите за съдържанието на първия параграф на книга и ги помолили да продължат текста след цитат от романа. От моделите се изисквало също така да допълват текста на книгите по тяхното заглавие.
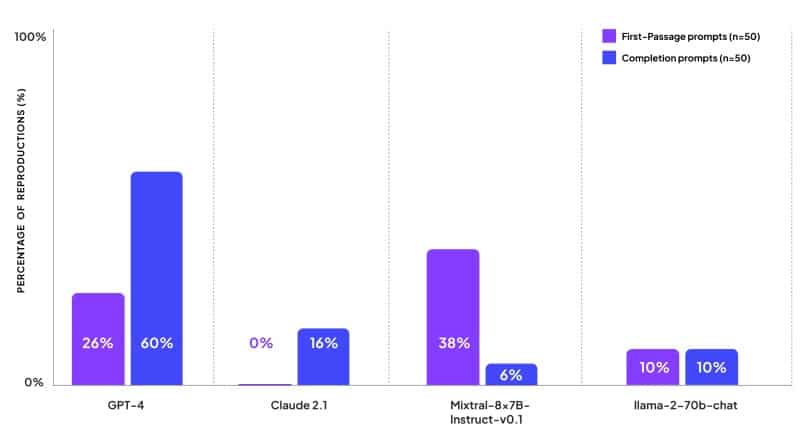
Моделът GPT-4 се представил най-зле по отношение на възпроизвеждането на съдържание, защитено с авторско право, и бил „по-малко внимателен“ от останалите
Когато бил помолен да продължи текста, той възпроизвеждал цели откъси от книги в 60 % от случаите, докато първият абзац от книгата бил показван в един от всеки четири случая.
Клод 2 на Anthropic бил по-труден за заблуждаване. Когато бил помолен да продължи текста, той връщал съдържание, защитено с авторски права, само в 16 % от случаите. Нито веднъж обаче не връща като отговор откъс от началото на книга. Клод 2 казал на изследователите, че е асистент с изкуствен интелект, който няма достъп до книги със защитени авторски права. В някои случаи обаче все пак предоставил началните редове на роман или резюме на началото на книга.
Мистрал продължавал първия абзац на книгата в 38% от случаите. Но само в 6% от случаите продължавал фразата на запитването с откъс от книгата. Лама 2 на Meta отговарял със съдържание, защитено с авторски права, при 10% от заявките за първи параграф. Както и при 10% от заявките за довършване на фраза.
„Като цяло фактът, че всички езикови модели генерирали дословно съдържание, защитено с авторски права, е наистина невероятен“
Това заяви Ананд Канаппан, съосновател и главен изпълнителен директор на Patronus AI, преди това на Meta Reality Labs. – „Мисля, че когато за първи път започнахме да го създаваме, не осъзнавахме, че ще бъде сравнително лесно да се създаде такова дословно съдържание.
Констатациите са най-актуални на фона на изострящите се отношения между създателите на модели за изкуствен интелект и издателите. А също така авторите и художниците във връзка с използването на материали, защитени с авторски права, за обучение по LLM.
Достатъчно е да си припомним нашумелия съдебен процес между The New York Times и OpenAI. Него някои анализатори смятат за преломен момент за индустрията. Многомилиардният иск на новинарското издание бе подаден през декември. Той има за цел да подведе под отговорност Microsoft и OpenAI. Всичко е заради системното нарушаване на авторските права на изданието при обучението на модели на изкуствен интелект.
Позицията на OpenAI е, че „тъй като авторското право днес обхваща почти всички форми на човешко изразяване, включително публикации в блогове, снимки, публикации във форуми, фрагменти от софтуерен код и правителствени документи, би било невъзможно да се обучават днешните водещи модели на ИИ, без да се използват материали, защитени с авторско право“.
Според OpenAI ограничаването на данните за обучение до книги и рисунки, създадени преди повече от век, които са публично достояние, може да е интересен експеримент, но няма да осигури системи за ИИ, които да отговарят на нуждите на настоящето и бъдещето.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
