


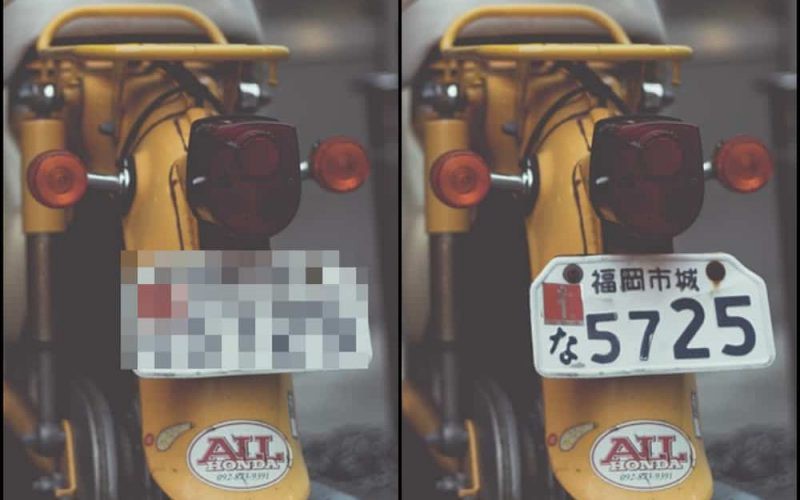

Нашата компания съставя много отчети, което е разбираемо, понеже ние се занимаваме с проникване в най-различни компютърни системи. Често пъти се налага част от текста да бъде прикрита. Отдавна сме възприели политиката, според която за по-надеждно скриване на текста използваме единствено черни линии. Понякога хората, за да се проявят или за да направят своята документация да изглежда по-добре, използват най-различни методи за размиване, изкривяване и пикселизация на текста. Това може да им изиграе лоша шега.
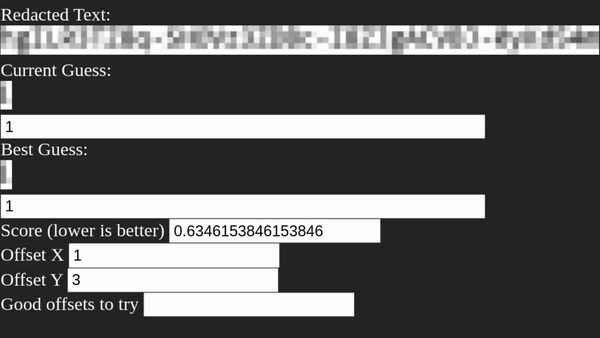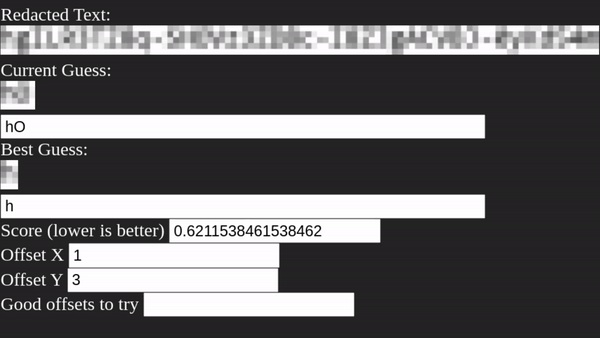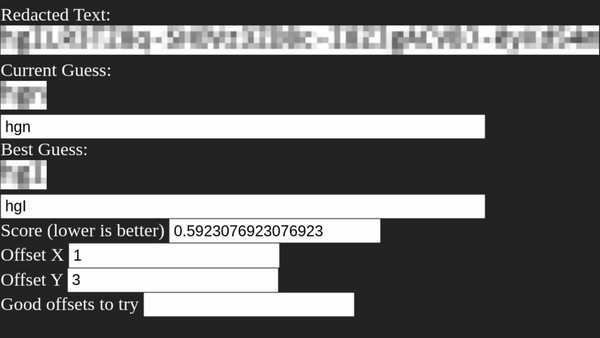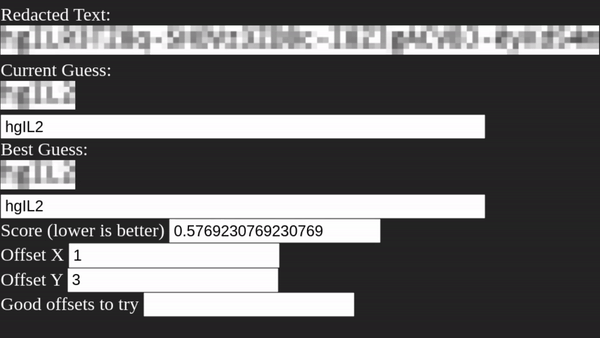
Тук ще се спрем върху пикселизацията и ще покажем защо това е един неособено добър и небезопасен метод, при който винаги има изтичане на информация. За да покажа как става това аз написах програмата Unredacter, която е качена в GitHub и може да бъде свободно изтегляна и ползвана. Тя приема пикселизирания текст, преобразува го и показва оригиналния текст. По принцип пикселизацията се използва за постигане на по-добър визуален ефект, а не за скриване на информацията, но много хора не знаят това и използват този метод за скриване на някои данни, които обаче могат да бъдат лесно възстановени.
Приемам предизвикателството
Доста често се използва софтуерния инструмент Depix, който прави пикселизация на текста чрез сложно преместване на пикселите и тяхното преобразуване в специални блокове чрез използването на Последователността на де Брюйн (de Bruijn sequence) за съответния шрифт. На мен много ми харесва теоретичната част на този инструмент, но известен специалист от Jumpsec демонстрира, че на практика използваният алгоритъм не работи толкова добре, както много хора очакват. В реалността възникват незначителни вариации и шум, които пречат на работата на алгоритъма. Интересното в този случай е, че Jumpsec обяви състезания с голяма награда за този, който успее да декриптира следващото изображение:
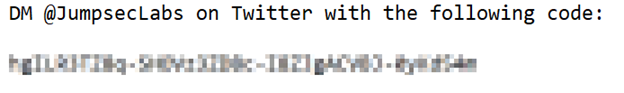
Как бих могъл да се откажа от подобно предизвикателство?
Основните принципи на пикселизацията
Пикселизацията изглежда ето така:
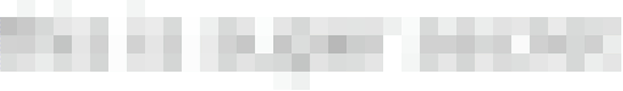
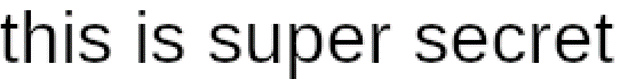
Алгоритъмът не е сложен. Изображението се разделя на мрежа от блокове, като в нашия пример техният размер е 8х8. След това за всеки отделен блок задаваме отенък на сивия цвят на вече редактираното по този начин изображение, който е със средното значение на данните от цялата област. И това е всичко – последователна пикселна средна стойност за всяко блокче.
При този ефект се постига нещо като размазване на информацията на изображенията по блокове. Въпреки че част от информацията се губи при този процес, очевидно е, че там има нещо. Тази изтекла информация може да се използва.
Интересното е, че заради своята простота този алгоритъм е широко стандартизиран. Тоест, независимо дали обработвате вашето изображения с GiMP, Photoshop, друг графичен редактор или инструмент, резултатът ще бъде един и същ.
Нека в нашия случай да допуснем, че хакерът знае следното:
- Какъв шрифт е използван
- Размерът на шрифта на текста
- Че това е именно текст
Това са съвсем логични допускания, понеже в реалността хакерът с много голяма вероятност е намерил отнякъде целия текст, в който е размазана само малка част от него. В представения за това състезание текст точно над пикселизирания текст се виждат напечатани няколко думи, които дават именно тази информация.
Проблемите, които следва да се преодолеят
Най-важното е, че самият процес на пикселизация е локален. От гледна точка на криптографията може да се каже, че при него няма дифузия. Промяната на един пиксел във входното изображение оказва влияние само на съответния изходен блок, а това означава, че е възможно разпознаването на изображението символ по символ. Ще направим рекурсивно търсене в дълбочина за всеки един знак и ще правим предположения доколко добре съответства на редактирания текст.
В основни линии идеята е следната: да предположим, че първият блок от пиксели съответства на буквата А. Ние самостоятелно извършваме пикселизация на буквата А и я сравняваме със изходното изображение. Същото правим с буквата В и т.н. Не изглежда сложно нали? Всъщност има редица проблеми, които в началото съвсем не са очевидни. Нека да се спрем по-подробно.
Проблемът с разтичането на символа
Първият проблем с който веднага се сблъскваме е, че символите в текста не съответстват едно към едно с блоковете от пиксели. Това означава, че правилното предположение може да има няколко грешни блока в най-дясната си част. Да разгледаме следния пример:
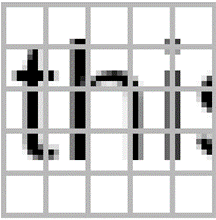
Виждаме че буквите t и h имат обща колона в един и същи блок. Ето защо, ако предположим, че това наистина е буквата t, то най-лявата колона очевидно ще бъде правилна, но колкото по надясно отиваме, толкова по-голяма става грешката, понеже в този блок има и други букви.
Правилните пиксели, разпознаването на t и разликите
Втората колона ни подава погрешна информация заради буквата h. Ако разглеждахме само тази колона, то можехме да стигнем до извода, че буквата t всъщност не е била първата буква, понеже половината от нейните блокове са напълно погрешни и можем да решим, че това е някоя друга буква.
Като за начало ние се опитваме да не се съобразяваме с най-десния блок при нашите предположения. Този блок най-много се разтича към посока неправилни пиксели и може да добави съществена грешка, която е толкова голяма, че да започнем да получаваме резултати, които не са верни. По принцип винаги има вероятност чисто случайно да разпознаем съответната буква, като тази вероятност се увеличава с намаляването броя на блоковете.
Ето защо е по-добре да се отреже блока за сравняване на границата на самата буква. В този случай получаваме следното:
 Виждаме, че качеството на съвпаденията рязко се повиши, понеже използваме по-малка част от невярната област отдясно. Това е така понеже ние прекъсваме сравняването именно на границата където завършва буквата t.
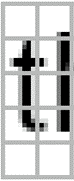 Преимуществото на този подход е, че колкото повече даден символ се разпростира върху един блок, толкова е по-голяма вероятността това да се окаже вярно предположение, понеже се използва по-голямата част от този блок. Ето защо нашият алгоритъм автоматично изрязва частта на блока, която води до неправилни предложения и сравненията се извършват с по-полезната от информационна гледна точка част от блока.
Проблемът с интервалите
Подмножество на проблема с разтичането на символите е, че интервалът нарушава някои от нашите предположения за разпознаване на символите. На пръв поглед изглежда логично , че когато разпознаем даден конкретен символ, то очакваме, че неговата пикселизирана версия до голяма степен трябва да прилича или напомня на изображението, дадено в началото на това състезание.
Само че това далеч не винаги е вярно когато имаме символ с интервал след него. Когато имаме подобен случай, пикселизираните блокове напълно ще са обхванати от следващия символ. Ето един пример, при който правим предположение, че имаме работа със символите „this is “ (с интервал в края).
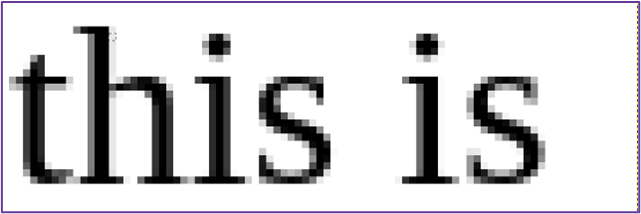
Нашата програма за разпознаване се опитва да го пикселизира по същия начин, като подготвя следния шаблон за сравнение и очаква че интервалът в края ще си остане:
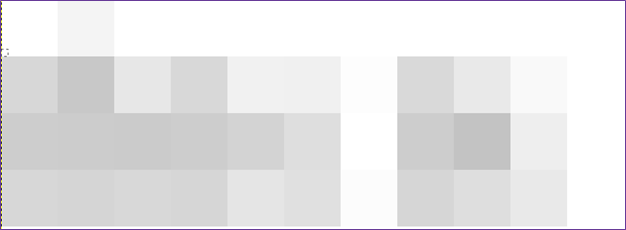
Само че в реалността след интервала има още един символ. Той се разтича толкова силно, че нашето предположение за създаване на шаблон за сравняване се оказва съвсем погрешно. Ето какво имаме в оригинала:
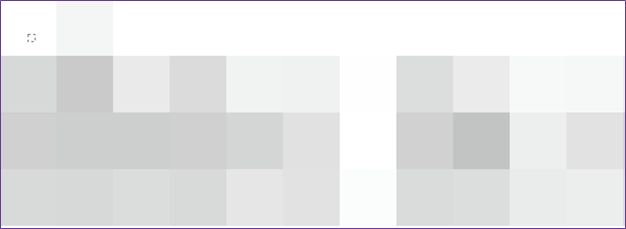
Този проблем може да бъде решен по много начини. Най-очевидният е никога да не се правят предположения, че има отделни „висящи“ интервали и те винаги да бъдат съединявани с някаква друга буква или символ. Това оправя нещата, но двойно увеличава размера на множеството допустими символи. Това силно забавя процеса на обработка.
Вместо това можем да въведем изключения за предполагаеми интервали. Тази таблица помага, въпреки че изглежда доста тромава като решение.
Проблемът с шрифтовете с променлива ширина на символите
Повечето шрифтове, използвани от потребителите, имат променлива ширина на символите. Това означава, че хоризонталното пространство, заемано от дадена буква, зависи от самата буква. Така например, w заема повече място от i. Точно обратното е при моноширинните шрифтове, при които всяка една буква заема едно и също хоризонтално пространство.
Променлива ширина:
iiiii
wwwww
Моноширинен шрифт“
iiiii wwwww
За нашата атака (предполагаме, че се използва шрифт с променлива ширина) това означава, че всяка предполагаема буква ще има каскадно влияние на това, което се намира след нея: Ако направите предположение, че имате
this is supww
То всички следващи букви ще бъдат изместени. Изглежда сериозно, но не е чак толкова зле. Това просто означава, че ще трябва да осъществим рекурсивно търсене в дълбочина и няма да разглеждаме буквите като отделни и независими артефакти.
Да допуснем, че имаме работа със следното:
this is su
Ще пробваме да заменим всеки един символ като следваща буква и ще погледнем кои от тях достатъчно добре съответстват на оригиналното пикслелизирано изображение. Постепенно ще се образува едно подмножество от добри предположения, което вероятно ще включва р и q, понеже в този случай p е верният отговор, а q много прилича на него. След това ще започнем целия процес наново за реда със символите this is sup, докато не достигнем до безизходна ситуация, при която вече няма добри предположения. На този етап нашата функция по естествен начин ще се върне назад, за да провери нашата друга версия – q.
И така нататък докато не се изчерпят всички добри предположения.
Проблемът с изместванията при пикселизацията
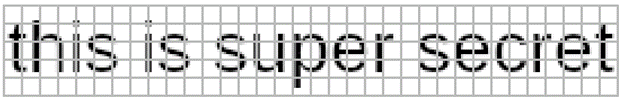
При пикселизирането на текст изображението има две степени на свобода, с които трябва да се съобразим: изместване по X и Y координатите. Да разгледаме изображение на разпознат текст, който е разделен на блокове с размер 8х8:
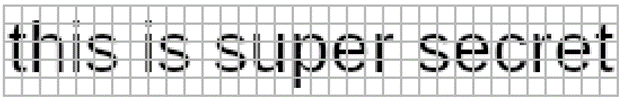
Ако възприемем, че този текст е една статична мрежа от блокове, то това означава, че има 64 уникални локации за поместване на текст в тази мрежа. Нека да приемем, че това е изместването по X и Y. Важното тук е, че крайното изображение силно ще зависи от избраното от нас изместване.
Ето как изглежда крайното изображение за един и същ текст, но с различно изместване:
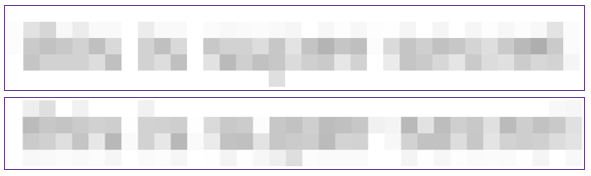
Нещо повече, няма откъде предварително да знаем какви са били изместванията (за разлика от типа и размера на шрифта). Изместването се задава в повечето графични редактори от типа на GiMP по случен начин, като случайният елемент се взема от това, къде е кликнал потребителят при създаването на правоъгълника за избор на част от изображението. Ако е кликнал пиксел по-нагоре или по-надолу, то крайното изображение ще бъде съвсем различно.
Хубавото тук е, че изместванията все пак не са чак толкова много. При размер на блока 8х8 трябва да се проверят 64 измествания. Но в текста, даден в рамките на това състезание, размерът на блока е 5 и това означава, че трябва да проверяваме 25 измествания.
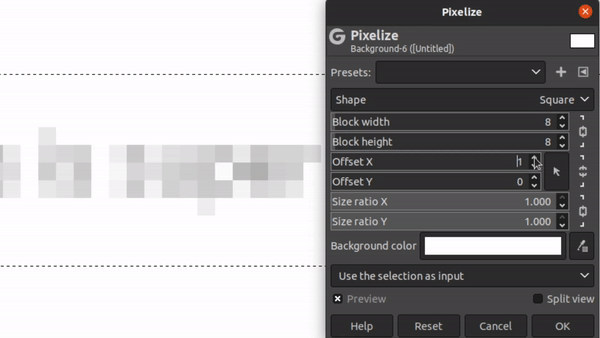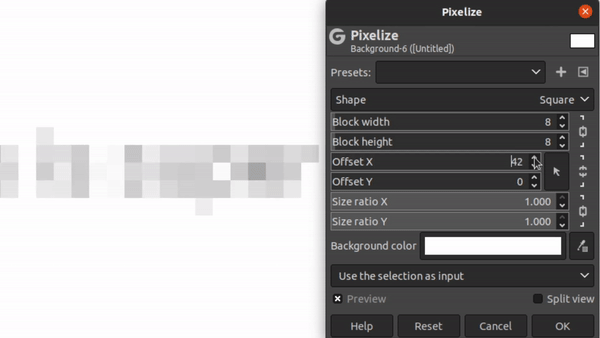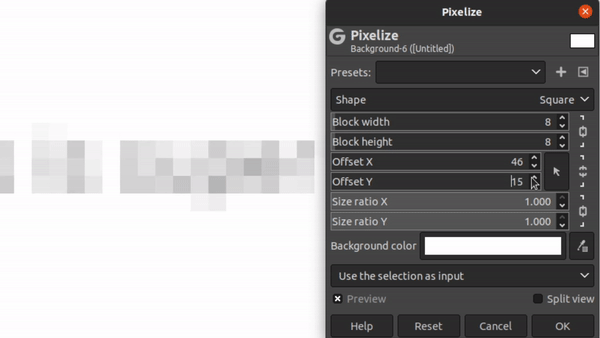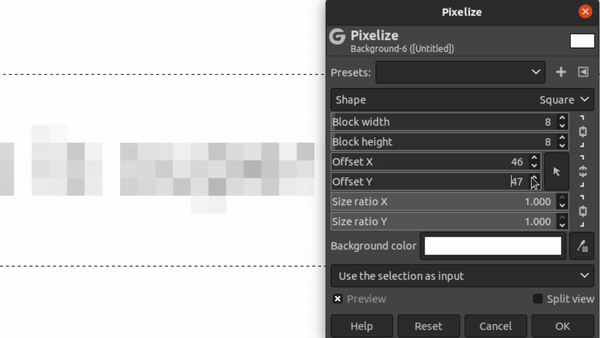
Нашият алгоритъм проверява в затворен цикъл всяко едно изместване за всяка една буква, която сме приели за правилна.
Текстът от състезанието
Отново да погледнем нашата задача:

Използваният от мен алгоритъм Unredacter сравнително бързо изчисли отместването (3,1) и в крайна сметка се получи следното:
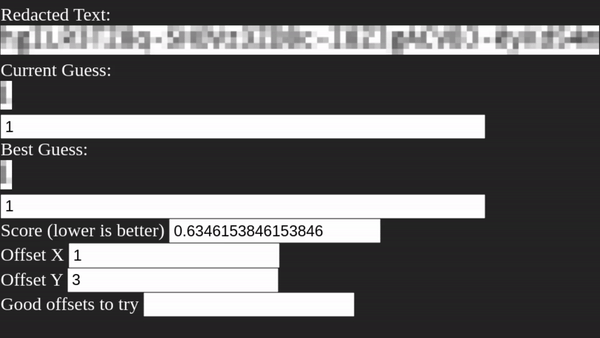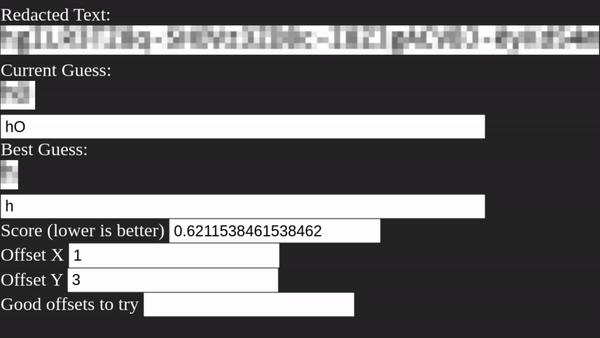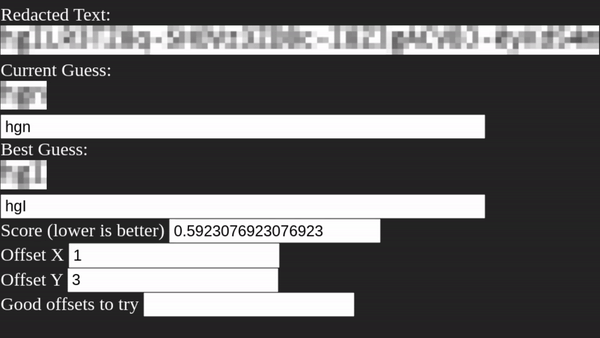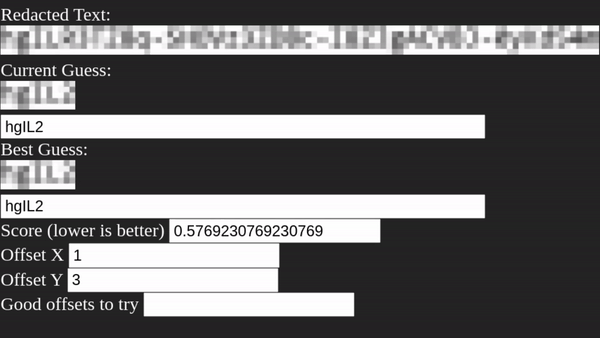
След няколко минути алгоритъмът Unredacter показа решението:
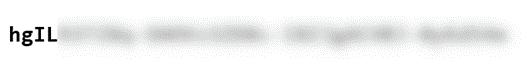 Организаторите на състезанието ме помолиха да не разкривам целия текст и да оставя това удоволствие и на другите, които се интересуват от тази тема. С алгоритъма Unredacter можете да се запознаете в моето хранилище в GitHub.
Изводът от казаното дотук е, че ако наистина искате да скриете някакъв текст, то е по-добре да използвате черни ивици, които го закриват. Има много по-съвършени алгоритми от моя Unredacter, които се справят с всичко от подобен род – пикселизация, фазинг и други.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
