


AMD представи Instella Math — езиков модел, предназначен за решаване на проблеми, изискващи сложни логически конструкции. Отбелязва се, че това е първият модел, който използва обучение с подсилване, базирано на дълги вериги от разсъждения, и същевременно — базиран изцяло на графичните процесори на AMD.
Проектът е базиран на Instella 3B Instruct, чиито възможности бяха разширени с многоетапен цикъл на обучение: два етапа на контролирана фина настройка и три етапа на обучение с подсилване, използвайки метода VERL. Всичко това е извършено на базата на ускорителите AMD Instinct MI300X.
Instella Math
Instella Math — това е първият езиков модел на AMD за разсъждения, с 3 милиарда параметъра, обучен на клъстер от 32 ускорителя AMD Instinct MI300X. Instella Math е с напълно отворен код: неговата архитектура, код за обучение, тегла и набори от данни са с отворен код. Базовият модел Instella 3B Instruct също е с отворен код, включително и резултатите от фината настройка на задачите за разсъждение.
Моделът е изграден върху софтуерния стек AMD ROCm и използва ефикасни разпределени методи за обучение, включително обучение с подсилване, работещи на четири MI300X клъстера (по 8 графични процесора всеки).
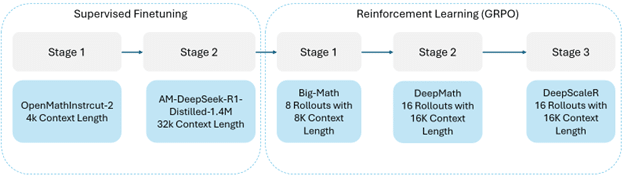
Наследявайки архитектурата Instella 3B Instruct, Instella Math е оптимизирана за многоетапен логически анализ, решаване на математически задачи и работа с вериги от разсъждения. Процесът на обучение включва два етапа на контролирана фина настройка и три етапа на обучение с подсилване, използвайки алгоритъма GRPO.
Фина настройка с надзор
За Instella Math беше използвана двуетапна схема за фина настройка, за да се развие постепенно способността за разсъждение на Instella 3B Instruct. Първият етап включва фина настройка на обучението, обхващаща математическите теми. Вторият етап включва обучение на модела, за да предоставя задълбочен анализ и ясно структурирани логически стъпки, необходими за решаване на проблеми на ниво математически олимпиади.
Етап 1: инструкции за донастройка с OpenMathInstruct 2
В първия етап на контролираната фина настройка (SFT), моделът е обучен да следва точно инструкции и формат заявка-отговор или задача-решение. Избраният набор от данни е OpenMathInstruct 2, който съдържа 14 милиона двойки задача-решение, генерирани от обучителните комплекти GSM8K и MATH. Корпусът обхваща широк спектър от теми — от аритметика и алгебра до теория на вероятностите и анализ.
Етап 2: Дълбоко разсъждение с дълъг контекст върху AM DeepSeek R1 Distilled
Вторият етап от контролираната фина настройка има за цел да засили уменията за разсъждение на модела. За тази цел е използван AM DeepSeek R1 Distilled 1.4M — голям набор от висококачествени, сложни проблеми. На този етап дължината на контекста е увеличена от 4000 токена на 32 000 токена, така че моделът да може да се учи върху дългите вериги от разсъждения, отделени от големите, специализирани модели като DeepSeek R1.
Обучение с подсилване
Етап 1: GRPO с 8 варианта за внедряване и 8 хиляди токена на Big Math
В първия етап на обучението с подсилване, използвайки алгоритъма за групова относителна оптимизация на политиките (GRPO), моделът е обучен върху Big Math RL Verified set — внимателно подбрана колекция от сложни многостъпкови математически задачи. За една заявка моделът генерира 8 подробни отговора, всеки с размер до 8 хиляди токена, което позволява изследването на различни траектории на разсъждение. Обучението е проведено в рамките на 1200 GRPO стъпки, използвайки правила за награди, разработени от Prime RL, които насърчават правилните решения в дадения формат. Процесът е разпределен в 16 MI300X графични процесора в 2 клъстера, а библиотеките VERL и VLLM са осигурили стабилно и ефективно събиране на сканирания, оценка на наградите и актуализиране на политиките.
Етап 2: GRPO се разширява до 16 внедрявания и 16 000 токена в DeepMath
За да се достигнат границите на дългите вериги от разсъждения, вторият етап на GRPO е проведен върху набора от данни DeepMath. Тук за всяка заявка са създадени 16 варианта за отговор с обем до 16 хиляди токена. Този етап е имал за цел да увеличи максимално потенциала на модела в дълбокия математически анализ — решаване на проблеми, които изискват дълги изводи, вложени логически стъпки или подобие на формални доказателства. Обучението е проведено на 32 графични процесора MI300X, състоящи се от 4 клъстера и продължителност 600 GRPO стъпки.
Етап 3: GRPO с 16 внедрявания и 16 000 токена на DeepScaleR
За да се подобри точността на задачите на международно ниво на олимпиада, третият етап на GRPO е стартиран върху комплекта DeepScaleR, съдържащ оригинални задачи от AIME (1984–2023) и AMC (до 2023 г.). Както и във втория етап, моделът генерира 16 сканирания от по 16 хиляди токена всяко. Обучението е проведено на 32 графични процесора MI300X (4 клъстера) и е продължило 740 GRPO стъпки.
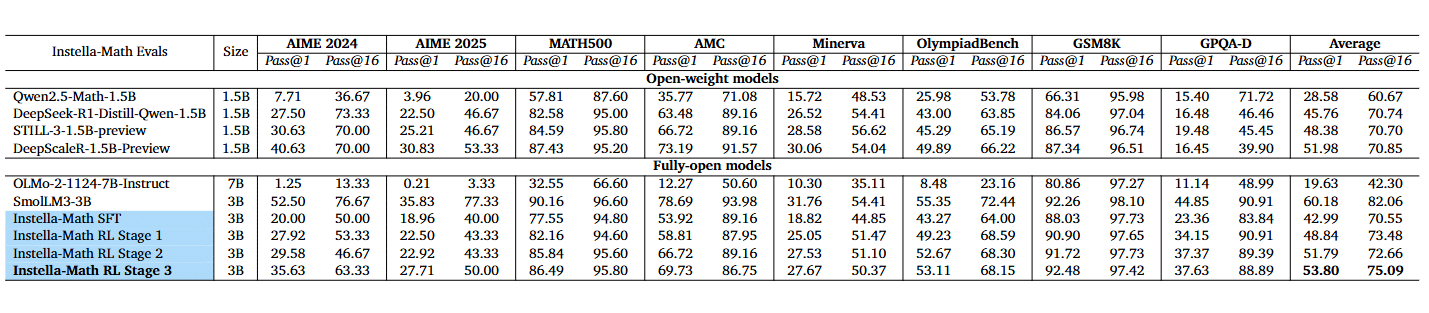
Използвайки същата методология за оценяване като DeepScaleR 1.5B, таблицата показва точността Pass@1, осреднена за 16 отговора. Instella Math се представя конкурентно в съревнование с водещи компактни модели с отворен код, като Deepseek R1 Distilled Qwen 1.5B, Still 3 1.5B, DeepScaleR 1.5B и SmolLM3 3B.
Обучението с подсилване демонстрира висока производителност: Instella Math е подобрил резултата на своята версия в сравнение с Instella Math SFT с 10,81 точки, докато печалбата на DeepScaleR спрямо базовия модел (Deepseek R1 Distilled Qwen 1.5B) беше само 6,22 точки.
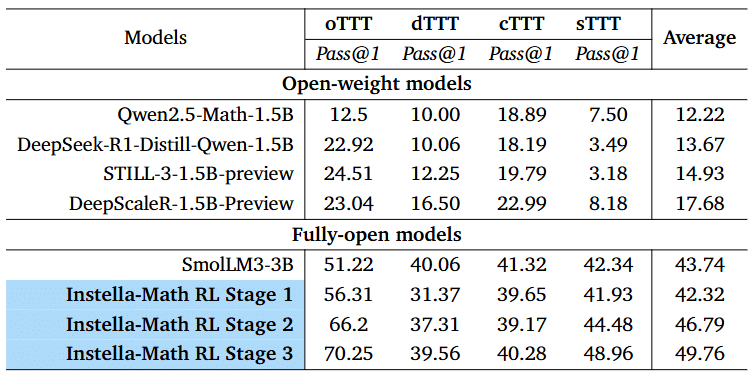
Instella Math е тестван и с новия бенчмарк TTT Bench, който оценява стратегическото, пространствено и логическото мислене. Забележителното тук е, че въпреки че не е получил нито един пример за данни за обучение в стил TTT Bench или подобни стратегически игри на нито един от подготвителните етапи, Instella Math е показал най-добрия резултат сред всички тествани модели.
Най-важното е, че подобно на Olmo2 и SmolLM 3B, Instella Math е напълно отворен езиков модел — по отношение на данните за обучение на базовата версия (Instella 3B), контролираното фино настройване и етапите на обучение с подсилване. За разлика от Instella Math, много конкуренти публикуват само завършените модели, като същевременно запазват поверителността на базовите данни за обучение (напр. Qwen 1.5B) и процесите на отделяне при разсъждение (напр. Deepseek R1).
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
