



Perplexity – ИИ-компания, която позиционира продукта си като „безплатна търсачка, базирана на изкуствен интелект“ се оказа в центъра на скандал. След като Forbes обвини Perplexity в кражба на съдържание и препубликуването му в различни платформи, изданието Wired съобщи, че Perplexity пренебрегва протокола за изключване на роботи (robots.txt) и събира неразрешени данни от Wired и други медийни холдинги на Condé Nast. Технологичният сайт The Shortcut също отправи подобни обвинения.
Според Ройтерс, Perplexity не е единствената компания, която пренебрегва robots.txt и претърсва уебсайтове за съдържание, което след това се използва за обучение на технологията им.
Агенцията се позовава на писмо от TollBit – стартъп, който помага на издателите да сключват лицензионни сделки с компании, занимаващи се с изкуствен интелект. В писмото се съобщава, че „агенти на ИИ от множество източници (а не само от една компания) избират да заобикалят протокола robots.txt, за да извличат съдържание от уебсайтове“.
Robots.txt е прост, но ефективен инструмент, който собствениците на уебсайтове използват, за да управляват индексирането от роботите на търсачките.
TollBit не посочва конкретни компании, но Business Insider съобщава, че OpenAI и Anthropic – създателите на чатботовете ChatGPT и Claude съответно също игнорират сигналите от robots.txt. И двете компании по-рано твърдяха, че спазват инструкциите „не сканирай“, посочени във файловете robots.txt.
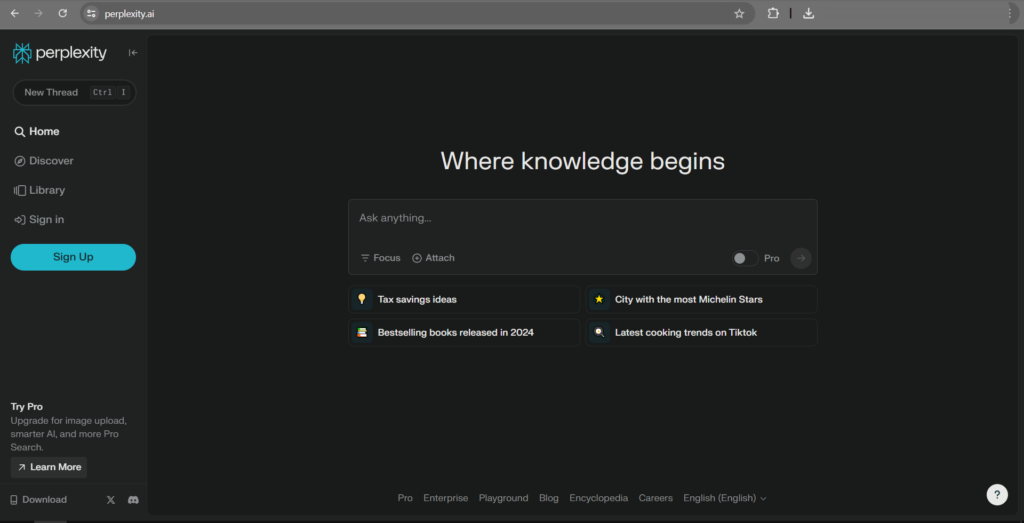
В хода на собственото си разследване Wired откри, че машина на сървъра на Amazon контролирана от Perplexity, заобикаля инструкциите robots.txt на уебсайта на изданието. За да потвърди, че Perplexity сканира съдържанието им, Wired предостави на инструмента заглавията на статиите си и кратки описания на материалите. В резултат на това инструментът създаде текстове, които „силно наподобяваха“ статиите на Wired и бяха почти без никакво указване на източника.
В интервю за Fast Company главният изпълнителен директор на Perplexity Аравинд Сренивас отрече умишлено да пренебрегва robots.txt. Той обясни, че компанията използва уеб скенери на трети страни в допълнение към своите собствени и че скенерът, идентифициран от Wired е един от тях. На въпроса на Fast Company дали Perplexity е казала на доставчика на скенери да спре да сканира сайта на Wired, той отговори само, че „това е сложно“.
Сренивас се опита да оправдае действията на компанията, като заяви, че протоколът за изключване на роботи „не е правна рамка“ и предположи, че издателите и компаниите за изкуствен интелект създават нови отношения. Той също така намекна, че Wired умишлено е използвала подкани, за да накара чатбота Perplexity да се държи по определен начин, и обикновените потребители няма да получат същите резултати. По отношение на неточната информация, генерирана от инструмента, Сренивас каза: „Никога не сме твърдяли, че нашата услуга не халюцинира.“
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
