



Изпълнителният директор на Anthropic Дарио Амодей е загрижен за работата на китайския DeepSeek и неговия модел R1. В интервю за подкаста ChinaTalk на Jordan Schneider той каза, че по време на тест за сигурност DeepSeek е генерирал информация за биооръжие.
Представянето на DeepSeek беше „най-лошото от всички модели, които някога сме тествали“ — казва Амодей. Според него моделът „няма бариери срещу генерирането на чувствителна информация„.
Anthropic редовно провежда тестове на различни AI-модели, за да оцени техните потенциални рискове за националната сигурност. По този начин екипът проучва дали моделите могат да генерират свързана с биологични оръжия информация, която не се намира лесно в Google или в учебниците. Той не уточнява кой модел на DeepSeek е тествал Anthropic.
Докато Амодей не вярва, че към момента моделите на DeepSeek са „опасни“ по отношение на предоставянето на чувствителна информация, те могат да станат такива в близко бъдеще. Той похвали екипа на DeepSeek като „талантливи инженери„, но посъветва компанията да „приеме сериозно безопасността на AI„.
Амодей също подкрепи строгия контрол върху износа на чипове за Китай. Той изрази опасения, че подобни чипове могат да дадат предимство на китайската армия.
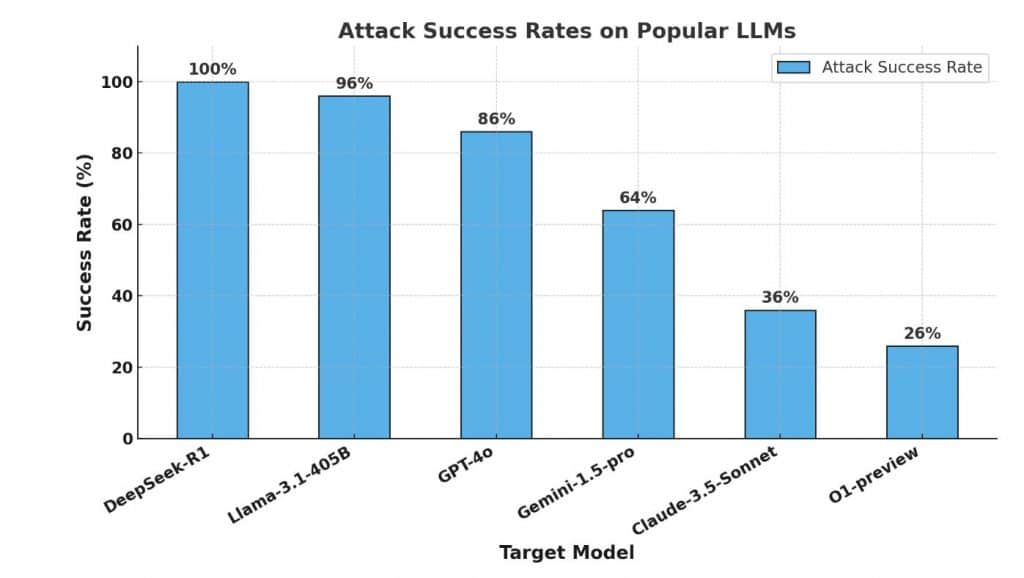
Междувременно изследователи по сигурността на Cisco по-рано казаха, че DeepSeek-R1 не е успял да блокира нито една злонамерена подкана в тестовете за сигурност, постигайки 100% успеваемост на джейлбрейка. По този начин моделът генерира злонамерена информация за киберпрестъпления и други незаконни дейности. Въпреки това, модели като Llama-3.1-405B на Meta и GPT-4o на OpenAI също са демонстрирали високи резултати, съответно 96% и 86%.
Компанията за киберсигурност KELA също разкри, че е успяла да хакне DeepSeek-R1, за да създаде злонамерени изходни данни. Например, методът „Evil Jailbreak“ експлоатира модела, насърчавайки го да приеме ролята на „зла“ личност, свободна от етични или други ограничения. Изследователите отбелязват, че DeepSeek-R1 е подобен на ChatGPT, но е значително по-уязвим.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
