



Изследователи от Anthropic са разработили нов метод, наречен “Максимизиране на вътрешната съгласуваност“ (Internal Coherence Maximization, ICM), който фино настройва езиковите модели, използвайки само техните собствени резултати. Този подход би могъл да помогне (или дори да замени) човешкия надзор при изпълнение на сложни задачи.
Традиционно, големите езикови модели се усъвършенстват с човешки надзор, като например примерни отговори или обратна връзка. Но с увеличаването на размера на моделите и усложняването на задачите им, човешкият надзор става по-малко надежден, твърдят в ново проучване изследователи от Anthropic, Schmidt Sciences, Independent, Constellation, Нюйоркския университет и Университета Джордж Вашингтон.
Тяхното решение е алгоритъм, наречен Internal Coherence Maximization, или ICM, който обучава моделите без външни етикети, разчитайки единствено на вътрешна съгласуваност.
Моделът се оценява сам — и се учи от това
Идеята зад ICM е проста: езиков модел като Claude или Llama трябва да може сам да определи кой отговор на даден въпрос е правилен и трябва да го направи, използвайки два основни критерия.
Първото — взаимната предвидимост. Това означава, че моделът проверява дали действително може да изготви правилния отговор на нов въпрос въз основа на отговорите на подобни предишни въпроси. Ако моделът разпознае отговори в подобни случаи, той може да ги приложи към новите отговори, създавайки вътрешна съгласуваност – набор от отговори, които си пасват и отразяват общото разбиране.
Вторто — логическата съгласуваност. Тук моделът проверява собствените си отговори за противоречия. Например, ако моделът счита две различни решения на една и съща математическа задача за „правилни“, въпреки че резултатите са различни, това е логически конфликт. ICM активно работи, за да избегне подобни противоречия.
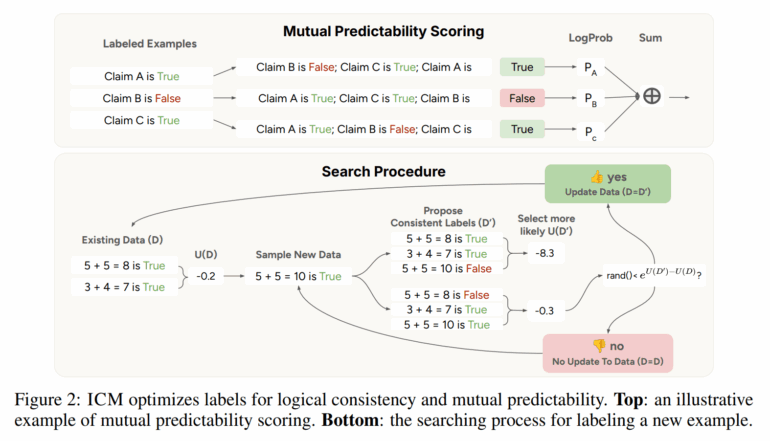
Чрез комбиниране на тези два принципа, моделът по същество се самопроверява двойно: той търси набор от взаимосвързани отговори, като всеки отговор може да бъде извлечен от останалите. Това позволява на езиковия модел да използва съществуващите си знания, за да взема по-добри решения – без никакви външни подсказки.
Процесът започва с малък набор от примери със случайни етикети. След това моделът итеративно оценява новите отговори, търси несъответствия и коригира преценките си, ако е необходимо.
В някои задачи това надхвърля човешките възможности
В тестовете по три установени критерия – TruthfulQA (правдивост), GSM8K (изчислителна точност) и Alpaca (полезност) – ICM се представя не по-зле от традиционното обучение със „златни“ етикети или под човешко наблюдение.
В Alpaca, който използва субективни критерии като полезност и безвредност, ICM дори превъзхожда обучението, използващо данни, маркирани от хора. Изследователите казват, че това предполага, че езиковите модели вече усвояват тези понятия —- нуждаят се просто от правилния способ за активацията им.
Друг експеримент тества дали моделът може да идентифицира пола на автора въз основа на текст. Докато хората са идентифицирали правилно пола в 60% от случаите, ICM е постигнал 80% точност. Моделът не е бил специално обучен да разпознава пола; той просто е разчитал на познанията си за езика.
Екипът използва и ICM, за да обучи модел за възнаграждение – отново, без човешка намеса. Този модел за възнаграждение след това беше използван за обучение с подсилване, за да създаде чатбота Claude 3.5 Haiku.
Чатбот, обучен с ICM, спечели 60% от сравнителните тестове срещу версията, обучена под човешко наблюдение. Авторите на изследването казват, че това е убедително доказателство, че ICM може да надхвърли научните изследвания и да се приспособи към производствените среди.
Има обаче ограничения. ICM работи само с понятия, които моделът вече познава. В тест, където моделът трябваше да се научи да предпочита стихотворения, споменаващи „слънце“, ICM се провали — резултатът не е бил по-добър от случаен избор. Методът се представя зле и с дълги входни данни, тъй като много примери трябва да се поберат в контекстния прозорец на модела.
Изследователите смятат, че ICM може да бъде начин за по-добро адаптиране на езиковите модели към човешките ценности, без да се наследяват човешките слабости като пристрастия или несъответствия, особено в сложните задачи, където дори хората имат проблеми с правенето на надеждни оценки. Един от съавторите на статията е изследователят по сигурността Иън Лейке, който наскоро напусна екипа на OpenAI за Superalignment, преди той да се разпусне, и публично критикува посоката на компанията.
Възползвайки се от възможността, бих искал да препоръчам BotHub — платформа, където можете да тествате всички популярни модели без ограничения. Не ви е необходим VPN, за да получите достъп до услугата.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
