


На 1 май Ask.com – една от първите уеб търсачки, стартирала преди почти 30 години прекрати дейността си. Това събитие изглежда символично: заедно с Ask приключва още една глава от историята на ранния интернет – епохата на експериментите, амбициите и споровете за това как точно човек трябва да взаимодейства с информацията.
Пътят от първите ръчни каталози до съвременните интелигентни търсачки беше дълъг и труден. Той мина през опити за ръчно структуриране на интернет, през появата на автоматизираното индексиране, борбата за релевантност и създаването на алгоритми за класиране, които промениха самия принцип на достъпа до знания. В тази статия ще се върнем към корените на интернет търсенето, ще разгледаме ключовите етапи от неговото развитие и ще проследим как са еволюирали не само технологиите, но и самият начин, по който хората търсят и намират информация.
От ръчните каталози до първите опити за систематизиране на интернет
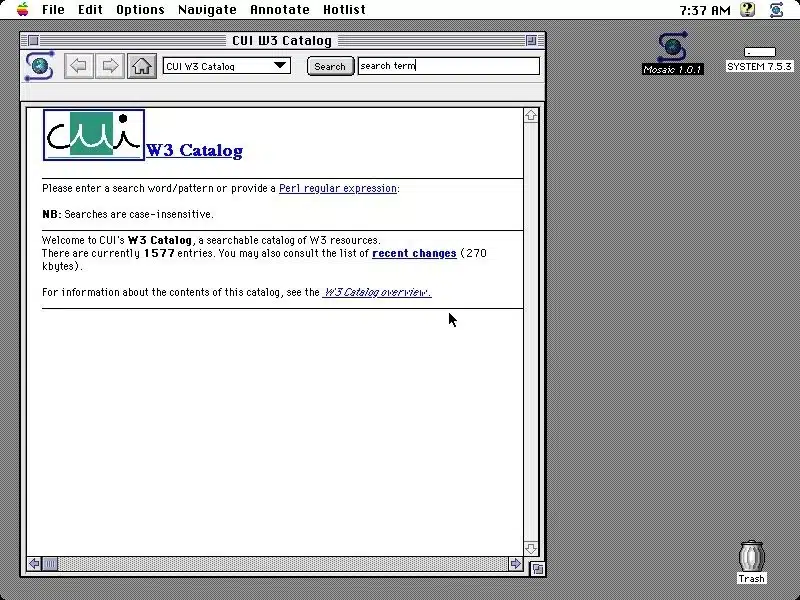
Необходимостта от структуриране на интернет възникна почти веднага след началото на масовото му използване. Още преди появата на големите търговски играчи ентусиастите се опитаха да създадат системи, които да помогнат за ориентирането в новата цифрова среда. Един от първите такива проекти беше W3Catalog (1993) – фактически първият уеб каталог. Той обединяваше вече съществуващите списъци със сайтове, опитвайки се да събере разпръснатите ресурси на едно място. Това беше ранен опит да се направи карта на „Световната паяжина“, която тогава все още се състоеше от сравнително малък брой страници.
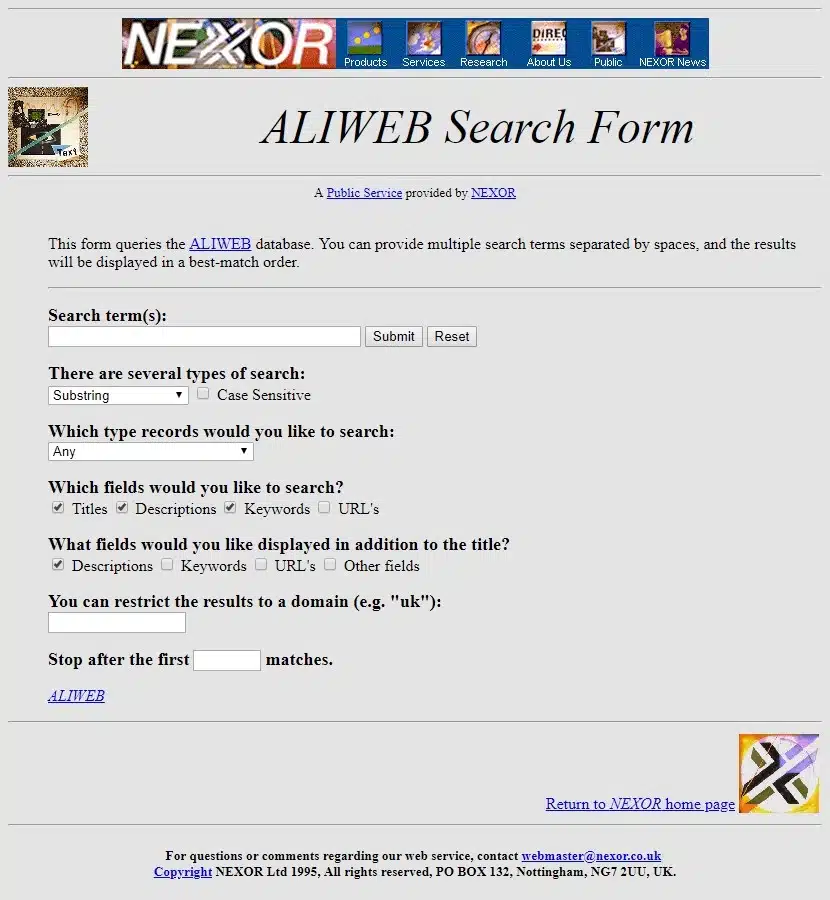
Успоредно с това се появяват и първите автоматизирани инструменти за търсене. През 1993 година стартира ALIWEB – една от първите системи, която позволяваше на собствениците на сайтове самостоятелно да подават информация за индексиране. Малко по-късно се появяват услуги, които вече използват уеб роботи за събиране на данни, по-специално JumpStation, който съчетава краулер, индексация и интерфейс за търсене. Тези проекти поставят техническата основа на бъдещите търсачки, въпреки че все още не могат напълно да се справят с мащаба на мрежата.
На този фон, на вчерашния ден през 1994 година беше създаден Yahoo!, който в началото беше именно каталог и се наричаше Jerry and David’s Guide to the World Wide Web. Неговите създатели ръчно подбираха и систематизираха сайтовете по теми, създавайки подредена структура, подобна на библиотечната класификация. Докато интернет оставаше сравнително малък, този модел работеше: човешката модерация гарантираше качеството и определено ниво на доверие, но търсенето на необходимата информация в каталога можеше да отнеме часове. Първо трябваше да разберете коя точно категория ви е нужна, след това да прегледате десетките сайтове и стотиците страници в нея, надявайки се, че на някой от тях ще намерите нужната ви информация. При това не трябва да забравяме и скоростта на интернет връзките по онова време. Това беше дълго и мъчително и много напомняше търсенето в реална офлайн библиотека.
Освен това бързото разрастване на мрежата бързо извади на преден план основното ограничение на каталозите – те не можеха да се мащабират. Броят на новите страници нарастваше всеки ден, а ръчното сортиране вече не успяваше да следва темпото на развитие на интернет. Именно тази разлика между скоростта на нарастване на информацията и възможностите на човека да я систематизира се превърна в тласък за появата на пълноценни автоматизирани търсачки, които скоро промениха правилата на играта.
Първите търсачки и проблемът с качеството на резултатите
След ерата на каталозите интернет започна бързо да преминава към нов подход – търсене не по теми, а по съдържание на страниците. Докато каталозите се опитваха да систематизират интернет ръчно, новото поколение системи работеше с идеята за автоматично търсене по текст.
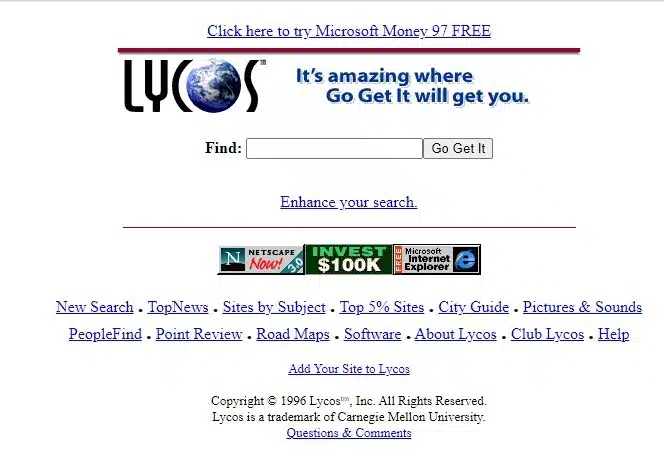
В средата на 90-те години се появяват първите истински търсачки, които вече не разчитаха на ръчна модерация. Сред тях са WebCrawler и Lycos. Те позволиха за първи път да се търси информация директно в текста на уебстраниците, а не само да се преминава през йерархията на каталозите. Интернет постепенно престана да бъде списък със сайтове и се превърна в система, където информацията можеше да се намира чрез текстови заявки.
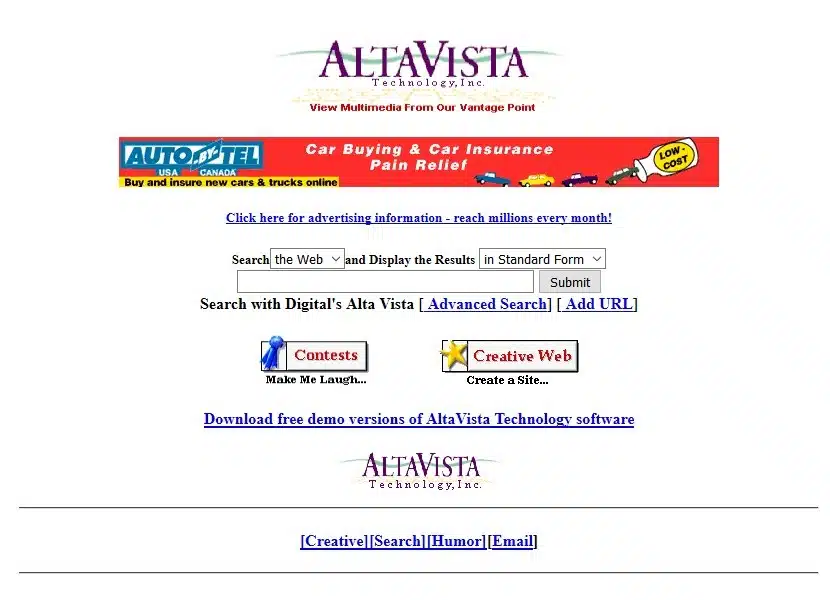
Следващата стъпка беше появата на AltaVista – една от най-мощните търсачки за своето време, която по-късно беше погълната от Yahoo!. Тя значително изпреварваше предшествениците си по скорост и мащаб на индексиране и позволяваше сложни заявки, което по онова време беше революционно. За първи път се появи усещането, че в интернет може да се намери почти всякаква информация. Разбира се, това не беше така, пропуските в индекса бяха огромни, но безспорно AltaVista беше голяма крачка напред в сравнение с каталозите. Търсенето на нужната информация вече не отнемаше часове, а 5-10 минути. Голям напредък!
Успоредно с това се развиваше и друг подход към търсенето – по-„човешки“. Ярък пример за това беше вече споменатият в началото Ask.com, който първоначално се наричаше Ask Jeeves. Платформата предлагаше опцията заявките да се формулират под формата на пълни въпроси. Това беше опит да се доближи търсенето до естествения език, но технологично то все още отстъпваше на бързите индексни системи.
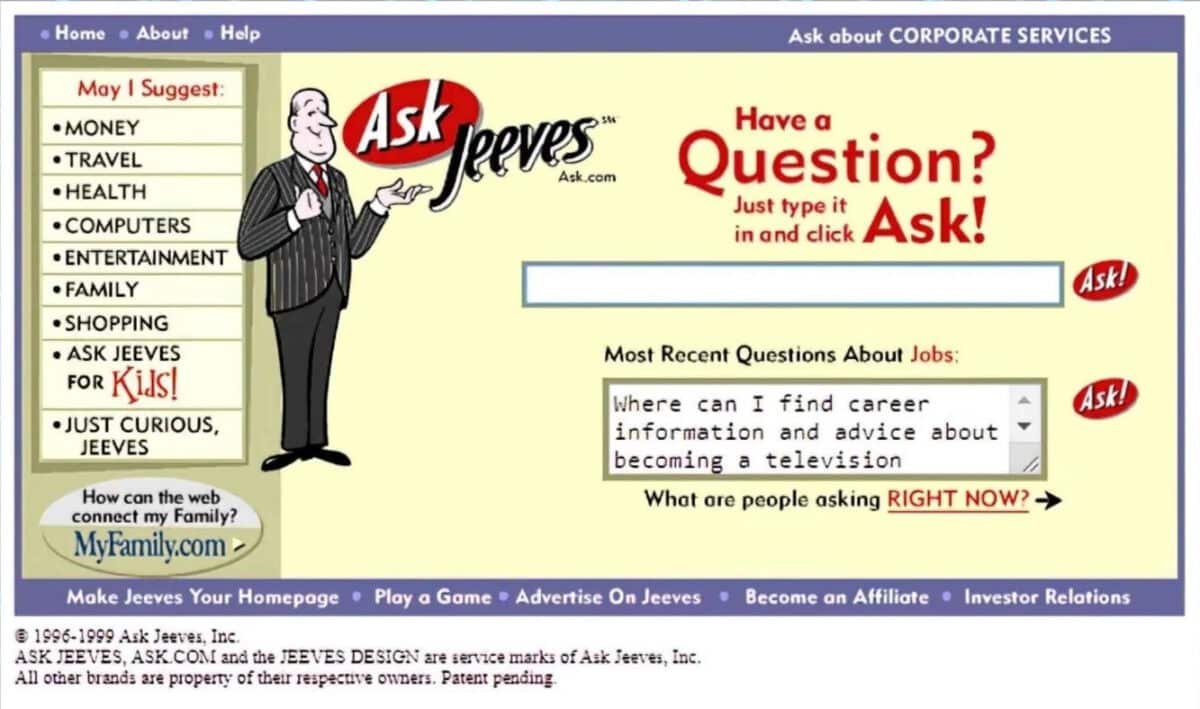
Въпреки това, заедно с разнообразието от търсачки възникна нов проблем – качеството на резултатите. Колкото повече страници се индексираха, толкова по-трудно ставаше да се определи кои от тях са наистина полезни.
Когато търсенето започна да отчита линковете
Класическите търсачки работеха по прост принцип: страницата е релевантна, ако съдържа нужните думи. Този принцип обаче бързо престана да работи. Мрежата започна да се пълни със страници, които се приспособяваха към заявките, повтаряха ключови думи и изкуствено се издигаха в резултатите от търсенето. Резултатът беше технически правилен, но практически безполезен.
Именно тук се появява нова идея: да се оценява не само съдържанието на страницата, но и мястото ѝ в структурата на целия интернет. Търсенето вече не се ограничаваше само с въпроса „има ли на страницата нужните думи?“, а го допълваше и с друг – „препращат ли други сайтове към тази страница?“. Отсега нататък значение имаха както текстът, така и авторитетът на ресурса в мрежата.
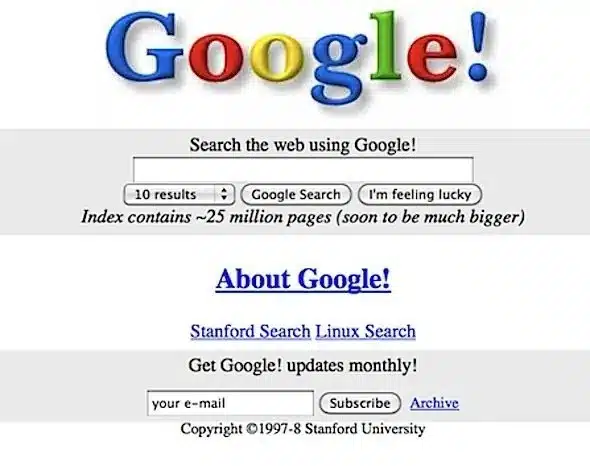
Този подход стана основа на алгоритъма PageRank, който лежи в основата на Google. Идеята беше радикална за своето време: препратките от една страница към друга се тълкуваха като своеобразни „гласове на доверие“. Колкото повече качествени сайтове препращат към дадена страница, толкова по-голяма е нейната значимост. За първи път релевантността престана да се определя само от текста и започна да зависи от целия интернет като мрежа от взаимосвързани документи.
На фона на тази промяна другите търсачки, включително AltaVista, които залагаха на мащаба и скоростта на индексиране постепенно започнаха да губят позиции. Оказа се, че обемът на данните не решава проблема с търсенето, ако няма механизъм, който да разбира тяхната тежест.
Войните в търсенето и алтернативите
След революцията в релевантността, която донесе Google, търсенето бързо се превърна в индустрия с един очевиден лидер. Google постави нови стандарти за скорост, точност и съответствие на резултатите и постепенно се превърна в доминиращ играч на глобалния пазар. Но заедно с това започна ерата на алтернативите – както технологични, така и регионални.
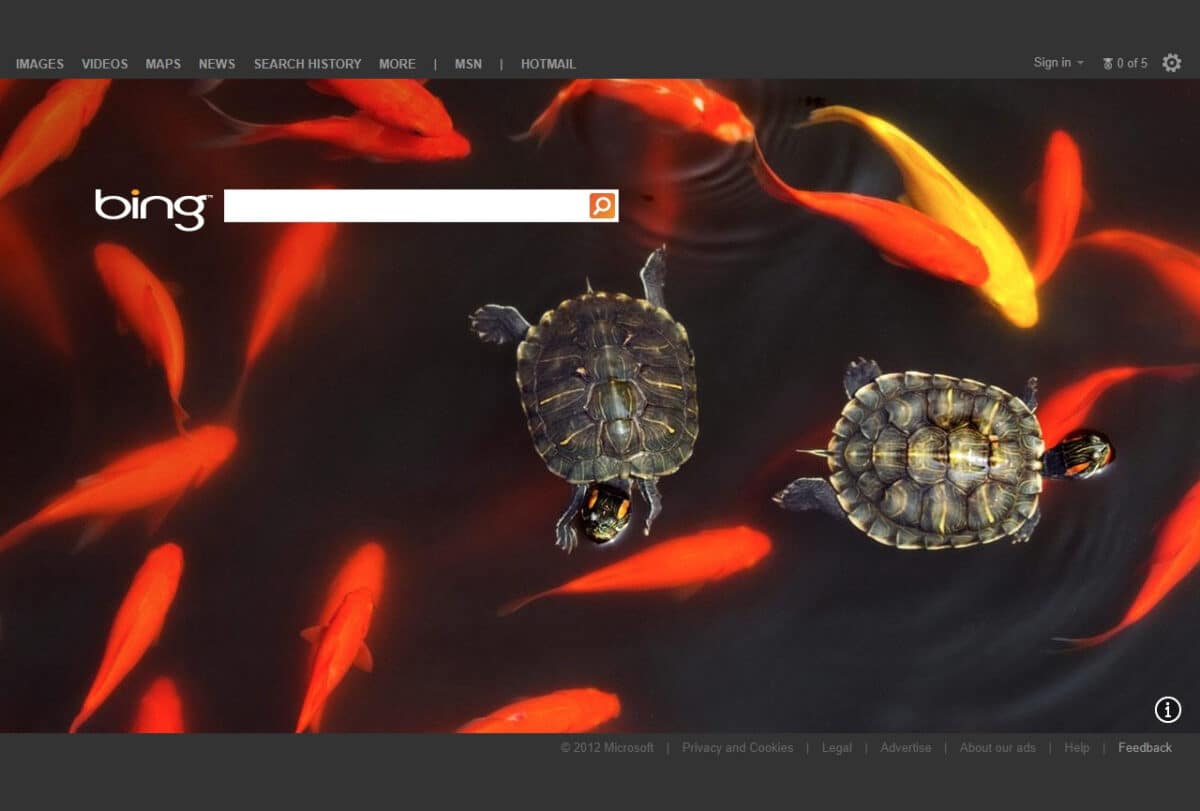
Един от най-известните опити за конкуренция беше Bing от Microsoft. Той се разви от предишни инициативи на компанията в областта на търсенето, първоначално MSN Search, а по-късно Windows Live Search и се превърна в опит за напълно преосмисляне на ролята на търсенето в екосистемата на Microsoft. Bing заложи на дълбока интеграция с Windows и по-визуален, интерактивен подход към представянето на резултатите: по-конкретно, на началната страница се появиха големи ежедневни фонови изображения, които трябваше да превърнат търсенето в по-контекстуално и емоционално ангажиращо преживяване, както и да го отличат визуално от минималистичния дизайн на Google. Въпреки значителните ресурси на Microsoft, вложени в този проект, Bing така и не успя да промени съществено баланса на силите, но се утвърди като втората по мащаб търсачка в света с 5% от търсенията срещу 90% за Google.
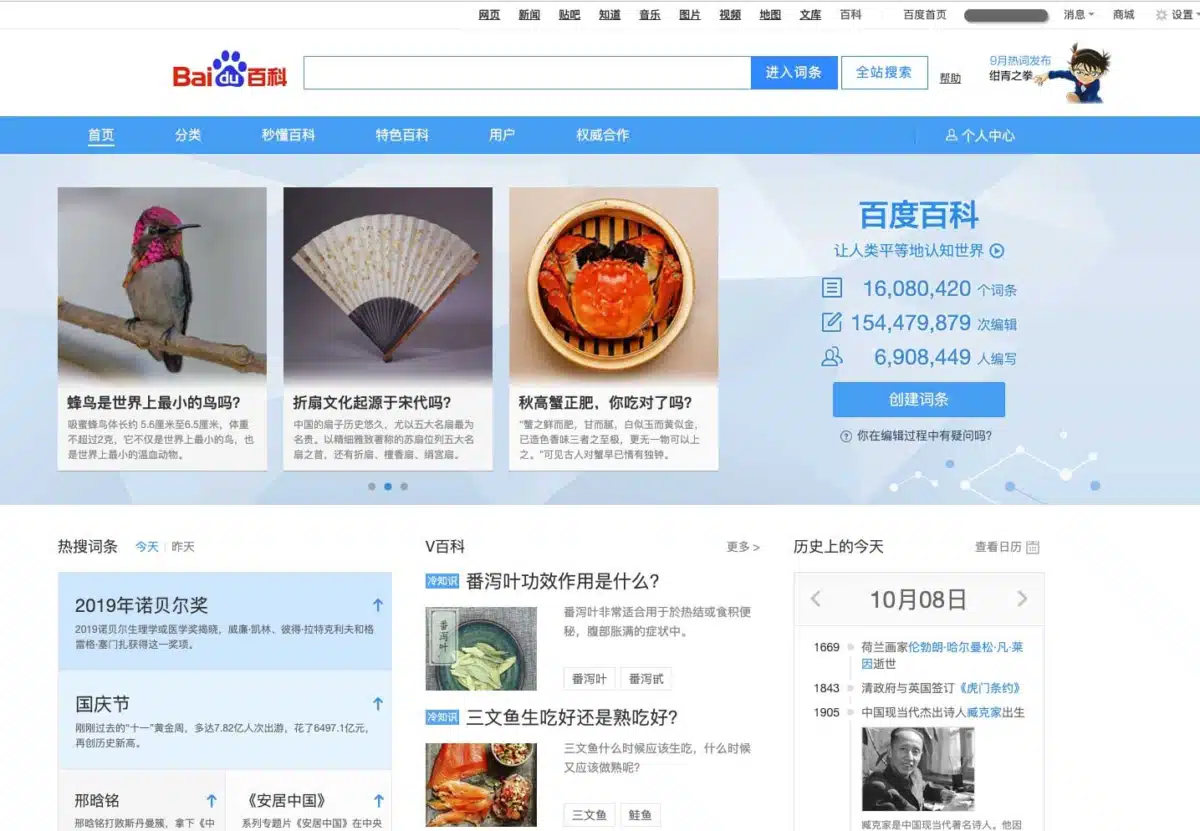
Китай се превърна в отделен център за развитие на търсенето, като там доминираща позиция зае Baidu, местният аналог на Google. За разлика от западния пазар, където съществува относителна отвореност, в Китай търсенето се развиваше като част от затворена цифрова екосистема, което още повече засили ролята на Baidu като основен инструмент за достъп до информация.
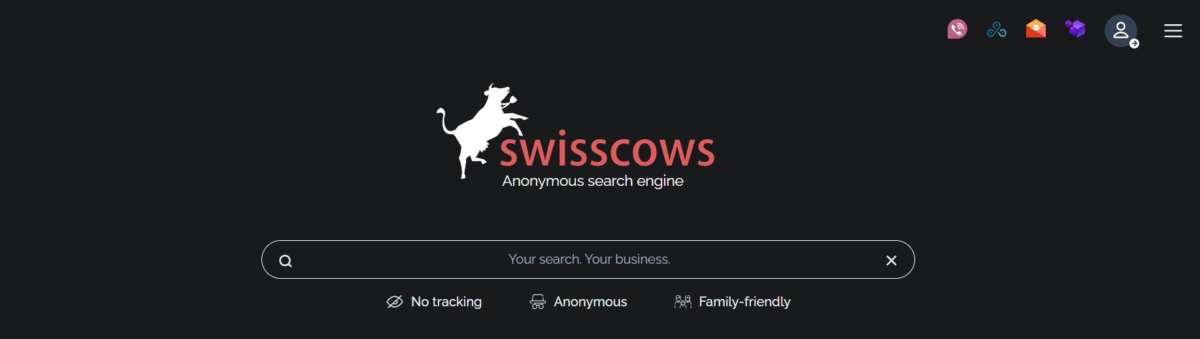
Наред с глобалните играчи съществуват и алтернативни търсачки, които се опитват да преосмислят не мащаба, а принципите на работа.
DuckDuckGo залага на поверителността и липсата на проследяване на потребителите. Startpage предоставя резултати от Google, но без да събира лични данни. Swisscows се фокусира върху безопасно, филтрирано търсене, ориентирано към семейната аудитория. Тези проекти показват, че търсенето може да се развива не само чрез доминиране, но и чрез различни подходи към етиката и поверителността.
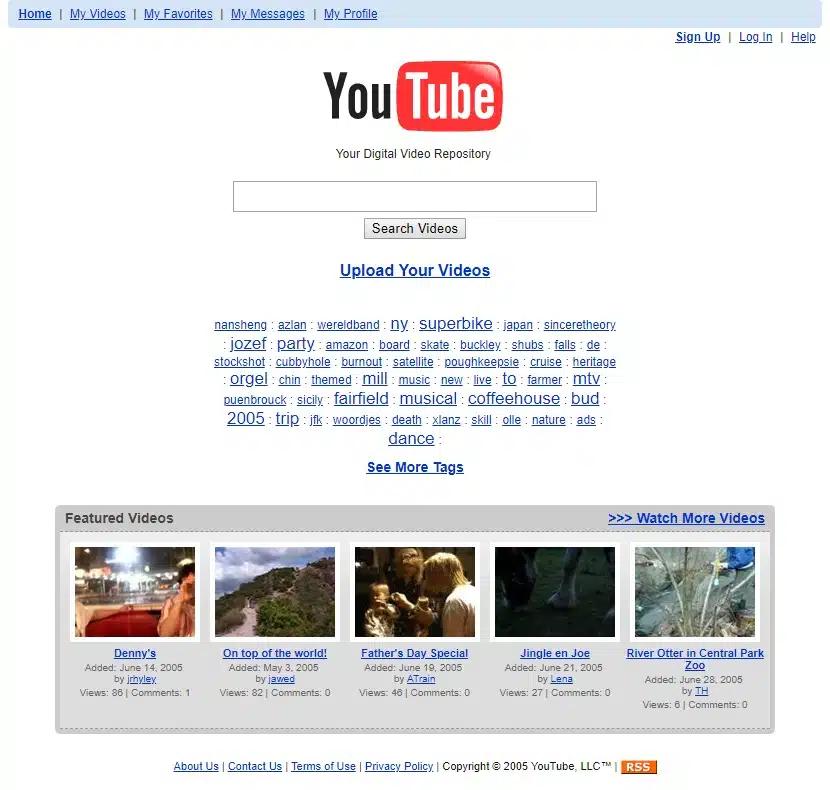
С течение на времето интернет започна да се разделя на отделни среди, а с това и търсенето се раздели на специализирани направления. Вместо един списък с резултати се появиха вертикални търсачки – отделни инструменти за изображения, видео, новини, продукти и локално съдържание. Търсенето вече не беше монолитно, а се превърна в набор от различни интерфейси за различни видове информация.
Тази тенденция се засили особено в рамките на големите платформи. YouTube, социалните мрежи – всяка от тези системи фактически създаде свой собствен механизъм за търсене, който работи в рамките на затворена екосистема. В резултат на това потребителите все по-често започнаха да търсят нещата, от които се нуждаят, не чрез класическите търсачки, а директно в тези услуги, където се намира съдържанието. Търсенето се раздели на десетки отделни среди, всяка със свои собствени правила, алгоритми и логика на извеждане на резултатите.
Следващата стъпка беше опитът отново да се обедини този разпокъсан опит, но вече на ново ниво. Търсачките започнаха да преминават от простото намиране на страници към разбиране на намерението на потребителя. Вместо списък с линкове се появяват обобщени отговори, семантичен анализ и контекст.
Днес този процес се засилва още повече с появата на AI моделите. Търсенето все по-често прилича не на списък с резултати, а на диалогова система, която формира пряк отговор. Това променя самата същност на взаимодействието с информацията: вместо да преминава от страница на страница, потребителят получава обобщен и интерпретиран отговор веднага. Понякога грешен отговор.
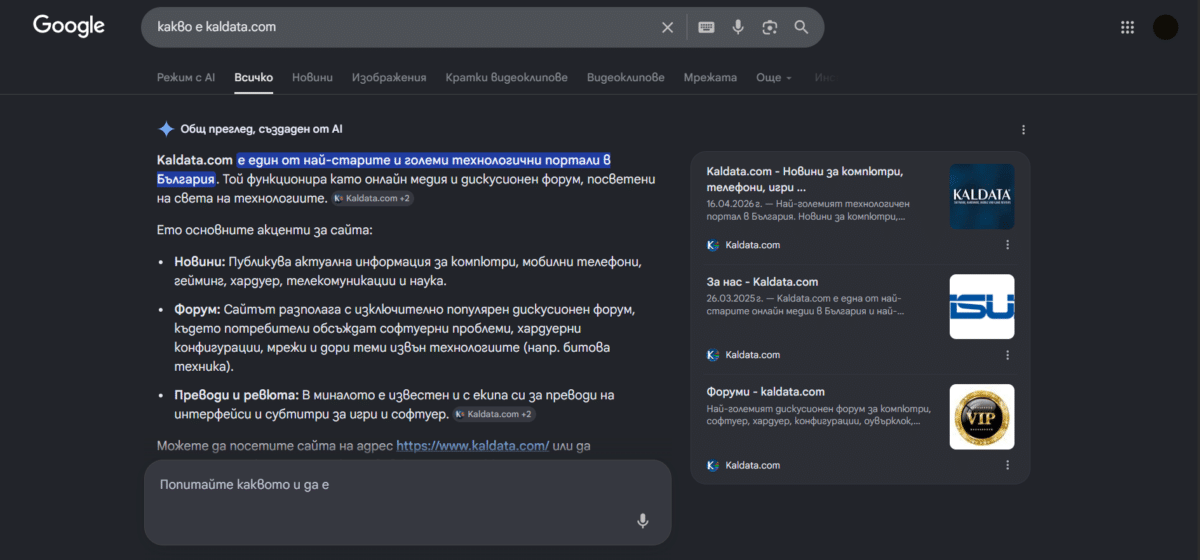
По този начин търсенето е направило пълна обиколка – от универсален списък с уебстраници към фрагментирани вертикали и отново към опит да се обедини всичко в единна интелигентна система, която вече не просто намира информация, а я обяснява.
Всичко започна с каталозите – първите опити да се систематизира все още малкият и хаотичен интернет, където сайтовете се подреждаха ръчно по теми, като в цифрова библиотека. Днес търсенето променя своята същност. Вместо списъци с връзки се предлагат обобщени отговори, семантично разбиране на заявките и AI системи, които формират резултата директно. Търсенето постепенно се превръща от навигатор в интернет в система, която формира отговори. Ако преди търсехме страници, а след това – информация, то сега все по-често получаваме готов отговор. И в това има известна ирония: Ask.com, една от първите търсачки, която се опита да изгради взаимодействие с потребителите чрез въпроси изчезна точно тогава, когато цялата индустрия най-накрая стигна до тази точка.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
