



Много малките езикови модели (SLM) могат да надминат водещите големи езикови модели (LLM) в задачите за разсъждение, според ново проучване на Shanghai Artificial Intelligence Lab. Авторите показват, че с правилните инструменти и техники за мащабиране по време на тестването, SLM с 1 милиард параметри може да надмине LLM 405B при сложни математически тестове.
Способността да се използва SLM в сложните задачи за логическо мислене може да бъде много полезна, тъй като фирмите търсят нови начини за прилагане на тези нови модели в различни среди и приложения.
Мащабирането по време на тестовете (TTS) —- процесът по предоставяне на LLM на допълнителни изчислителни ресурси по време на логически извод, за да се подобри тяхната производителност при изпълнение на различни задачи. Водещи модели за логически изводи като OpenAI o1 и DeepSeek-R1 използват „вътрешен TTS“, което означава, че са обучени да „мислят“ бавно чрез генериране на дълга последователност от токени за верига на мисълта (CoT).
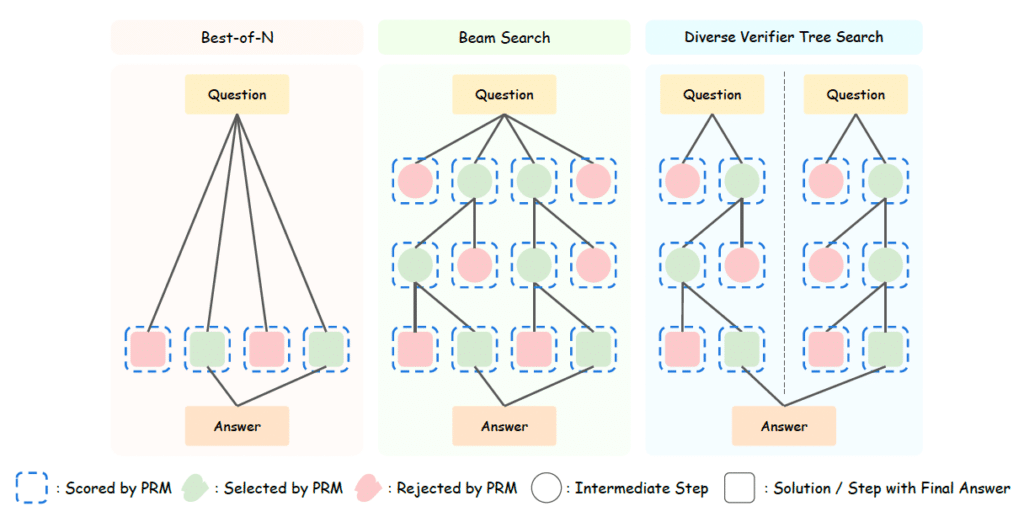
Алтернативен подход се явява „външен TTS“, където производителността на модела се подобрява (както подсказва името) външно. Външният TTS е подходящ за пренасочване на съществуващите модели за решаване на проблеми с разсъжденията без допълнително фино настройване. Външната настройка на TTS обикновено се състои от „модел на политиката“, който е основният LLM, генериращ отговора и моделите на възнаграждение на процеса (PRM), който оценява отговорите на модела на политика. Тези два компонента са свързани заедно чрез метод за избор или търсене.
Най-простата настройка — това е „best-of-N“, където моделът на политика генерира множество отговори и PRM избира един или повече най-добри отговори, за да формира крайния отговор. По-усъвършенстваните външни TTS методи използват търсене. При “търсене по лъч“ моделът разделя отговора на няколко етапа.
На всеки етап той избира няколко варианта за отговор и ги пуска през PRM. След това избира една или повече съвпадащи опции и генерира следващата стъпка от отговора. А при „търсене по множество варианти на отговор“ (DVTS) моделът генерира няколко варианта за отговор, за да създаде по-разнообразен набор от възможни отговори, преди да ги комбинира в окончателен отговор.
Изборът на правилната стратегия за преобразуване на текста в реч зависи от много фактори. Авторите на изследването са провели систематично приучване на това, как различните модели на политики и софтуерни решения влияят върху ефективността на методите за преобразуване на текст в реч.
Техните резултати показват, че ефективността зависи до голяма степен от политиките и моделите на PRM. Например, за малки модели на политики, методите, базирани на търсене, превъзхождат метода “най-доброто от N“. За големите модели на политики обаче последният метод е по-ефективен, тъй като моделите имат по-добри възможности за логическо разсъждение и не се нуждаят от модел на възнаграждение за проверка на всяка стъпка от логическото разсъждение.
Техните резултати също показват, че правилната TTS стратегия зависи от сложността на задачата. Например, за малките модели на политики с по-малко от 7 милиарда параметъра, методът “най-доброто от N“ е по-подходящ за прости проблеми, докато методът за “най-добро търсене“ е по-подходящ за по-сложните проблеми. За модели на политики със 7 до 32 милиарда параметри, “разнообразно търсене по дърво“ е много подходящ за прости и средни проблеми, докато методът “най-добро търсене“ е подходящ за сложните проблеми. Но за големите модели на политики (72 милиарда параметъра или повече) методът “най-доброто от N“ е оптимален за всички нива на сложност.
Въз основа на тези резултати разработчиците могат да проектират изчислително оптимални TTS стратегии, които вземат предвид модела на политиката, PRM и сложността на проблема, за да използват най-добре изчислителните ресурси за решаване на логически задачи.
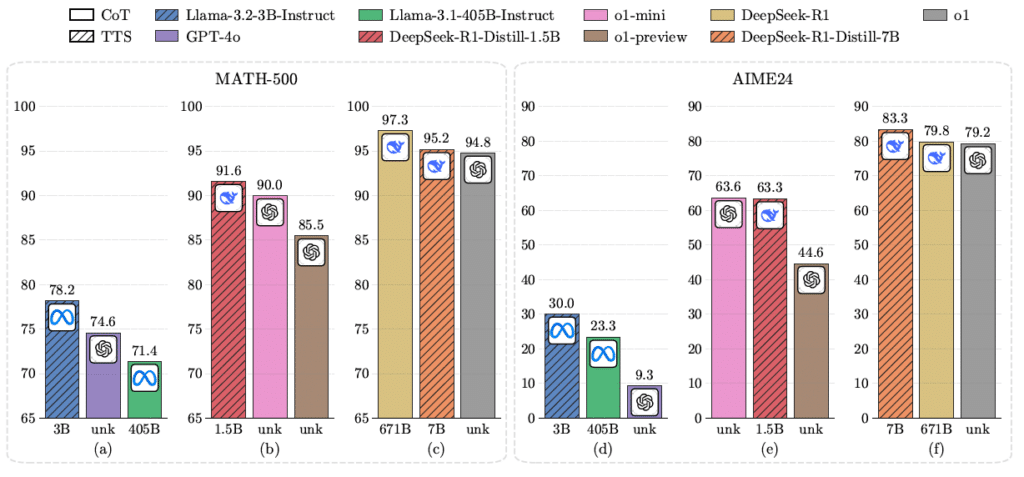
Например, изследователите откриха, че моделът Llama-3.2-3B, с изчислително оптимална TTS стратегия, превъзхожда Llama-3.1-405B по показателите MATH-500 и AIME24 в два сложни математически теста. Това показва, че SLM може да надмине модел, който е 135 пъти по-голям, когато използва оптимална за изчисленията TTS стратегия.
В други експерименти са открили, че моделът Qwen2.5 с 500 милиона параметъра може да надмине GPT-4o при правилната стратегия за синтез на речта, която е оптимизирана за изчисления. Използвайки същата стратегия, версията с 1,5 милиарда параметъра на DeepSeek-R1 надмина o1-preview и o1-mini на тестовете MATH-500 и AIME24.
Като се вземат предвид разходите за обучение и изводите, резултатите показват, че при използване на стратегии за мащабиране и когато са оптимизирани за изчисляване, SLM могат да надминат по-големите модели със 100–1000 пъти по-малко операции с плаваща запетая.
Резултатите от изследването показват, че TTS с оптимално изчисление значително подобрява способността за логическо разсъждение на езиковите модели. Въпреки това, с увеличаване на размера на модела, TTS постепенно губи ефективност.
„Това предполага, че ефективността на TTS е пряко свързана със способността на модела за политика да разсъждава логично“ — пишат изследователите. „По-специално, за модели със слаби логически способности за мащабиране, изчисленията по време на тестовете водят до значително подобрение, докато моделите със силни логически способности за извод са ограничени.“
Проучването потвърждава, че SLM могат да работят по-добре от по-големите модели, когато използват методи за мащабиране на времето за тестване и оптимизиране на изчисленията. Въпреки че това проучване се фокусира върху тестовете по математика, изследователите планират да го разширят до други задачи, които изискват логическо мислене, като програмиране и химия.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
