


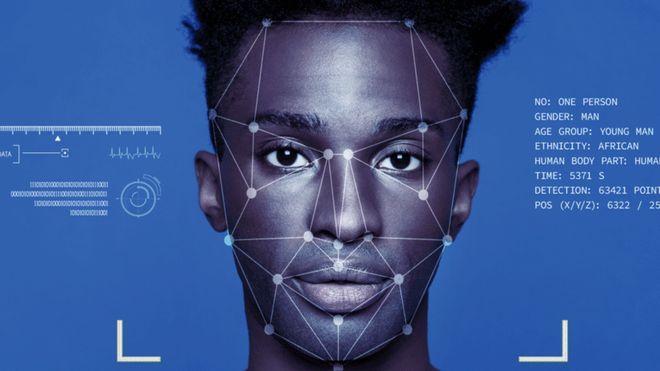

Проучване на правителството на САЩ предполага, че алгоритмите базиране на изкуствен интелект за разпознаване на лица далеч не са толкова точни при идентифицирането на афро-американци и азиатци в сравнение с кавказките лица.
Според доклада, алгоритмите са по-склонни да разпознават погрешно афро-американските жени.
Тук отново се повдигат въпроси дали е редно технологиите за лицево сканиране и разпознаване трябва да се използват от правителството и правоприлагащите органи.
Един критик нарече резултатите „шокиращи“.
Националният институт за стандарти и технологии на САЩ (Nist) тества 189 алгоритъма от 99 разработчици, включително и от топ компании като Intel, Microsoft, Toshiba и китайските компании Tencent и DiDi Chuxing.
Съгласуване едно към едно
Amazon, която продава системата си за разпознаване на лица Rekogservation на американските полицейски сили не изпрати своята технология за преглед и отказа коментар.
Гигантът в продажби на дребно по-рано нарече проучване от Масачузетския технологичен институт „подвеждащо“. Този доклад предполага, че анализът на ефективността на разпознаването на жени от чернокож произход е бил некачествен.
При съпоставяне на конкретна снимка на едно лице с друга на друго лице, много често алгоритмите фалшиво идентифицират лицата от афро – американски произход.
Конгресменът Бени Томпсън, председател на Комитета за вътрешна сигурност на САЩ, заяви пред Ройтерс: „Администрацията трябва да преоцени своите планове за технология за разпознаване на лица в светлината на тези шокиращи резултати“.
Компютърният учен и основател на Алгоритмичната лига на справедливостта Джой Буоламини нарече доклада „изчерпателен опровержение“ за тези, които твърдят, че пристрастията в софтуера за изкуствен интелект не са проблем.
Алгоритмите в изследването на Nist бяха тествани за два вида грешки:
- фалшиви позитиви, когато софтуерът грешно счита, че снимките на двама различни лица показват един и същи човек
- фалшиви негативи, при които софтуерът не успява да съвпадне на две снимки, които показват едно и също лице
Софтуерът използва снимки от бази данни, предоставени от Държавния департамент, Министерството на вътрешната сигурност и ФБР, без изображения от социални медии или видеонаблюдение.
„Въпреки че обикновено е неправилно да се правят изявления за алгоритмите, ние открихме емпирични доказателства за съществуването на демографски разлики в по-голямата част от алгоритмите за разпознаване на лица, които проучихме“, казва Патрик Гротер, компютърният учен от Nist и основният автор на доклада.
„Резултатите не отразяват нашите продукти, тъй като те преминават през задълбочени тестове преди да излязат на пазара. Ето защо всичките ни търговски решения отчитат висока степен на точност“, заяви говорител пред BBC.
Няколко американски града, включително Сан Франциско и Оукланд в Калифорния и Сомървил, Масачузетс, забраниха използването на технология за разпознаване на лица.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
