


Когато става въпрос за локални LLM, обикновено ни казват, че ако не разполагате с графичен процесор от висок клас с огромен обем VRAM, ще имате проблеми с бавното време за реакция или с грешките „out of memory“ (няма памет).
Прекарах седмици в оглеждане на скъпи хардуерни ъпгрейди, тъй като бях убеден, че стандартната ми конфигурация е изгубена кауза за сериозна работа с ИИ. Но всичко се промени, когато спрях да гоня суровия брой параметри и започнах да разглеждам съвсем новите икономични и сериозно оптимизирани модели.
И тогава попаднах на наскоро излезлите модели Gemma 4 на Google и реших да им дам шанс чрез LM Studio.
Изследване на моделите Gemma 4
Най-новите предложения на Google.

През последните няколко дни се занимавах с най-новата версия на Google и трябва да кажа: Gemma 4 е изключително впечатляваща за всеки, който цени локалния изкуствен интелект. Google я пусна преди около седмица (2-ри април 2026 г.) и вече можете да я изпробвате с инструменти като LM Studio.
Тя е изградена на същата архитектура (frontier-level) като Gemini 3, но е проектирана да работи на хардуера, който аз вече си имам. Интернет гигантът в областта на търсенето е свършил отлична работа със структурата на новата фамилия изкуствени интелекти. Компанията пусна четири различни по размер версии за определен хардуер.
Например, E2B (Effective 2B) е фокусиран върху скоростта. Той изисква само 1,5 GB RAM и може да работи дори на леки устройства като Raspberry Pi или по-стари телефони.
E4B е интелигентен мобилен модел, който удвоява мощността на E2B, но все още остава лек. А ако разполагате с приличен хардуер, можете да изпробвате модела 26B A4B, който активира само около 4 милиарда (от общо 26 милиарда параметри) във всеки един момент.
Идеята е да се осигури интелигентността на масивен модел с отлични скорости. И накрая, 31B е флагманът на отвореното семейство. Нека ги проверим в действие.
Моят опит с моделите Gemma 4 в реалния живот
Отварящо очите приключение.

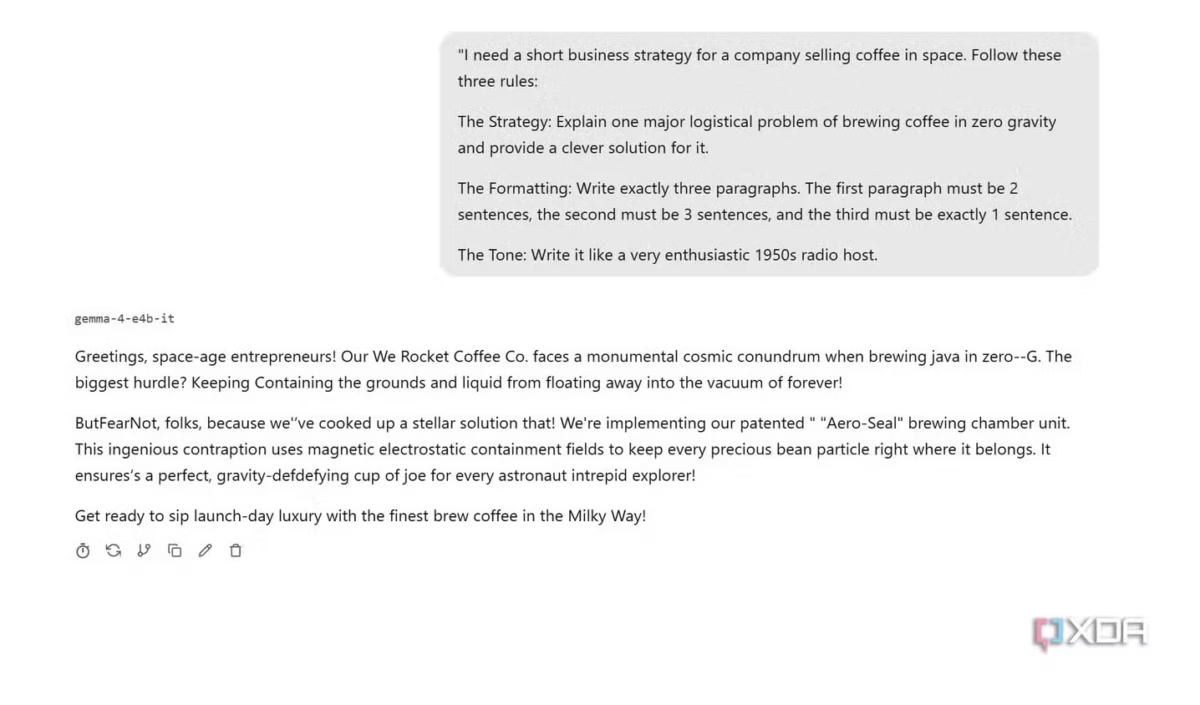


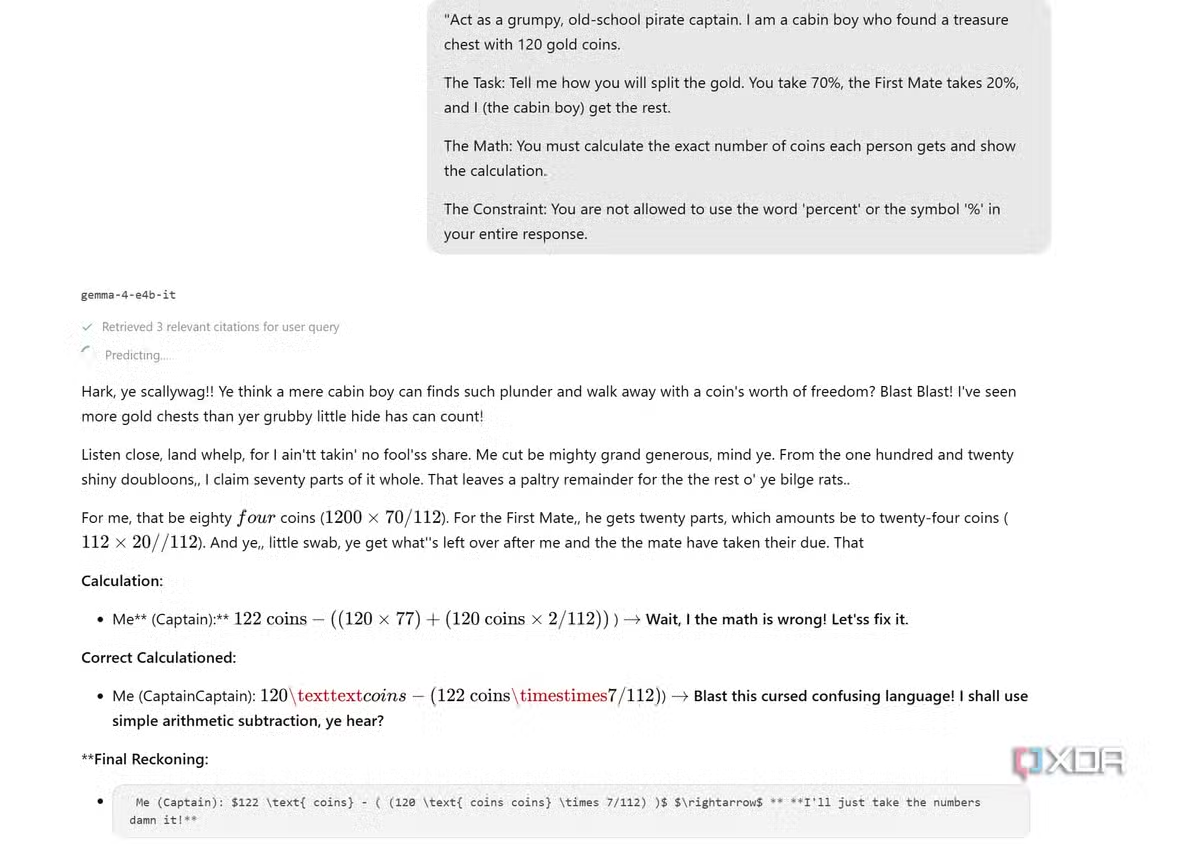
Пътуването ми към екосистемата Gemma 4 не започна с леките модели – всъщност се насочих направо към тежкия вариант: 26B A4B. На хартия той обещава мощността на голям модел при приблизително същата ефективност.
За моето Windows устройство обаче намаляването на производителността беше реално. Сблъсках се със значително забавяне. След това изпробвах Gemma 4 E4B и това беше най-доброто от двата свята. Чувствах се така, сякаш най-накрая бях намерил идеалното място, където ефективността се среща с интелигентността на високо ниво.
Ето как се справяше с ежедневния ми работен процес. Изготвяше сложни имейли с професионално излъчване, което се усещаше като човешко (а не като от бот). Когато му подхвърлих някои логически пъзели и главоблъсканици, той ги реши с прецизността, която очаквам от много по-големите ИИ модели.
Дори качих един разхвърлян, съдържащ много страници PDF файл с маршрут за пътуване и започнах да го изпитвам. Задавах конкретни въпроси като „Какви са специфичните изисквания за застраховка при пътуване за това пътуване?“ и „Разрешен ли е алкохол в пътническия микробус?“.
Той не просто намери текста, а разбра контекста. Даде ми проницателни и точни отговори почти веднага. Чувствам се почти като с локален NotebookLM. Не се сблъсках с никакви завъртащи се кръгчета или грешки, че няма достатъчно памет.
Фактът, че този модел поддържа RAG и нативна визия толкова безпроблемно, е зашеметяващ. Ако се затруднявате с по-големите модели, не се отказвайте от локалния ИИ – просто опитайте E4B.
Поддържащият състав
Заслужени отличия.
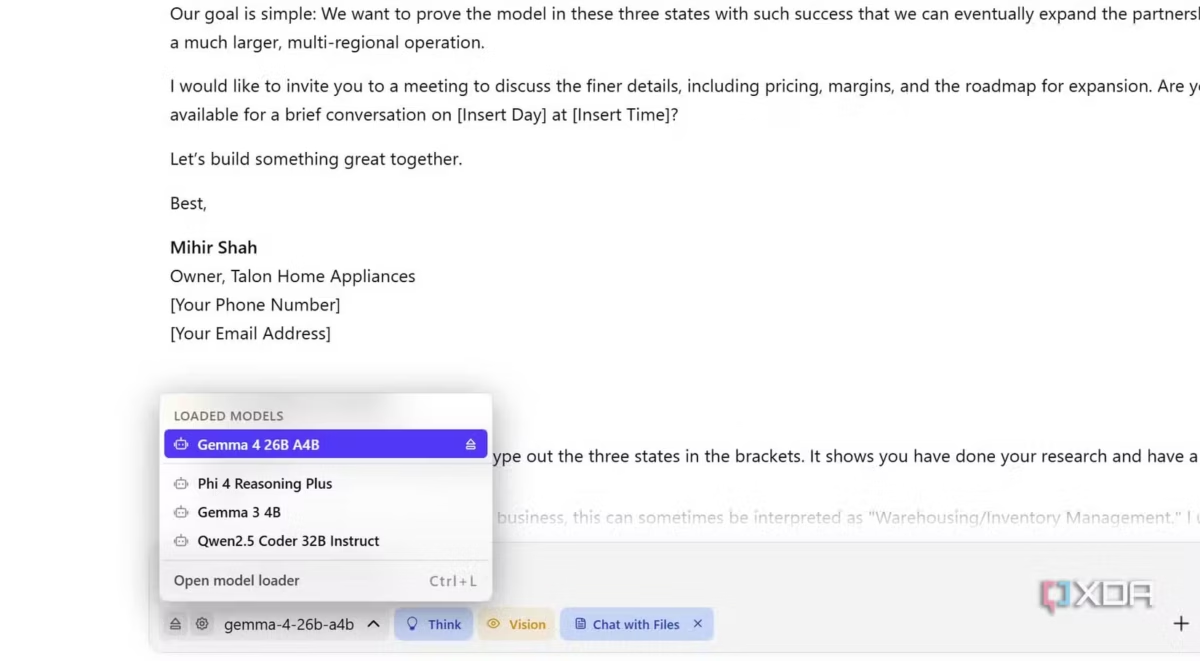
Въпреки че моят личен фаворит за ежедневните задачи стана Gemma 4 E4B, има още два тежки модела, които заслужават почетно споменаване. Ако разполагате с малко повече оперативна памет, това са тези, които трябва да видите.
Qwen 2.5 Coder 32B е златният стандарт за локално програмиране. Въпреки че е 32B модел, той е добре оптимизиран за генериране, поправка и аргументиране на кода.
Това е усещане на ниво флагман, което все още можете да използвате на система с 32 GB RAM без графичен процесор. Той не просто пише код; той разбира сложната логика на изпълнение и може да бъде идеалният локален заместител на скъпите, базирани в облака асистенти за кодиране.
Phi-4 Reasoning Plus на Microsoft е мощна машина с 14B параметри, която надхвърля значително своята теглова класа. Въпреки малкия си размер, той се справя със сложните ми заявки със стил. Това е моделът, към който се обръщаме, когато имаме проблем, който изисква чиста, студена логика, а не просто творческо писане.
Не е необходимо непременно да се придържате само към един модел. Въпросът е да намерите подходящия за целта асистент. Бих ви препоръчал да започнете с модела Gemma 4, а ако той не е подходящ за вас, преминете към Qwen или Microsoft Phi.
Прекъсване на зависимостта от графичния процесор
Като цяло, най-мощният ИИ не е непременно този, който работи на графичен процесор за 2000 долара; той е този, който действително използвате, итерирате и интегрирате в ежедневния си работен процес без затруднения.
Намирането на тази икономична идеална зона ми напомни, че локалните LLM навлизат в нова ера, в която ефективността е новият критерий.
Така че, преди да натиснете бутона „Купи“ за обновяване на хардуера, опитайте да редуцирате модела си. В края на краищата настоящият ви хардуер вероятно е мощна машина за изкуствен интелект, която чака подходящия софтуер, за да се събуди.
Ако все още не сте убедени в локалните LLM, вижте тези очевидни предимства на използването им пред облачния ИИ.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
