



По-големите модели могат да извършат по-голямо разнообразие от действия, но намалената дълбочина на по-малките модели ги прави много привлекателни инструменти.
Големите езикови модели работят добре, защото са наистина огромни. Най-новите модели на OpenAI, Meta и DeepSeek използват стотици милиарди параметри – регулируеми „бутони“, които определят връзките между данните и се променят по време на процеса на обучение. С повече параметри моделите са в състояние да идентифицират по-добре закономерностите и връзките, което от своя страна ги прави по-мощни и точни.
Но тази мощ си има своята цена. Обучението на модел със стотици милиарди параметри изисква огромни изчислителни ресурси. Така например, за да обучи своя модел Gemini 1.0 Ultra, Google е похарчила 191 милиона долара. Големите езикови модели (LLM) също така изискват значителна изчислителна мощност всеки път, когато отговарят на заявка, което ги прави пословично големи консуматори на енергия. По данни на Института за изследване на електрическата енергия една заявка към ChatGPT консумира около 10 пъти повече енергия от едно търсене в Google.
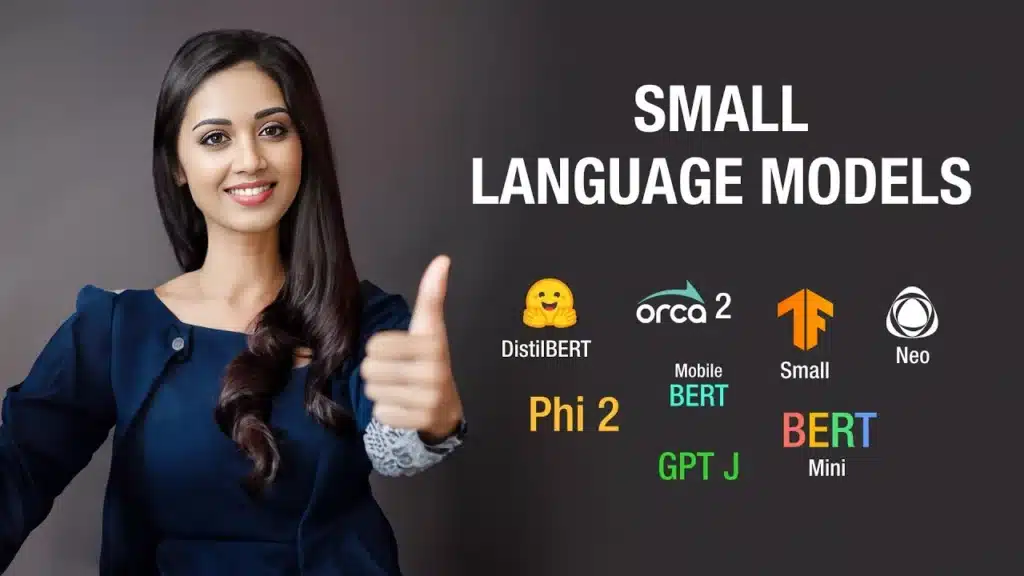
В отговор на това някои изследователи вече мислят за по-малки езикови модели. IBM, Google, Microsoft и OpenAI неотдавна пуснаха малки езикови модели (SLM – small language models), които използват само няколко милиарда параметъра – малка част от техните аналози LLM.
Малките модели не се използват като инструменти с общо предназначение, както техните по-големи братовчеди. Но те могат да се справят отлично със специфични, по-тясно дефинирани задачи, като например обобщаване на разговори, отговаряне на въпроси на пациентите в качеството на чатбот за здравни грижи и събиране на данни в смарт устройствата.
„За много задачи един модел с 8 милиарда параметри всъщност е доста добър“, казва Зико Колтър, компютърен учен в университета Карнеги Мелън.
Освен това те могат да работят на лаптопа или на мобилния телефон, вместо в един огромен център за данни. Няма консенсус за точното определение на „малък“, но всички нови модели от този тип имат максимален брой параметри около 10 млрд.
За да оптимизират процеса на обучение на тези малки модели, изследователите използват няколко трика. Големите модели често извличат сурови данни за обучение от интернет, а тези данни обикновено са дезорганизирани, разхвърляни и трудни за обработка. След това обаче тези големи модели могат да генерират висококачествен набор от данни, който може да се използва за обучение на един малък модел. Подходът, наречен „дестилация на знанията“, кара по-големия модел ефективно да предаде обучението си, подобно на учител, който дава уроци на ученик.
„Причината, поради която [SLM] се справят толкова добре с толкова малки модели и толкова малко данни, е, че те използват висококачествени данни вместо разхвърляни материали“, споделя Колтър.
Изследователите също така са търсили начини за създаване на малки модели, започвайки с големи модели, като постепенно ги съкращават. Един от методите, известен като „изрязване“, включва премахване на ненужните или неефективни части от невронната мрежа – разрасналата се мрежа от свързани данни, която е в основата на големия модел.
Изрязването е вдъхновено от реалната невронна мрежа – човешкия мозък, който повишава ефективността си чрез прекъсване на връзките между синапсите с напредването на възрастта. Днешните подходи за изрязване водят началото си от статия от 1989 г., в която компютърният учен Ян Лекун, сега в Meta, твърди, че до 90% от параметрите на една обучена невронна мрежа могат да бъдат премахнати, без да се наруши нейната ефективност. Той нарича метода „оптимално увреждане на мозъка“. Изрязването може да помогне на изследователите да прецизират един малък езиков модел за конкретна задача или среда.
За изследователите, които се интересуват от това как езиковите модели правят нещата, по-малките модели предлагат евтин начин за тестване на нови идеи. И тъй като те имат по-малко параметри от големите модели, техните разсъждения могат да бъдат по-прозрачни.
„Ако искате да създадете нов модел, трябва да опитате различни неща“, казва Лешем Чошен, учен-изследовател в лабораторията за изкуствен интелект MIT-IBM Watson. „Малките модели позволяват на изследователите да експериментират с по-ниски залози.“
Големите, скъпи модели, с техните постоянно увеличаващи се параметри, ще останат полезни за приложения като универсални чатботове, генератори на изображения и откриване на нови лекарства. Но за много потребители един малък, целенасочен модел ще работи също толкова добре, като в същото време е по-лесен за обучение и изграждане от страна на изследователите.
„Тези ефективни модели могат да спестят пари, време и изчисления“, казва още Чошен.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
