


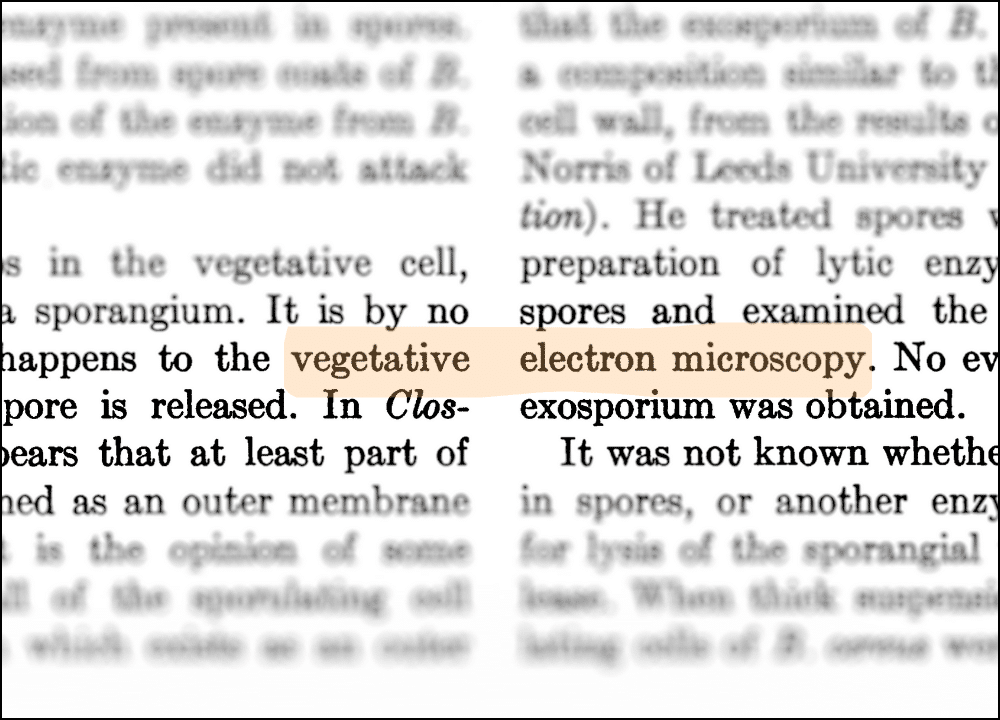

Изразът „вегетативна електронна микроскопия“ (vegetative electron microscopy) звучи така, сякаш му е мястото в научните списания и лекциите по микробиология. Всъщност това е празна фраза, която се е появила заради досадна грешка при дигитализирането на стари документи и завинаги е заседнала в данните за обучение на ИИ.
Изследователски екип е проследил странния път на термина и е показал как цифрови „вкаменелости“ могат да се скитат из научни публикации и дори рецензирани списания в продължение на десетилетия.
Произходът на проблема датира от 1959 година, когато в списанието Bacteriological Reviews са отпечатани два материала за бактериалните клетъчни стени. Оформлението на вестника с паралелни колони подвежда софтуера за разпознаване на текст и думата „вегетативен“ в едната колона се засича с „електронен“ в съседната колона. Така се родила една безсмислена, но примамливо звучаща конструкция. По-нататък тя беше уловена от търсачките, от които се обучават езикови модели.
Порталът Retraction Watch първи алармира за това: през февруари бе установено, че „вегетативна електронна микроскопия“ е цитирана в десетки съвременни статии, най-често в статии на ирански автори. Там роля е изиграло друго припокриване: на персийски думите „вегетативен“ и „сканиращ“ се различават само с една точка, а сканираща електронна микроскопия наистина съществува. В този момент човешката грешка се слива с цифровата и оттам нататък става само по-лошо.
Учени от няколко университета повториха експеримента: те подадоха отделни абзаци от оригинални статии на различни ИИ-модели. Старите GPT-2 и BERT реагирали правилно, но по-новите GPT-4o и Claude 3.5 уверено попълнили призрачната фраза. Това значи, че фразата е попаднала в публично достъпни набори от данни като CommonCrawl съвсем наскоро и е успяла да проникне в ИИ-моделите от ново поколение.
Невероятно трудно е да се отстрани такъв бъг. CommonCrawl съхранява петабайти уебстраници, а собствениците на големи ИИ-модели рядко разкриват какво точно са изтеглили за обучение. Дори и да се открие източникът, само технологичните гиганти могат да обработят огромните данни. Междувременно издателите, нетърпеливи да отпечатат колкото се може по-бързо повече документи, влошават положението.
Историята ни напомня: изкуственият интелект може да ускори науката, но е също толкова способен да умножи грешките, ако те не бъдат уловени навреме.
Една небрежно дигитализирана страница, няколко съвпадения в превода и един безсмислен термин се превръща в „научен факт“, който и най-усъвършенстваният модел може лесно да възпроизведе. Колкото по-дълго подобни грешка остават в отворените набори от данни, толкова по-трудно е да бъдат изтрити и толкова по-малък е шансът читателят да различи истинската наука от цифровите недоразумения.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
