


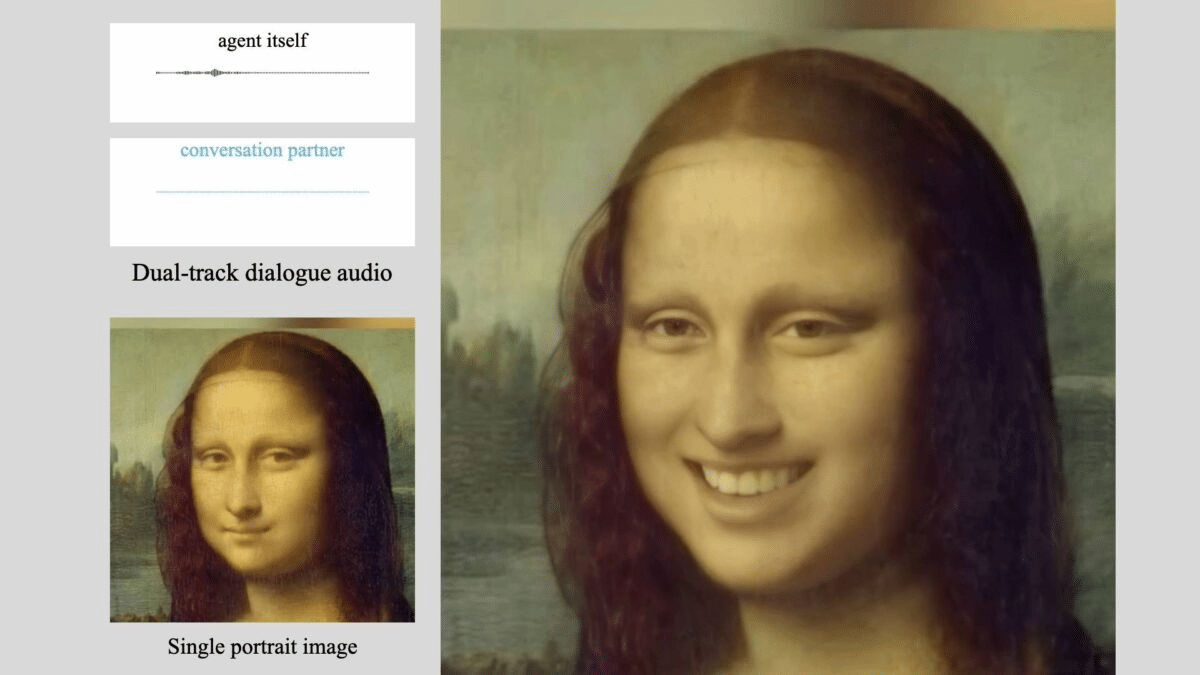

Компанията майка на TikTok, ByteDance, разработи AI-система, наречена INFP, която може да накара статичните портретни снимки да говорят и да реагират на аудио вход.
Това, което отличава INFP (Interactive, Natural, Flash и Person-generic) от останалите, е способността му да създава реалистични видеоклипове на разговори между двама души, без да е необходимо ръчно да се присвояват роли на говорител и слушател. Системата автоматично определя тези роли, докато протича разговорът.
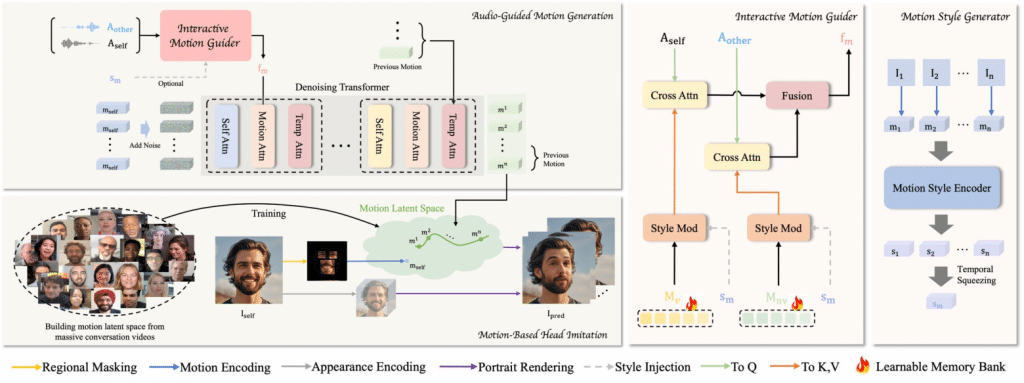
Системата работи на два основни етапа. В първия етап, който ByteDance нарича “Motion-Based Head Imitation“, AI се научава да взема предвид всички малки детайли от това как хората общуват — като изражения на лицето и движенията на главата по време на разговори. Той взема тези движения от видеото и ги превръща в данни, които могат да бъдат използвани по-късно. След това тези данни за движение могат да анимират статична снимка, за да съответстват на движенията на оригиналния човек.
Във втория етап, „audio-guided motion generation“, системата определя как да съпостави звуците с естествените движения. Екипът е разработил това, което наричат “motion guider“ и създава модели както за говорене, така и за слушане, като анализира звука от двете страни на разговора. След това специален AI-компонент, наречен дифузионен трансформър, постепенно усъвършенства тези модели в плавни, реалистични движения, които съответстват на звука.
За да обучи правилно своята система, екипът е трябвало да създаде нещо ново: колекция от реални разговори, които са наречени DyConv. Събрат повече от 200 часа разговори на хора от видеоклипове в интернет.
Въпреки че има други бази данни за разговори като ViCo и RealTalk, екипът казва, че DyConv предлага нещо специално — покрива по-широк спектър от човешки емоции и изрази, а качеството на видеото е забележимо по-добро.
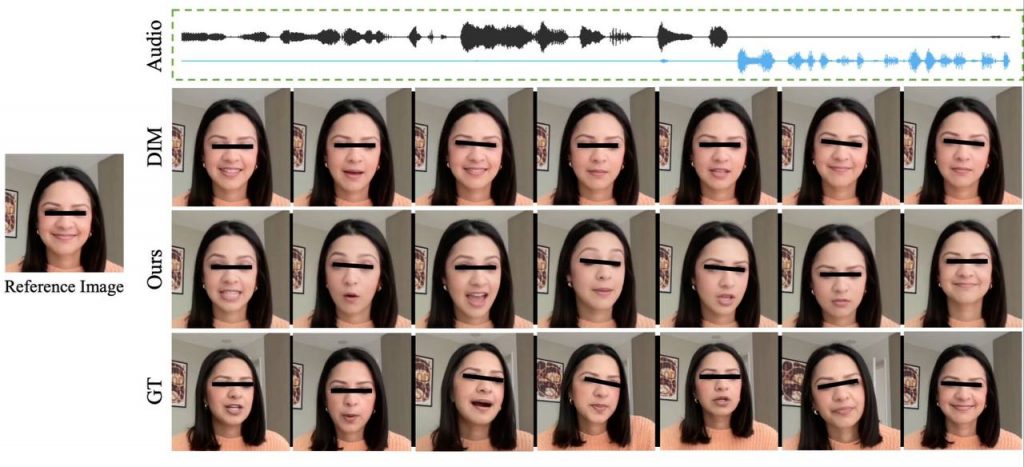
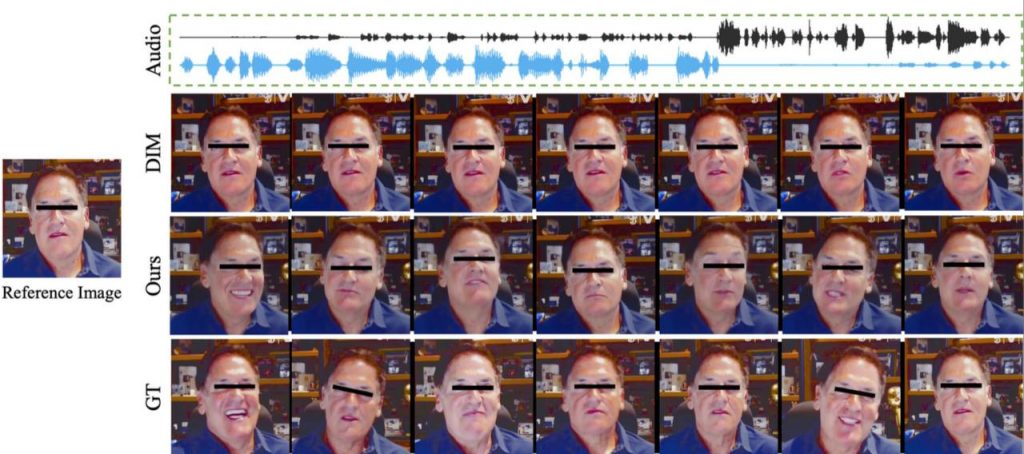
ByteDance казва, че неговата система превъзхожда съществуващите инструменти по няколко ключови начина. INFP са особено добри в съпоставянето на движенията на устните с речта, запазвайки уникалните черти на лицето на човека и създавайки широка гама от естествени движения. Екипът е установил също, че системата работи добре за създаване на видеоклипове на човек, който просто слуша разговор.
В момента INFP работи само с аудио, но екипът вижда много начини за разширяване на възможностите му. Те проучват как да накарат системата да работи с изображения и текст, което ще отвори много нови възможности. Следващата им цел е да създадат реалистични анимации на целите тела на хората, а не само на главите и израженията на лицето.
Изследователите разбират, че с този тип технология може да се злоупотребява за създаване на дийпфейк видеоклипове и разпространение на невярна информация. Така че планират да запазят основната технология достъпна само за изследователските институции, подобно на това, което Microsoft направи миналото лято със своята усъвършенствана система за клониране на глас.
Тази дейност е само една част от по-широката AI стратегия на ByteDance, която обяви по-рано тази година. С популярни приложения като TikTok и CapCut в своето портфолио, компанията разполага с огромна платформа за използване на тези AI-иновации.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
