


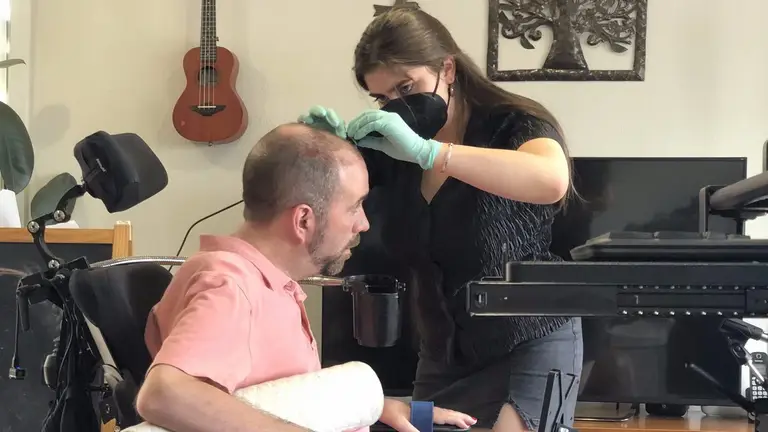

Невроимплантационна система, разработена от учени от Калифорнийския университет, позволява на хора с парализа да трансформират мозъчните сигнали в реч почти без забавяне. За първи път в историята подобни устройства позволяват не само възпроизвеждане на текст, но и предаване на интонация, тембър и дори пеене.
Какво представлява най-новото решение за възстановяване на гласа
Британският физик Стивън Хокинг е общувал със света в продължение на много години, използвайки сензор в очилата си, който е записвал движенията на мускулите на бузите му и му е позволявал да избира букви от екрана. За минута той е можел да напише една дума, след което специален синтезатор е преобразувал текста в реч. Съвременните технологии са напреднали значително след смъртта на Хокинг: днес имплантите позволяват директното преобразуване на мозъчните сигнали в текст или дори музика. Такива системи обаче са отнемали много време за обработка на информацията, имали са ограничен речник и не са възпроизвеждали интонации. Екип от Калифорнийския университет, ръководен от Майтрея Вайрагкар, е представил нещо революционно, съобщава ArsTechnica.
Новата технология преобразува мозъчната активност не в думи, а директно в звуци, правейки това в реално време. Този подход коренно отличава разработката от нейните предшественици и отваря пътя към създаването на изцяло дигитална гласова интерпретация.
В проучването е участвал пациент с тежка парализа, известна като Т15. За да работи устройството, 256 микроелектрода са имплантирани в областта на мозъка, отговорна за контрола на мускулите на речевия апарат. Системата записва сигналите от невроните, които изкуственият интелект разпознава и преобразува в акустични характеристики — по-специално височината и характера на звука. След това тези данни се подават към „вокодер“ (Voice decoder), който синтезира реч, максимално подобна на гласа на пациента преди заболяването. Цялата обработка трае само 10 милисекунди, така че процесът е напълно реалистичен и близо до мигновен.
За разлика от текстовите решения, новият имплант не ограничава избора на думи. Пациентът може да произнася всякакви фрази, възклицания, несъществуващи думи и дори да пее.
Резултатите от работата са впечатляващи
За да тестват ефективността си, екипът първо помолил слушателите да съпоставят запис на синтезираната реч на пациент с Т15 с шест възможни варианта с подобна дължина. Тоест, давали им да чуят изречение на пациента, а след това им показвали възможни варианти на казаното от него. Тук резултатите били абсолютно перфектни, като системата постигнала 100 процента разбираемост.
Проблемите започнали, когато екипът опитал тест за транскрипция, при който слушателите трябвало да работят без никакви подсказки. Във втория тест процентът на грешки в думите бил 43,75%, което означава, че участниците правилно разпознали малко над половината от изговорените думи. Това със сигурност е по-добре от действителната реч на пациента без помощ, където процентът на разпознаване бил малко над три процента, но не достатъчно за нормална комуникация.
Технологията обещава големи възможности, но очевидно се нуждае от подобрение. Учените планират да увеличат броя на електродите и да подобрят допълнително системата, за да постигнат устойчив резултат. Клиничните изпитвания с 1600 електрода ще започнат скоро.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
