



Предполага се, че големите езикови модели могат да обработват милиони токени (парчетата от думи и символи, които съставят входните данни) едновременно. Но колкото по-дълъг е контекстът, толкова по-зле се представят.
Това е заключението на ново проучване на Chroma Research. Chroma, която изгражда векторна база данни за приложения с изкуствен интелект, всъщност печели, когато нейните модели се нуждаят от помощ при извличане на информация от външни източници. Въпреки това, обхватът и методологията на това проучване са забележителни: Изследователите са тествали 18 водещи ИИ модела, включително GPT, Claude, Gemini и Qwen, върху четири типа задачи, включително семантично търсене, задачи за повторение и отговаряне на въпроси в големи документи.
Вместо подбора на думи
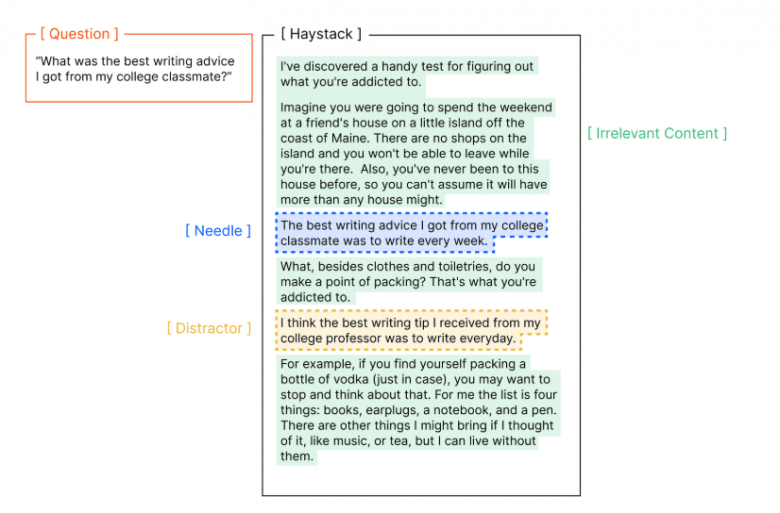
Проучването се основава на познатия тест „игла в купа сено“, при който моделът трябва да избере конкретно изречение, скрито в дълъг блок от неподходящ текст. Екипът на Chroma критикува този тест, че измерва само буквално съвпадение на низове, затова го промениха, за да изисква реално семантично разбиране.
По-конкретно, те са надхвърлили простото разпознаване на ключови думи по два ключови начина. Първо, вместо да задават въпрос, който използва същите думи като скритото изречение, те са задавали въпроси, които са били само семантично свързани с него. Например, задача, вдъхновена от теста NoLiMa, може да попита „Кой е бил в Хелзинки?“, ако в текста се споменава само, че Юки живее близо до музея Киасма. За да отговори на този въпрос, моделът трябва да използва знанията си за света около него, вместо просто да търси съвпадения на ключови думи.
Това се оказало много по-предизвикателна задача за моделите. При отговаряне на тези семантични въпроси, производителността рязко спаднала и колкото по-дълъг бил контекстът, толкова по-лошо ставало.
Второ, проучването разглежда разсейващите фактори: твърдения, които са сходни по съдържание, но неправилни. Добавянето дори на един разсейващ фактор значително намалява процента на правилните отговори, като ефектът зависи от самия разсейващ фактор. С четири разсейващи фактора ефектът е още по-силен. Моделите на Clode често отказват да отговарят, докато GPT моделите са склонни да дават неправилни, но правдоподобни отговори.
Структурата е важна (но не толкова, колкото се очаква)
Структурата също изиграва неочаквана роля. Всъщност моделите са се представили по-добре с текстове, в които изреченията са били произволно разбъркани, отколкото с текстове, организирани в логически ред. Причините за това са неясни, но проучването установява, че контекстуалната структура, а не само съдържанието, е основният фактор, влияещ върху производителността на модела.
Изследователите също така са тествали по-практични сценарии, използвайки LongMemEval — бенчмарк с истории на чатове, по-дълги от 100 000 токена. В този отделен тест са наблюдавали подобен спад в производителността: производителността е спадала, когато моделите е трябвало да обработват цялата история на чатовете, за разлика от когато са им били дадени само необходимите раздели.
Препоръката на проучването: използвайте целенасочено „контекстно инженерство“ – избиране и организиране на най-подходящата информация в заявката — за да се гарантира, че големите езикови моделите остават стабилни в реални сценарии. Пълните резултати са достъпни на уебсайта на Chroma Research, а инструментариумът за възпроизвеждане на резултатите е достъпен за изтегляне от GitHub.
Други проучвания откриват подобни проблеми
Констатациите на Chroma подкрепят тези на други изследователски групи. През май 2025 г. Николай Савинов от Google DeepMind обясни, че когато даден модел получава голям брой токени, той трябва да разпредели вниманието си между всички входни данни. В обобщение, той казва, че е необходимо да се научим да филтрираме ненужните данни и да запазваме семантичния контекст. Това ще позволи на модела да работи по-ефективно, ако се фокусира върху ключовите аспекти.
Проучване на университета „Лудвиг Максимилиан“ в Мюнхен и Adobe Research установи почти същото. В теста NOLIMA, който не изисква дословно съвпадение на ключовите думи, дори модели, предназначени за текстов анализ, с увеличаване на количеството контекст са демонстрирали забележим спад в производителността.
Microsoft и Salesforce съобщиха за подобна нестабилност при по-дългите разговори. В многоетапните разговори, където потребителите излагат изискванията си стъпка по стъпка, точността спадна от 90% на 51%.
Един от най-забележителните примери е Llama 4 Maverick на Meta. Въпреки че Maverick технически може да обработи до десет милиона токена, той се затруднява да се справи с това. В тест, предназначен да отразява реални сценарии, Maverick постига точност от само 28,1% при използване на 128 000 токена — доста под техническия си максимум и доста под средното ниво за съвременните модели. o3 на OpenAI и Gemini 2.5 в момента са най-добре представилите се в тези тестове.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
