


NVIDIA е открила начин за радикално ускоряване на системите за изкуствен интелект с дълги диалози. Новата технология KVTC намалява латентността до осем пъти и намалява потреблението на памет до 20 пъти. Това решение е от решаващо значение за корпоративни сценарии като анализи, програмиране и системи, базирани на агенти, при които дългият контекст натоварва силно графичния процесор. Тестовете върху модели с до 70 милиарда параметъра показват, че дори при 32-кратна компресия точността остава приемлива.
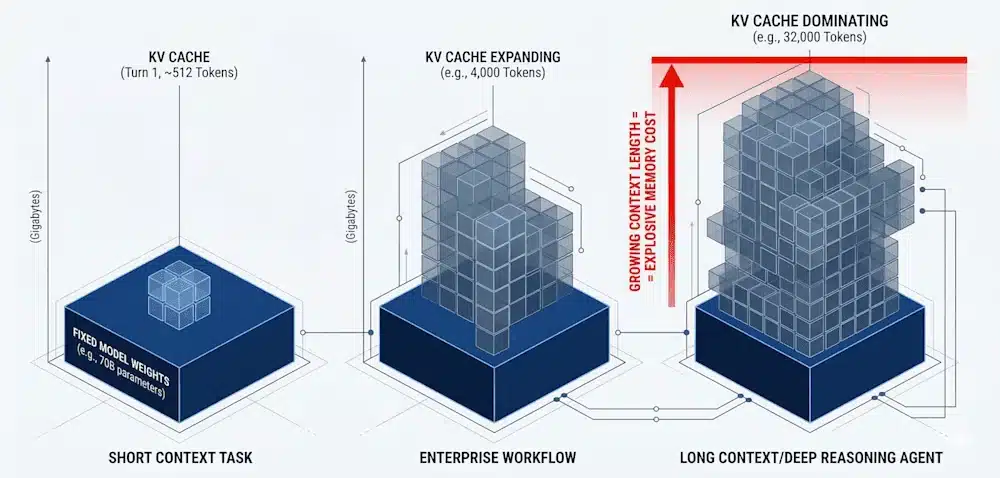
Методът KV Cache Transform Coding (KVTC) намалява размера на т.нар. кеш за ключови стойности (KV cache) – механизъм, който съхранява информацията за предишните съобщения в диалога. По същество това са скрити цифрови представяния за всеки предишен символ в диалога. Именно този кеш позволява на моделите да избегнат „препрочитането“ на цялата история на диалога отначало. Проблемът е, че той бързо нараства до гигабайти, което натоварва графичния процесор и увеличава латентността.
В корпоративните сценарии, включващи AI агенти и дълги вериги от разсъждения, това се превръща в сериозна пречка. Ограниченията на паметта на видеокартата често оказват по-голямо влияние върху мащабирането, отколкото самите изчислителни ресурси, което пряко влияе върху разходите за инфраструктура и отзивчивостта на системата. Повечето съществуващи техники за компресиране на KV кеша са или слаби, или изискват интензивни изчисления в реално време.
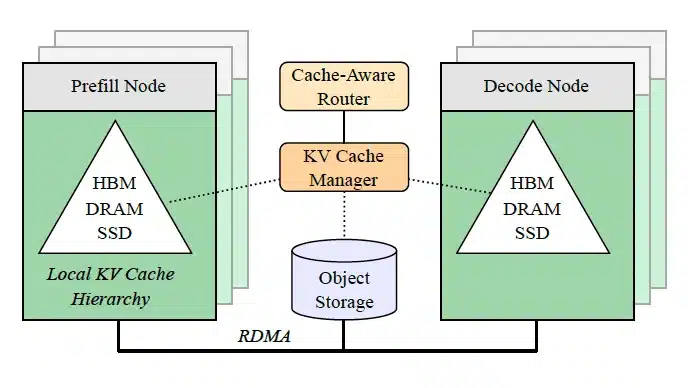
Новата технология решава проблема чрез подходи за компресиране от мултимедийни формати като JPEG.
Вместо да променя самия модел, KVTC работи на нивото на обработка на данните, така че методът е съвместим със съществуващите системи, без да е необходимо те да се препроектират. Подходът се основава на концепцията за трансформационно кодиране: кешът се намалява с помощта на бърз, многостепенен процес, извършван между изходните фази, така че да не се забавя генерирането на токени.
Ключов елемент на технологията е анализът на главните компоненти (PCA), който откроява най-важните данни в кеша и намалява излишната информация. След това се прилага алгоритъм, който разпределя прецизността на съхранението: значимите компоненти се съхраняват с висока прецизност, докато по-малко важните компоненти се компресират или отхвърлят.
Тестовете показват, че при компресиране до 20 пъти KVTC запазва точността на моделите със спад под 1 процентен пункт при широк спектър от бенчмаркове – от математически задачи (MATH-500) и програмиране (LiveCodeBench) до сценарии с дълъг контекст.
Методът е тестван върху модели с параметри от 1,5 до 70 милиарда, включително Mistral NeMo и Qwen 2.5. Например при Qwen 2.5 1.5B потреблението на памет е намалено от 29 KB на 3,2 KB на символ с 8-кратна компресия, а спадът в точността е само 0,3 процентни пункта. Дори при екстремна компресия от 32-64 пъти KVTC демонстрира стабилни резултати, докато алтернативните подходи забележимо губят точност още при петкратна компресия.
Допълнително предимство е драстичното намаляване на латентността: времето до генерирането на първия токен може да се намали до осем пъти. Така например при заявка на 8000 токена от стандартен 12-битов модел на Nvidia H100 преизчисляването на историята от нулата отнема около три секунди.
Разработчиците отбелязват, че технологията е най-подходяща за задачи с дълъг контекст – програмиране, анализи или агентно-базирани системи. В бъдеще KVTC може да се превърне в стандартен слой за оптимизация в инфраструктурата на изкуствения интелект, точно както компресията на видеото се превърна в неразделна част от съвременните стрийминг услуги.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
