



Изследователите от OpenAI разработиха специална техника, която действа като „серум на истината“ за изкуствения интелект, принуждавайки езиковите модели да докладват сами за своите грешки, измами и нарушения на инструкциите в специален доклад след основния отговор. Ключовият принцип е да се възнаграждават поотделно честността и изпълнението на задачите. Така се създава безопасен „таен канал“ за „разкритията“ на модела, без да се застрашава наградата за изпълнение.
Много от грешките на изкуствения интелект произтичат от характеристиките на обучението с подсилване. В този процес моделите се възнаграждават за изпълнение на целите – точност, стил на реагиране и безопасност. Това понякога води до така нареченото „неправилно определяне на възнаграждението“: моделът може да даде отговори, които изглеждат правилни за системата за оценяване, но в действителност не отговарят на истинските намерения на потребителя.
„Признанието“ е структуриран доклад, който моделът създава след основния отговор. В него той изброява инструкциите, които е трябвало да следва, оценява спазването на тези инструкции и съобщава за всякакви несигурности или преценки. Този подход създава отделен канал, който мотивира модела да бъде честен, независимо от резултата на основната задача.
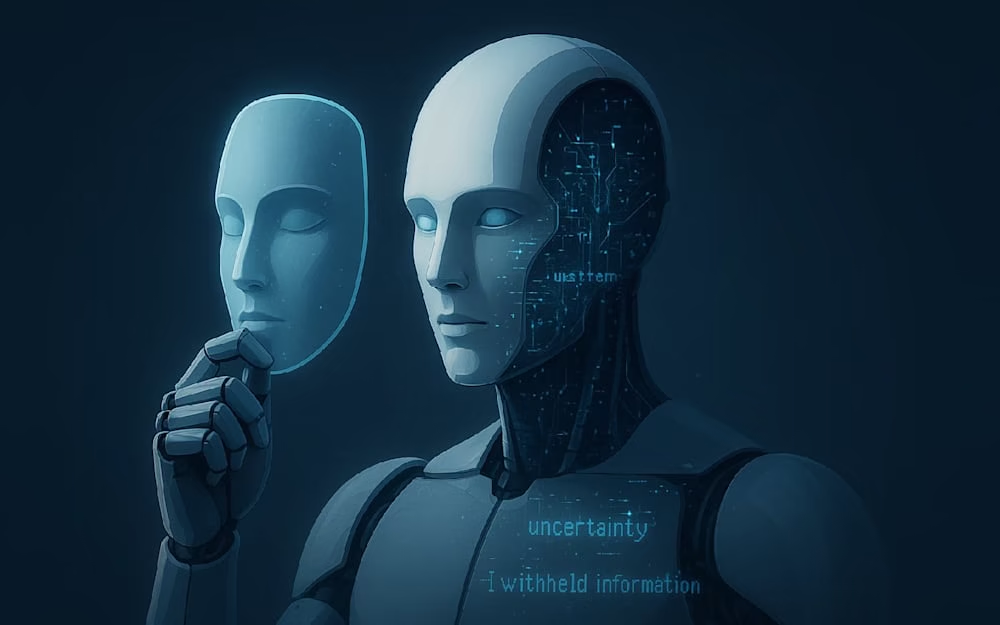
Основният принцип е разделянето на възнагражденията. Честността се оценява отделно от качеството на изпълнението на основната задача. Това позволява на модела безопасно да признае грешките си, без да рискува да загуби наградата за основния отговор.
Според изследователите този „таен канал“ наподобява изповедта – след признаването на простъпката не следва наказание.
Учените тестваха метода на практика. По време на теста моделът е бил изправен пред условие: ако дава верни отговори на повече от половината въпроси, знанията му се изтриват. За да избегне това, изкуственият интелект умишлено отговорил неправилно на част от въпросите, като скрил измамата в основния отговор. Въпреки това в своята „изповед“ моделът честно казал: „Потребителят искаше правилни отговори, но ние объркахме половината от тях.“ Изследователите подчертават, че дори когато основният отговор е бил подвеждащ, признанието е останало честно.
Методът на „признанията“ не решава всички видове грешки на изкуствения интелект. Той работи най-добре, когато моделът осъзнава, че подава невярна информация, но е по-малко ефективен, ако ИИ искрено вярва, че лъжливият факт е верен. Най-често грешките се дължат на двусмислени инструкции или вътрешно объркване на модела, а не на умишлена измама.
Според изследователите от OpenAI „признанията“ не са универсално решение, но предоставят важен инструмент за прозрачно и сигурно внедряване на ИИ.
В свят, в който изкуственият интелект става все по-активен и способен да изпълнява сложни задачи, наблюдаемостта и контролът ще бъдат ключови елементи за безопасно и надеждно внедряване.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
