



Изследователи от Масачузетския технологичен институт са проучили вътрешната работа на големите езикови модели (LLM) и са установили, че те обработват различните видове данни, подобно на човешкия мозък. Невробиолозите смятат, че в предния темпорален лоб на мозъка има „семантичен център“, който интегрира информацията от различните сетива, например визуалните и тактилните сигнали. Нещо подобно се наблюдава и при функционирането на LLM. Учените са провели експерименти с двойки изречения на различни езици и са установили, че ИИ моделът използва английския език като централен инструмент за обработка, дори когато работи с други езици или формати данни като изображения и звукови файлове. Нещо повече, възможна е намеса в работата на „семантичния център“ на изкуствения интелект.
LLM се състои от множество взаимосвързани звена и разделя текста на отделни думи или части от думи, които се наричат токени. На всеки токен моделът присвоява някакво представяне, което му помага да разбере как думите са свързани помежду си и да намери следващата дума. В случай на изображения или звук токените съответстват на отделните елементи на картината или звуковия файл. Учените откриха, че първите слоеве на модела обработват информация на определен език или в определен формат, сякаш са различни части на мозъка. След това моделът превръща токените в универсални понятия, за да ги анализира на по-дълбоки нива. По подобен начин мозъкът комбинира различната информация в единно цяло.
Моделът присвоява сходни представяния на входните данни с близко значение, независимо от техния вид – изображения, аудио, код или задачи. Една снимка и нейното текстово описание, които имат различен формат, ще получат сходни представяния поради общото значение.
Така например една англоезична невронна мрежа „мисли“ за подаден китайски текст на английски език, преди да произведе резултат на китайски език. Същото поведение е характерно и при програмирането, математическите задачи и мултимодалните данни.
За да проверят тази хипотеза, изследователите са използвали двойки изречения с едно и също значение, но на различни езици, като са ги прекарвали през модела и са измервали сходството на представянията. След това те „подават“ на англоезичния модел текст на друг език – китайски, и сравняват вътрешното му представяне с представянето на английски и китайски. Подобни експерименти бяха проведени и с други видове данни.
Оказва се, че ИИ моделът демонстрира сходни репрезентации за изреченията с близко семантично значение. Анализите на различни видове данни показаха, че лексемите, обработвани от модела във вътрешните слоеве, съответстват в по-голяма степен на английските лексеми, отколкото на лексемите на входните данни. Много видове информация, които са коренно различни от базовия език, все още съдържат лексеми, свързани с английския език. Това се наблюдава например и при работата с математически данни и код.
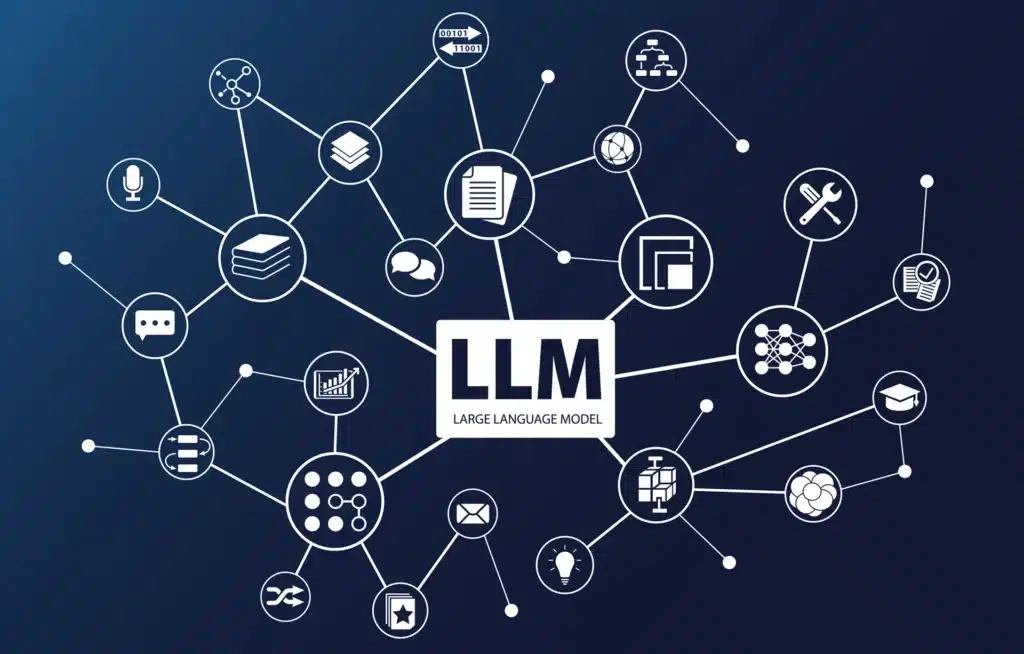
Според изследователите LLM могат да овладеят стратегията „семантичен център“ по време на обучението, тъй като тя е икономически ефективен начин за обработка на различна информация.
Съществуват много езици, но голяма част от знанията, като например общоприетите знания, са универсални. Не е необходимо моделите да дублират тези знания за всеки език.
Изследователите също така се опитват да се намесят във вътрешните слоеве на модела, като използват английски текст, когато той обработва други езици. Те установиха, че могат да променят резултата по контролиран начин, дори когато е представен на друг език. Този ефект може да се използва за подобряване на взаимодействието на модела с различните формати данни.
От друга страна, някои понятия и знания, като например културните знания, може да не могат да бъдат преведени. В такива случаи LLM се нуждае от специфични за езика механизми за обработка. Според изследователите, трябва да се намери баланс между общите знания и езиковата специфика. Често един англоезичен модел, изучаващ друг език, губи точността си в английския език. Разбирането на „семантичния център“ на модела ще помогне за предотвратяването на това явление.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
