



Пророците и разпространителите на новини за изкуствения интелект (ИИ) прогнозират края на шумотевицата около генеративния ИИ, като говорят за предстоящ катастрофален „срив на модела“.
Но доколко реалистични са тези прогнози? И какво изобщо представлява сривът на модела?
Обсъждан през 2023 г., но популяризиран напоследък, „колапсът на модела“ се отнася до хипотетичен сценарий, при който бъдещите системи за ИИ стават все по-глупави поради увеличаването на генерираните от самите ИИ данни в интернет.
Необходимостта от данни
Съвременните ИИ системи са изградени с помощта на машинно обучение. Програмистите създават основната математическа структура, но действителната „интелигентност“ идва от обучението на системата да имитира и създава модели от тези данни.
Но това не са просто някакви данни. Сегашните генеративни системи за изкуствен интелект се нуждаят от висококачествени данни, и то от много такива.
За да се сдобият с тези данни, големите технологични компании като OpenAI, Google, Meta и Nvidia непрекъснато претърсват интернет, събирайки терабайти съдържание, с което да захранват машините. Но след появата на широко достъпни и полезни генеративни системи за изкуствен интелект, което стана през 2022 г. хората все по-често качват и споделят съдържание, което е създадено, частично или изцяло, от изкуствен интелект.
През 2023 г. изследователите започнаха да се чудят дали могат да се справят с това да разчитат за обучение само чрез данните, създадени от ИИ, вместо чрез данните, генерирани от реалните хора.
Съществуват огромни стимули това да се осъществи. Освен че се разпространява в интернет, съдържанието, създадено от ИИ, е много по-евтино за създаване от човешки данни. Освен това масовото му събиране не е под въпрос от етична и правна гледна точка.
Въпреки това изследователите установиха, че без висококачествени човешки данни ИИ системите, обучени на данни, създадени от ИИ, стават все по-глупави, тъй като всеки модел се учи от предишния. Това е нещо като цифрова версия на проблема с кръвосмешението.
Изследователите обаче установиха, че без висококачествени човешки данни системите за изкуствен интелект, обучени на данни, създадени от изкуствен интелект, стават все по-глупави, тъй като всеки модел се учи от предишния. Това е нещо като цифрова версия на проблема с инбридинга.
Това „регресивно обучение“ изглежда води до намаляване на качеството и разнообразието на поведението на моделите. Качеството тук означава приблизително някаква комбинация от това да бъдеш полезен, безвреден и честен. Разнообразието се отнася до вариациите в отговорите и до това кои културни и социални перспективи на хората са представени в резултатите на ИИ.
Накратко: като използваме толкова много системи за изкуствен интелект, можем да замърсим самия източник на данни, от който се нуждаем, за да ги направим максимално полезни.
Избягването на срива
Не могат ли новите технологии просто да филтрират съдържанието, генерирано от изкуствен интелект? Не съвсем. Технологичните компании вече отделят много време и средства за почистване и филтриране на данните, които събират, като един от тях наскоро сподели, че понякога изхвърлят до 90% от данните, които първоначално събират за обучение на своите модели.
Тези усилия могат да станат още по-интензивни, тъй като необходимостта от специалното премахване на съдържание, генерирано от изкуствения интелект, се увеличава. Но по-важното е, че в дългосрочен план всъщност ще става все по-трудно да се разграничи съдържанието, създадено от ИИ. Това ще превърне филтрирането и премахването на синтетичните данни в игра с намаляваща (финансова) възвръщаемост.
В крайна сметка досегашните изследвания показват, че просто не можем напълно да се откажем от човешките данни. В края на краищата, именно от тях идва „I-то“ в AI.
Дали не сме се запътили към катастрофа?
Има признаци, че на разработчиците вече им се налага да работят все по-усилено, за да си набавят висококачествени данни. Така например в документацията, придружаваща версията GPT-4, се посочва безпрецедентният брой служители, участващи в проекта по отношение на данните.
Възможно е също така да липсват нови данни за хората. Според някои оценки фондът от текстови данни, генерирани от хора, може да бъде изчерпан още през 2026 г.
Вероятно затова OpenAI и другите компании се надпреварват да сключват ексклузивни партньорства с индустриални гиганти като Shutterstock, Associated Press и NewsCorp. Те притежават големи собствени колекции от човешки данни, които не са лесно достъпни в публичния интернет.
Въпреки това перспективите за катастрофален срив на модела може да се окажат преувеличени. Повечето изследвания досега разглеждат случаи, в които синтетичните данни заместват човешките данни. На практика човешките данни и данните на изкуствения интелект вероятно ще се натрупват паралелно, което намалява вероятността от срив.
Най-вероятният бъдещ сценарий също така ще включва екосистема от малко по-разнообразни генеративни платформи на ИИ, които ще се използват за създаване и публикуване на съдържание, а не един монолитен модел. Това също увеличава устойчивостта срещу срив.
Това е една добра причина регулаторните органи да насърчават здравословната конкуренция чрез ограничаване на монополите в сектора на ИИ и да финансират разработването на технологии от обществен интерес.
Истинските опасения
Съществуват и по-изтънчени рискове, свързани с твърде многото съдържание, създадено от изкуствения интелект.
Напливът от синтетично съдържание може да не представлява екзистенциална заплаха за напредъка на развитието на ИИ, но застрашава цифровото обществено благо на (човешкия) интернет.
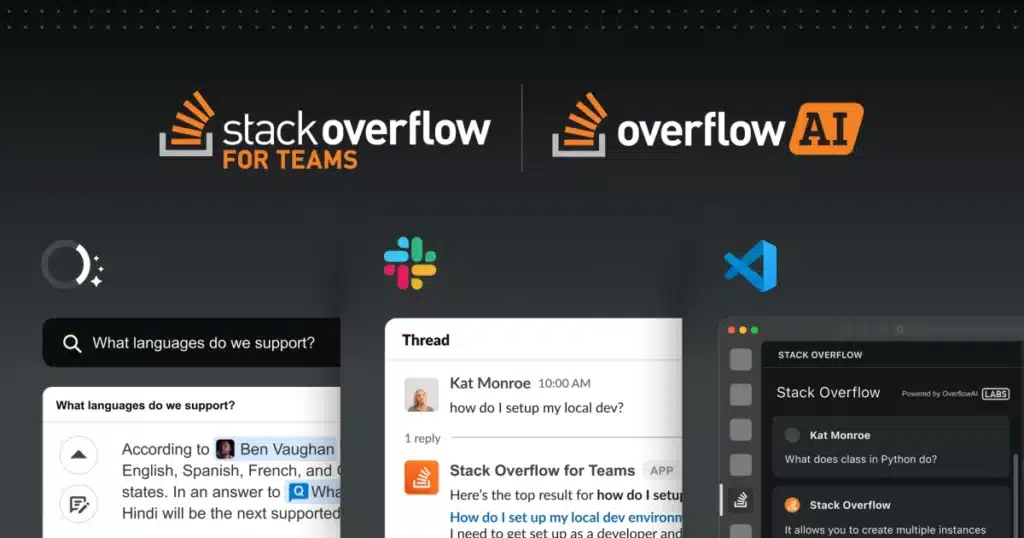
Така например изследователите установиха 16% спад в активността на уеб сайта за кодиране StackOverflow една година след появата на ChatGPT. Това предполага, че помощта от ИИ може би вече намалява взаимодействията между хората в някои онлайн общности.
Хиперпроизводството във фермите за съдържание, задвижвани от ИИ, също така затруднява намирането на съдържание, което не е кликбейт, натъпкан с реклами.
Става невъзможно да се направи надеждно разграничение между съдържание, генерирано от хора, и съдържание, генерирано от ИИ. Един от методите за справяне с това е поставянето на водни знаци или етикетиране на съдържанието, генерирано от изкуствения интелект, както редица експерти наскоро подчертаха и както е отразено в неотдавнашното временно законодателство на австралийското правителство.
Съществува и друг риск. Тъй като съдържанието, генерирано от изкуствен интелект, става систематично хомогенно, рискуваме да загубим социално-културното многообразие и някои групи хора биха могли дори да изпитат културно заличаване. Спешно се нуждаем от интердисциплинарни изследвания на социалните и културните предизвикателства, породени от системите на ИИ.
Човешките взаимодействия и човешките данни са важни и ние трябва да ги защитаваме. За наше собствено добро, а може би и заради евентуалния риск от един бъдещ срив на модела.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
