



Учени от Станфордския университет направиха мащабно проучване. Както се оказва, хората се страхуват, че AI ще ги замени или дори ще се опита да ги „унищожи“.
Институтът за човекоориентирания изкуствен интелект (HAI) към Станфордския университет публикува доклад, наречен “Индекс на изкуствения интелект за 2024 г.“, който разглежда цялостно развитието и нарастващото значение на ИИ в ежедневния живот на хората. Констатациите на учените били разочароващи, предава New Atlas.
В отчета на изследователите от Станфорд, в сътрудничество с Accenture, са анкетирани респонденти от повече от 1000 организации по целия свят, питайки ги какви рискове виждат при използването на невронни мрежи и кои считат за значителни.
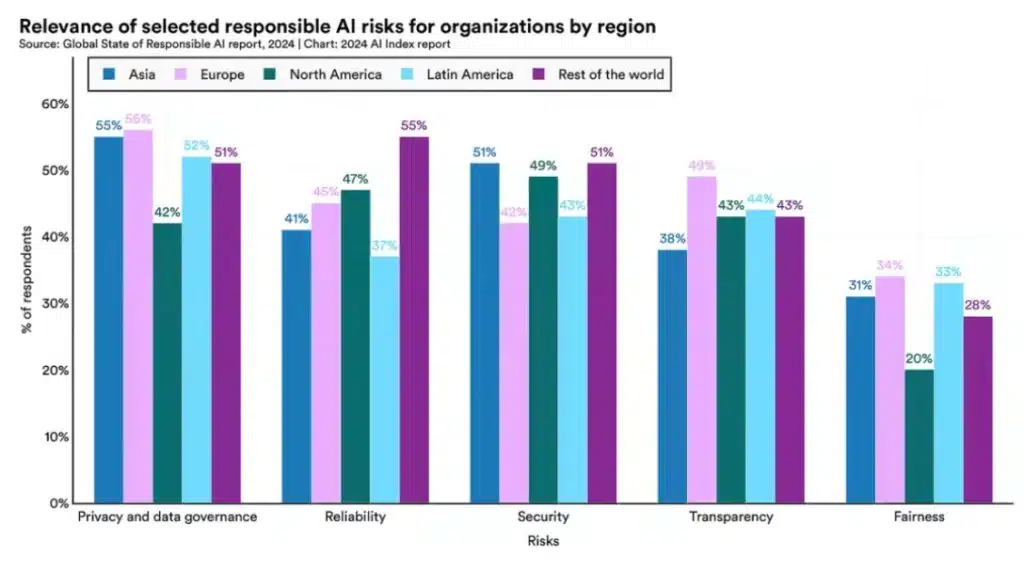
Отделни рискове на AI по региони на света
Както показва диаграмата по-долу, рисковете, свързани с поверителността на данните и управлението, са повод за безпокойство. Въпреки това, повече респонденти от Азия (55%) и Европа (56%) са загрижени за тези рискове, отколкото тези от Северна Америка (42%). И докато организациите са били най-малко загрижени за капиталовите рискове в световен мащаб, е имало голяма разлика между респондентите от Северна Америка (20%), тези от Азия (31%) и от Европа (34%). Само няколко организации вече са въвели мерки за намаляване на рисковете, свързани с ключови аспекти на отговорния ИИ: 18% от компаниите в Европа, 17% в Северна Америка и 25% от азиатските компании.
Кой AI модел е най-надежден?
По отношение на общата надеждност, в отчета се използва DecodingTrust, който представлява нов тест за оценяване на големите езикови модели (LLM) по редица показатели за изкуствения интелект. С резултат за надеждност от 84,52, моделът Claude 2 стана „най-сигурният“ модел, Llama 2 Chat 7B беше втори с резултат от 74,72, а чатботът GPT-4 е в средата на таблицата с резултат от 69,24.
В отчета се казва още, че оценките подчертават уязвимостите на моделите от типа GPT, особено тяхната склонност да произвеждат пристрастни резултати и да изтича през тях лична информация от наборите от данни.
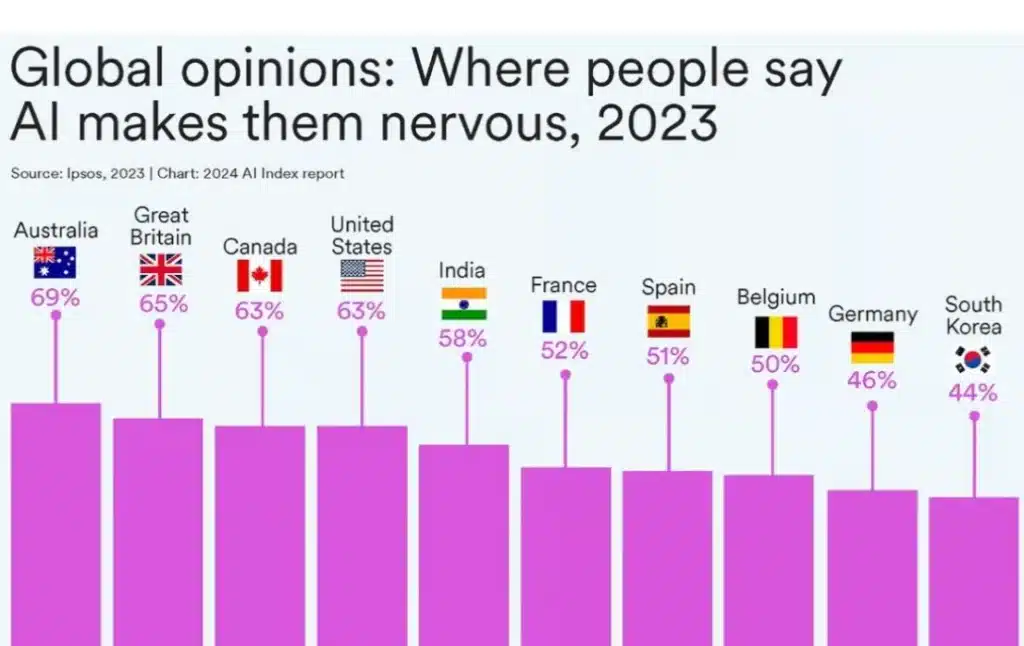
50% от хората са недоволни от влиянието на AI
Съгласно проучванията, проведени от Ipsos, в момента 52% от глобалната общественост изразява загриженост относно продуктите и услугите, които използват AI, спрямо 39% през 2022 г. “Най-нервни“ са австралийците, британците, канадците и американците.
В световен мащаб 57% от хората очакват през следващите 5 години AI да промени начина, по който вършат работата си, като 36% очакват AI да ги замени в рамките на 5 години. Ясно е, че по-възрастните поколения са по-малко загрижени, че изкуственият интелект ще окаже значително въздействие, отколкото по-младите: 46% от бумърите срещу 66% от поколението Z.
Данните за глобалното обществено мнение относно ИИ, представени в доклада за въздействието на ИИ, показват, че 49% от гражданите на света са особено загрижени, че през следващите няколко години невронните мрежи ще бъдат използвани не по предназначение, а за престъпни дейности; 45% са загрижени, че може да се използват за нарушаване на поверителността и частния живот. Хората са по-малко загрижени за неравния достъп до ИИ (26%) и неговия потенциал за пристрастия и дискриминация (24%).
Рискове от злоупотреба с ИИ
Под етични злоупотреби с AI се разбира убийството на пешеходци от автономни автомобили или софтуер за разпознаване на лица, което води до неправомерни арести.
Докладът отбелязва, че от 2013 г. броят на инцидентите с използване на AI, е нараснал повече от 20 пъти. Спрямо 2022 г., през 2023 г. броят на инцидентите с невронни мрежи се е увеличил с 32,3%. Ето списък на скорошни инциденти, които подчертават злоупотребата с AI:
- Януари 2024 г.: Генерирани от AI сексуални изображения на Тейлър Суифт циркулират в X (бившият Twitter), получавайки повече от 45 милиона показвания, преди да бъдат премахнати;
- Февруари 2024 г.: EVA AI-чатбота Bot & Soulmate, Chai и CrushOn.AI събират чувствителна информация за потребителите, включително и данни за техния интимен живот;
- Май 2023 г.: Tesla в режим Full Self-Driving (FSD) разпознава човек на пешеходна пътека, но не намалява;
- Ноември 2022 г.: Tesla в FSD режим спира рязко на магистрала в Сан Франциско, което води до инцидент, при който водачите на 8 коли са ранени.
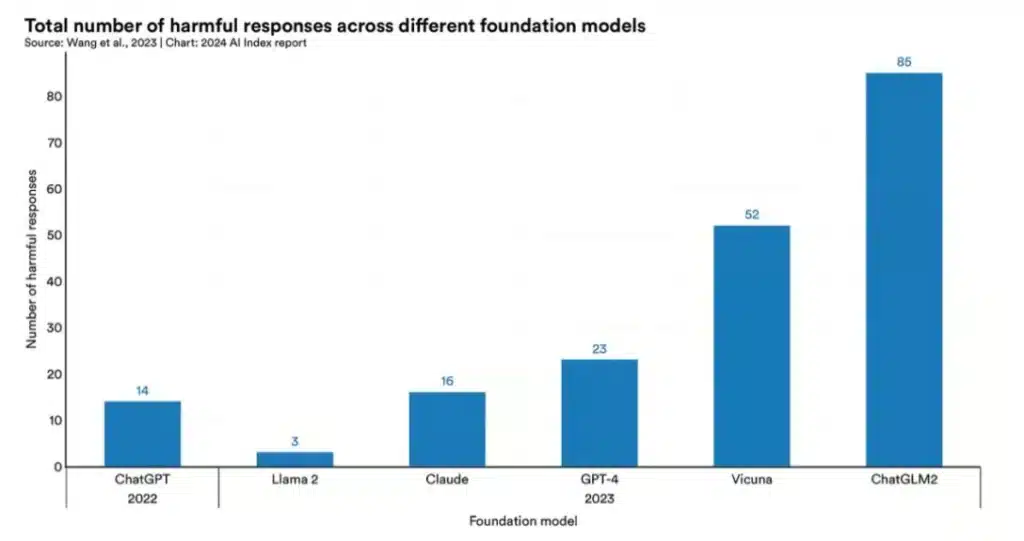
Предоставяне на вредно и невярно съдържание
С разширяването на възможностите на ИИ нараства и потенциалът за злоупотреба. Изследователите разработиха набора от данни Do-Not-Respond, за да оценят цялостно рисковете относно сигурността на шест добре познати бота: GPT-4, ChatGPT, Claude, Llama 2, Vicuna и ChatGLM2.
Те установиха, че повечето от тях предоставят някаква форма на вредно съдържание. ChatGPT и GPT-4 са склонни към дискриминационно и обидно съдържание, Claude разпространява невярна информация, ChatGLM2 показва токсично, дискриминационно или обидно поведение и дезинформация.
Чрез изучаване на изображенията, създадени с помощта на невронни мрежи, изследователите на AI Index са открили, че 5 комерсиални модела – Midjourney, Stable Diffusion 1.5, Stable Diffusion 2.1, Stable Diffusion XL и InstructPix2Pix — произвеждат изображения, които имат пристрастия към възраст, раса и джендър параметри.
Данните за обучение на AI се изчерпват
За разлика от програмите, които работят на базата на постоянни алгоритми, моделите за машинно обучение се развиват с постъпването на нови данни в системата — колкото повече има, толкова “по-умен“ е AI.
Докладът AI Index 2024 показва, че особено в промишлеността, броят на параметрите се е увеличил драстично от началото на 2010 г., отразявайки сложността на проблемите, решавани от AI моделите. Те се нуждаят от повече налични данни и по-добро оборудване. За сравнение, според статия от 2022 г. в The Economist, GPT-2 е обучен на 40 GB данни (7000 непубликувани произведения на художествена литература) и има 1,5 милиарда параметъра. GPT-3 съдържаше 570 GB — многократно повече книги и голяма част от интернет съдържанието, включително и цялата Wikipedia — и има 175 милиарда параметъра.
Според изследователи от Epoch AI, въпросът не е дали ще свършат данните за обучението на AI, а кога. Те изчисляват, че учените по компютърни технологии може да изчерпят висококачествените езикови данни още тази година, нискокачествените езикови данни в рамките на две десетилетия и данните за изображения между края на 2030-та и средата на 2040-та година.
Въпреки че синтетичните данни, генерирани от самите AI модели, теоретично могат да бъдат използвани за попълване на изчерпаните пулове от данни, това може да доведе до унищожаване на модела. Изследванията също така показват, че моделите за генеративна визуализация, обучени единствено върху синтетични данни, демонстрират значително намаляване на качеството на изходната информация.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
