



След критиките на колегите създателите на колекцията Tiny Images (80 милиона изображения с резолюция 32х32 пиксела) се извиниха и премахнаха тази база данни от уеб пространството.
Специалистите на Масачузетския технологичен институт и от университета в Ню Йорк спряха онлайн достъпа до тази колекция и призоваха всички да се въздържат от от използването на тези изображения, както и да изтрият всички налични пълни или частични копия.
Новината бе обявена в самото начало на тази седмица в писмо от професорите на MIT Бил Фриймън и Антония Торалба, както и от професор Роб Фергюс от Нюйоркския университет, в официалния сайт на лабораторията по информатика и изкуствен интелект на Масачузетския технологичен институт.
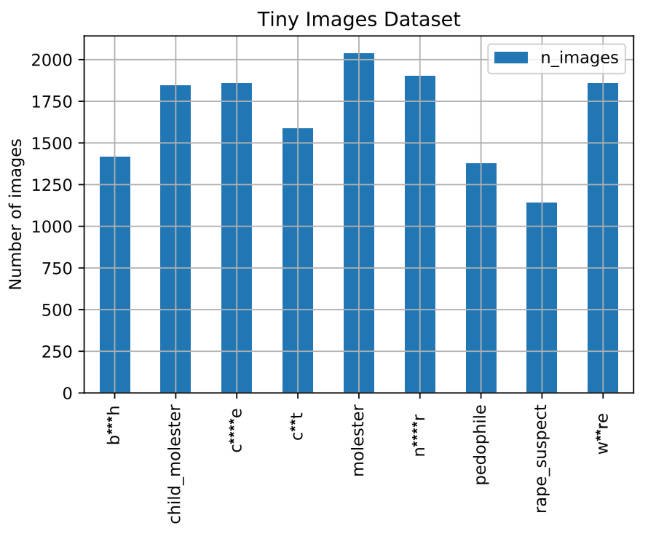
Базата данни Tiny Images е създадена през 2006 година и съдържа изображения, автоматично изрязани от снимките, намирани от различните интернет търсачки. Но сега се оказа, че те съдържат редица расистки, сексистки и други оскърбителни определения, автоматично добавени от семантичната система WordNet. Така например, почти 2000 изображения са отбелязани с думата „негър“, а това всички знаем, че днес е недопустимо. Има и картинки отбелязани като „заподозрян за изнасилване“, както и „педофил“, което не е добре.
Оказа се, че в тази база данни има и порнографски елемент – снимки направени под полите на жени. Има и изображения на полови органи с жаргонни термини, а изображенията на редица жени са определени като проститутки, че и по-лошо. Използват се недопустими за едно съвременно общество термини за чернокожите и азиатците.
Създателите на този набор от данни заявиха, че масивът е много голям, а изображенията 32х32 са прекалено малки и това силно затруднява контрола на всички тези картинки. А според данните на Google Scholar, 80 милиона от тези малки изображения се цитират в над 1700 научни работи.
„Предразсъдъците, оскърбленията и предубедеността, както и унищожителната терминология отчуждават важна част на нашата общност – всъщност именно тези, които ние се опитваме да привлечем“ – написаха професорите в своето писмо. „Това способства за появата на вредни предубеждения в системите с изкуствен интелект, обучени с помощта на тези данни. Така се нанася вреда и на постигнатото в областта на компютърното зрение. Това е много тъжно и противоречи на ценностите, които ние се стараем да отстояваме“.
И трите професора казаха, че за недостатъците в Tiny Images им е съобщено в края на миналия месец от аспиранта на Дъблинския университет Абеба Бирхейн (Abeba Birhane) и от аспиранта от университета Карнеги Мелън с име Уинай Прабху (Vinay Uday Prabhu). Това е първата в историята критика на тези 80 милиона съвсем малки изображения.
Създателите на колекцията Tiny Images са на мнение, че проблемът е възникнал преди всичко от автоматизираното събиране на произволни данни и автоматизираното добавяне на етикети от системата за семантична йерархия WordNet.
В тази критика се прави извод, че този масив от изображения подкопават конфиденциалността и могат да окажат непропорционално негативно влияние към чернокожите, азиатците, към расовите малцинства и миноритарните общности.
Бирхейн и Прабху твърдят, че общността на компютърното зрение още сега трябва да отдели много повече внимание на етническото използване на подобни големи масиви от изображения, отчасти заради нарастващата достъпност на софтуерни инструменти за изваждане на изображения от уеб страниците и технологиите за обратно търсене на изображения. Извършеният анализ на този и други големи масиви с изображения показаха, че не става дума просто за тези бази данни, но и за културата в академичните кръгове, както и за твърде лесната възможност за създаване на подобни комплекти без съгласието на участниците.
„Ние сме на мнение, че по-дълбоките проблеми се коренят в широките структурни традиции, стимули и в това, че етичните проблеми се разглеждат на последно място. Това е област, в която твърде често се използват евфемизми за обозначаване липсата на съгласие“ – се казва в тази твърде сложна и размита статия за анализа на масивите данни от подобен тип.
Но за съблюдаването на въпросните етични принципи авторите на тази научна работа предлагат:
- Размиване лицата на хората в изображенията на подобни колекции
- Да не се използва Creative Commons лиценза
- Изображенията да бъдат събирани с ясно изразеното съгласие на участниците
- Да се използват модални карти като в Google AI и таблици на данните като в Microsoft Research
Да добавим, че оскърбителни определения бяха открити и в масива данни ImageNet, а това е най-популярната колекция от изображения в тази област. Базата данни ImageNet бе представена по време на изложението CVPR през 2009 година, като тя се счита за най-важна за развитието на компютърното зрение и машинното обучение. Докато по-големите масиви с изображения включват по десетина хиляди картинки, ImageNet разполага с над 14 милиона изображения. Изграждането на ImageNet се осъществи от 2010 до 2017 година и доведе до възникването на редица мощни стартъпи. Според Google Scholar, колекцията ImageNet се цитира почти 17 000 пъти.
Създателите на набора изображения ImageNet завиха, че са открили в 1593 от общо 2832 категории са открили потенциално оскърбителни определения, които планират да премахнат.
От друга страна, създателите на Tiny Images решиха да не рискуват с потенциално възможните съдебни дела на тема расизъм и сексизъм, и премахнаха тази колекция с малки изображения от уеб пространството.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
