



Новият инструмент за оценка LongEval въвежда общи стандарти за валидиране на текстовете на изкуствения интелект.
Напоследък обществеността остро реагира на излизането на генеративните невронни мрежи като ChatGPT. Мнозина виждат в тази технология голяма крачка напред в комуникацията, докато други предричат пагубните ѝ последици.
Въпреки това генерираният от ИИ текст стана известен със своите недостатъци и човешката оценка остава златният стандарт за гарантиране на точността, особено когато се генерират дълги резюмета (резюмета и дисертации) на сложни текстове. Но в същото време понастоящем няма приети стандарти за човешката оценка на дългите резюмета, което поражда съмнения дори относно „златния стандарт“.
За да се справи с тази ситуация, екип от учени в областта на компютърните науки от САЩ представи набор от насоки, наречени „LongEval“. Принципите бяха представени на европейския клон на Асоциацията за компютърна лингвистика, където получиха наградата за най-добра разработка.
Според експертите понастоящем не съществува надежден начин за оценка на дългите генерирани текстове без човешко участие, а дори съществуващите протоколи за човешка оценка са скъпи, отнемат много време и силно варират.
В хода на проучването екипът е разгледал 162 научни статии относно дългите биографии. Анализът показа, че 73% от документите изобщо не са били подложени на човешка оценка, а останалите са били подложени на различни техники за оценка.
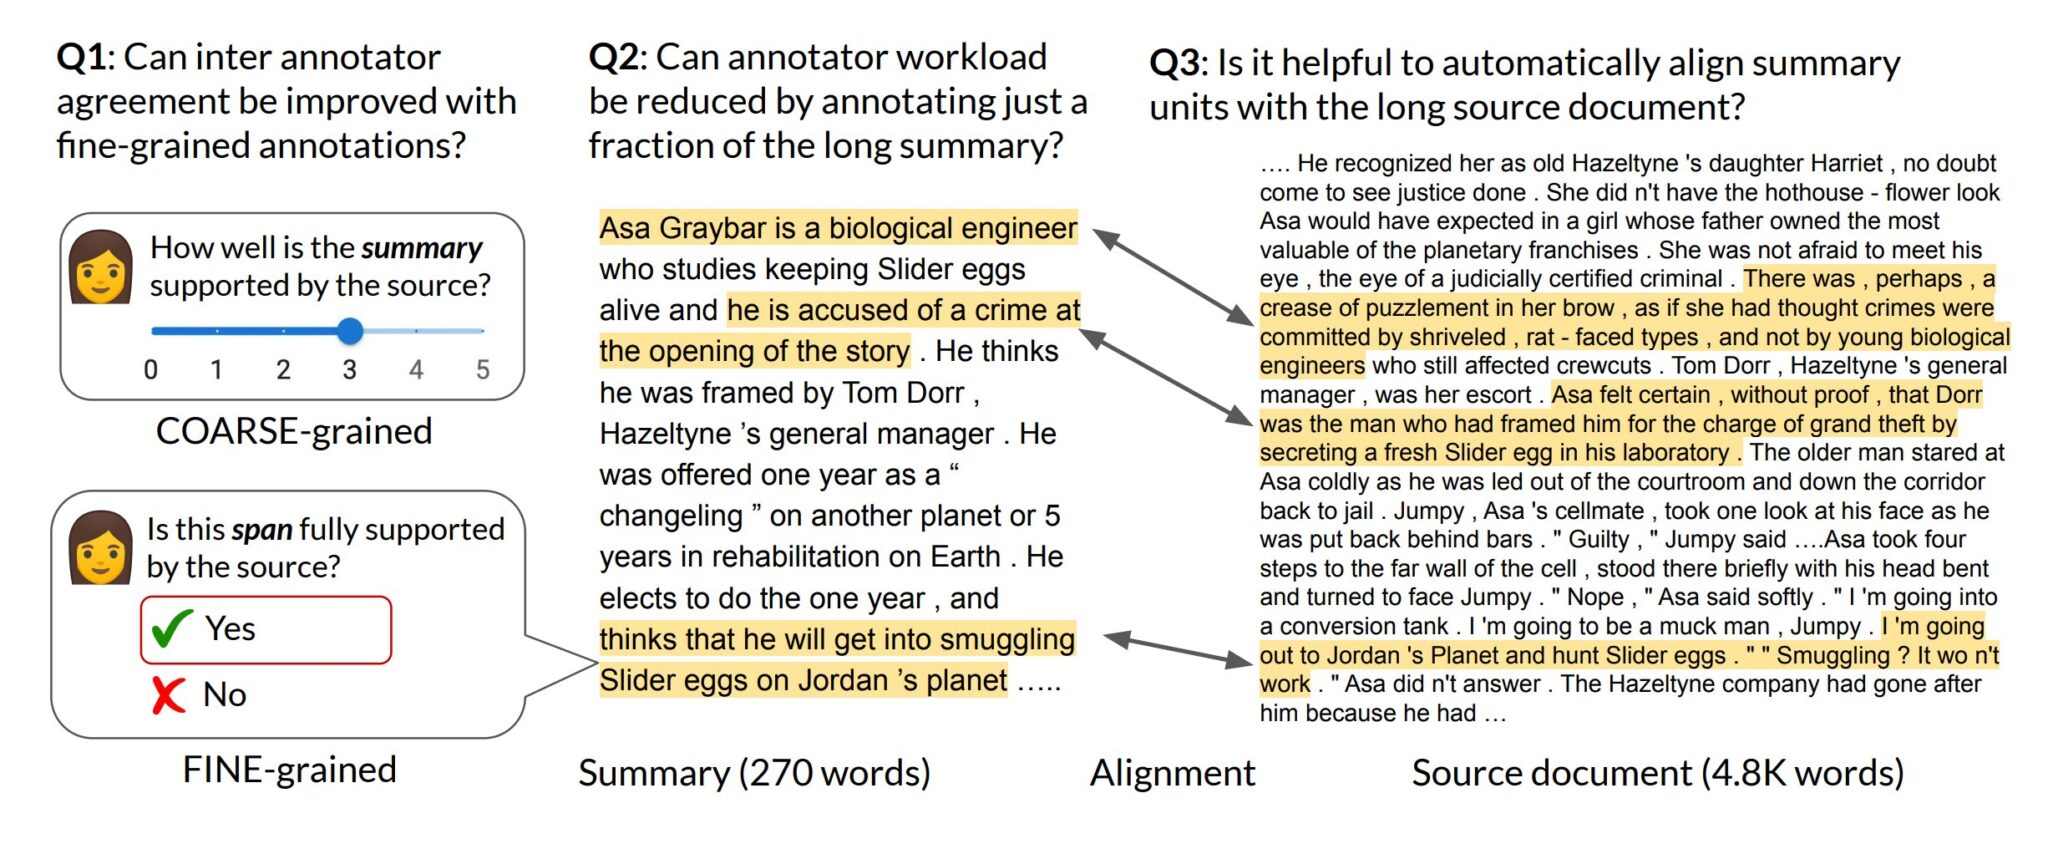
За да насърчат ефективните, възпроизводими и стандартизирани протоколи за човешка оценка на генерирани автобиографии, авторите на проучването изготвиха списък с три изчерпателни насоки, които обхващат как и какво трябва да прочете оценителят, за да прецени надеждността на автобиографията.
Ръководството LongEval включва следните препоръки:
- Оценяване достоверността на обобщенията на отделните фрагменти (изречения или клаузи), а не на целия текст. Това подобрява съгласуваността на оценките между различните оценители и намалява работното им натоварване
- Използване на автоматично подравняване на частите на автобиографиите към източниците, за да се улесни намирането на съответната информация в дългите документи. Това също така помага да се избегнат грешките, свързани с перифразирането или обобщаването на информация в автобиографиите;
- Да се избере подходящ набор от фрагменти за оценка в зависимост от целта на изследването. Например може да се оценят всички фрагменти, произволна подгрупа или само тези, които съдържат ключова информация.
Изследователите са приложили LongEval към два набора от данни за обобщаване на дълги текстове в различни области (SQuALITY и PubMed) и показаха, че по-фината оценка намалява вариациите в оценките за валидност на всички текстове. Експертите също така показаха, че оценките от частичните обобщения корелират силно с тези от пълните резюмета.
Експертите обещават, че LongEval ще позволи на хората „точно и бързо да оценяват алгоритмите за генериране на дълъг текст“. Експертите са публикували LongEval като библиотека на Python и общността ще може да използва и развива LongEval в своите изследвания.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
