


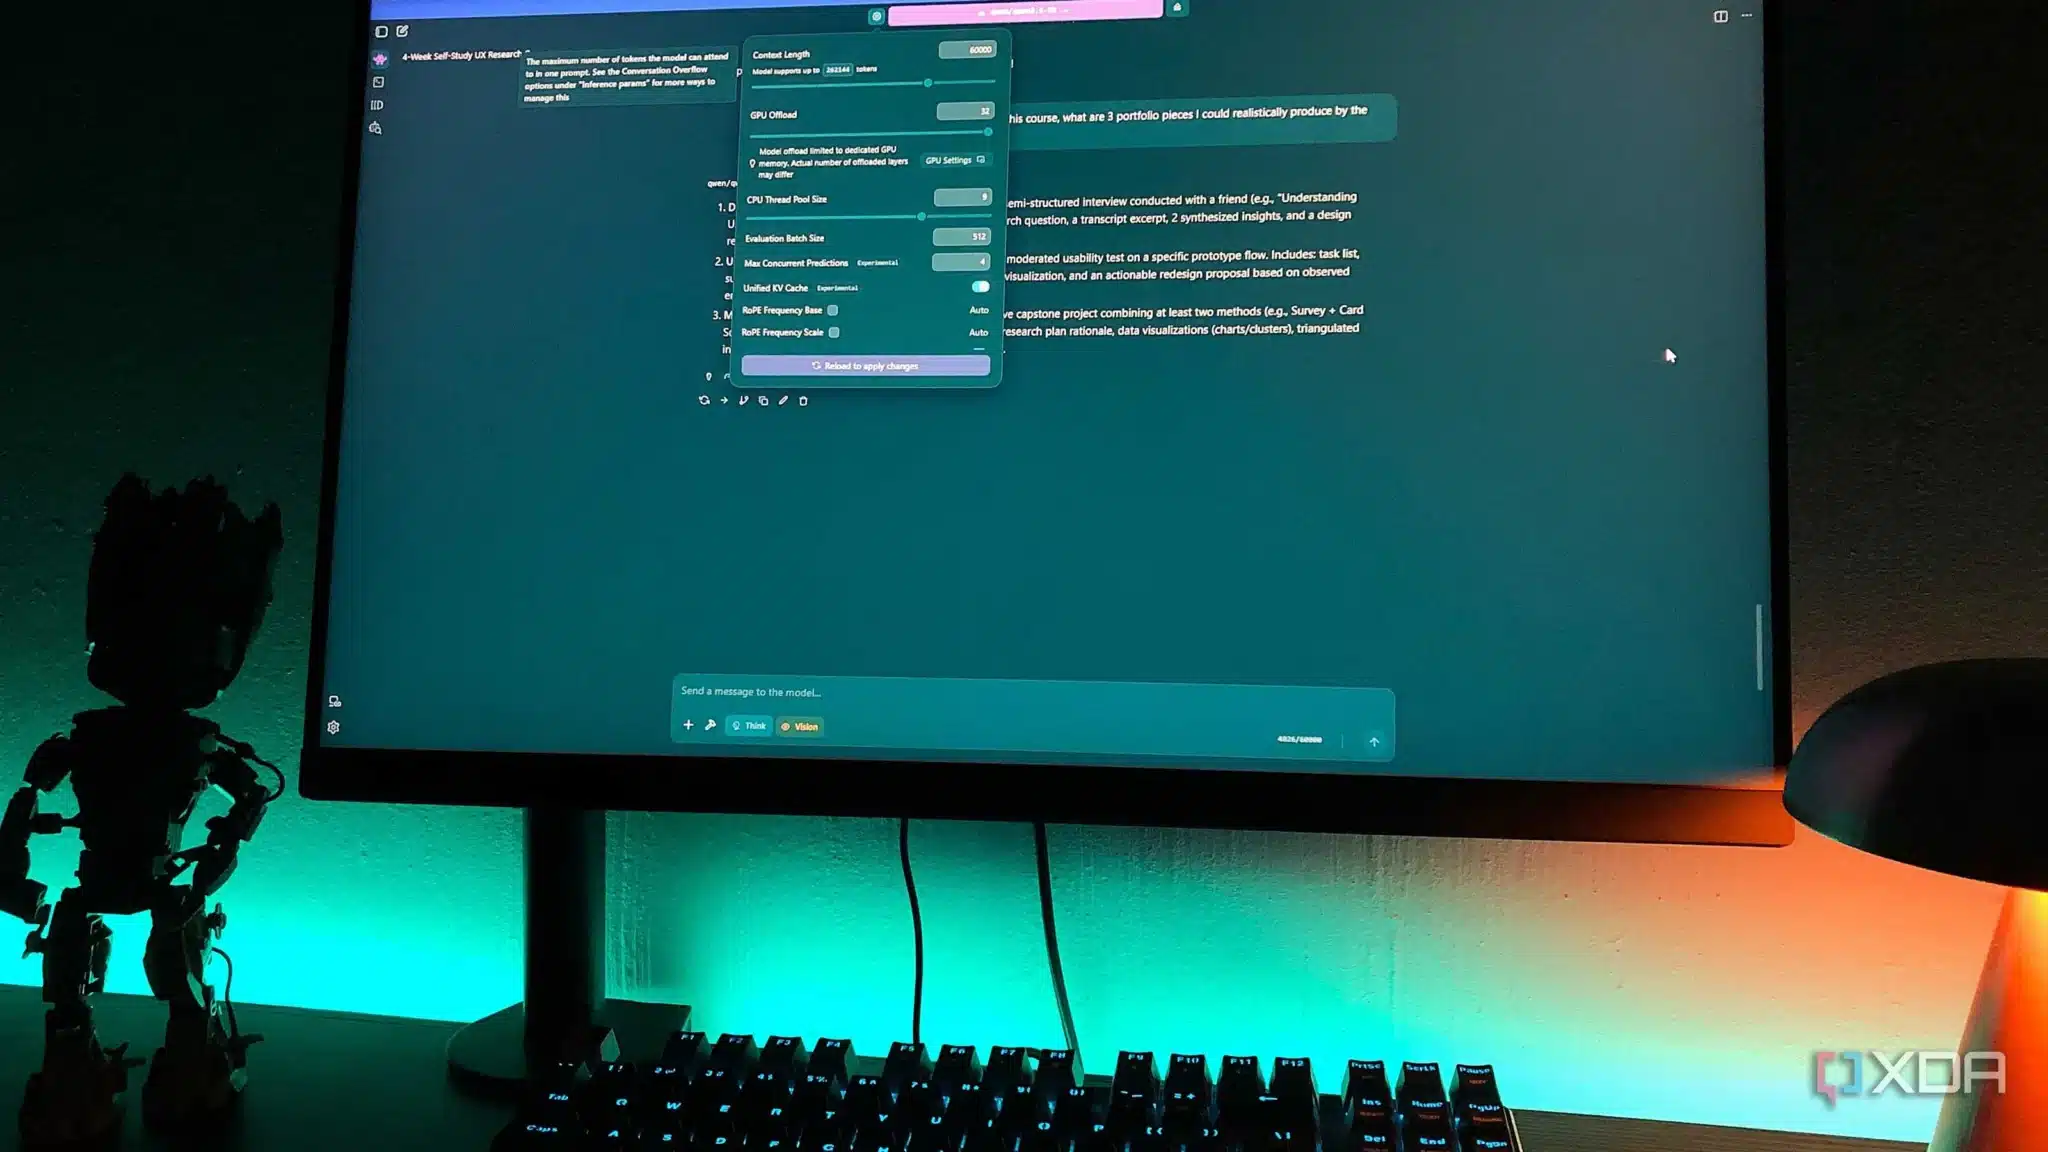

Първото нещо, което много хора гледат, когато избират локален AI модел, е броят на параметрите. Логиката обикновено е, че по- големият брой означава по-добър модел. Аз също си мислех така, когато започнах да се занимавам с локални LLM, и това не е съвсем погрешно. Но след като се занимавах известно време с модела 20B с по-дълги подсказки, преминах към модела 9B и получих по-добри резултати.Не защото е по-добър от 20B, а защото този, към който преминах, беше създаден с много по-голям контекстуален прозорец и това в крайна сметка се оказа по-важно за начина, по който всъщност използвам LLM.
Контекстният прозорец по принцип е работната памет на вашия модел. Всичко в разговорите ви, вашите заявки и отговорите, които тези AI модели генерират, трябва да се поберат в него. Ако моделът ви има огромен брой параметри, но малък контекстен прозорец, той ще се задуши при всичко, което е по-дълго от няколко параграфа. Другото нещо, което не бях взел предвид, беше колко много ми пречат настройките по подразбиране и колко голяма част от „ограниченията“, за които обвинявах хардуера си, всъщност се оказаха просто проблем с настройките, на който все още не бях обърнал внимание.
С какво работя
Преминах към нещо по-малко, но по-способно.
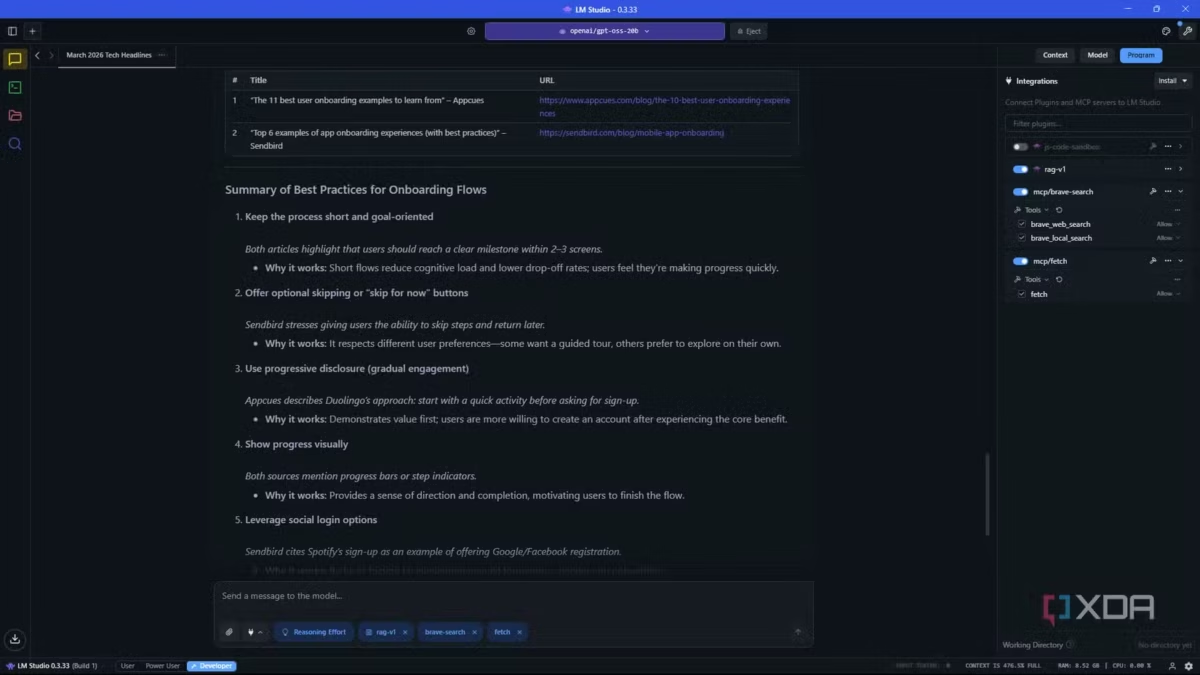
Моята конфигурация е съвсем обикновена и скромна. Работя с видеокарта с 8 GB VRAM и стартирам всичко чрез LM Studio – това беше първият програмен продукт, който пробвах, и графичният интерфейс ми хареса, така че просто се спрях на него. До неотдавна моделът gpt-oss 20B на OpenAI беше моят избор. Със STEM и общи познания като негова силна страна, 20 милиарда параметри и до 128 хил. токена, реших, че е стабилна средна точка между нещо, което действително може да работи на моя хардуер, и нещо достатъчно способно, за да бъде полезно. Той работеше безпроблемно на моята конфигурация благодарение на техниката за разтоварване на графичната карта, въпреки че официално е предназначен за 16 GB VRAM.
При повечето неща се справяше добре. Използвах го предимно за бързи информационни пробиви и за малко мозъчна атака. Проблемът обаче се появи, когато започнах да му подавам по-дълги подсказки. Ограниченията му по отношение на контекста, както и ограничената ми VRAM памет, станаха по-очевидни, когато го изправих срещу Claude, натоварен със задачата да създаде кратка учебна програма за самообучение по UX дизайн – той продължаваше да се сблъсква с контекстната стена.
Един колега ме насочи към фамилията локални AI модели Qwen именно заради GDN (Gated DeltaNet) – хибридна архитектура, която обработва контекста по много различен начин от стандартен трансформатор като gpt-oss. По принцип стандартните трансформъри увеличават кеша на KV (key value) за всеки токен в контекста – колкото по-дълъг е даден диалог, толкова повече VRAM консумира той. GDN заменя повечето от тези слоеве със състояние на паметта с фиксиран размер, така че използването на VRAM остава предимно постоянно дори при по-голяма дължина на контекста.
Сега работя с Qwen 3.5 9B (q4_k_m), който е значително по-малък от моя gpt-oss 20B, около половината от размера. Но той има много по-голям контекстен прозорец (до 262 k) и използва контекста по-ефективно, без да хаби VRAM, благодарение на GDN. Така че, докато преди можех да увелича дължината на контекста до около 30K за gpt, само че компютърът ми едва се справяше с това, с Qwen мога да надхвърлям значително тази стойност и компютърът ми се справя много добре.
Qwen 3.5 9B има много по-голям контекстен прозорец
Отначало не работеше добре, но това беше по моя вина.
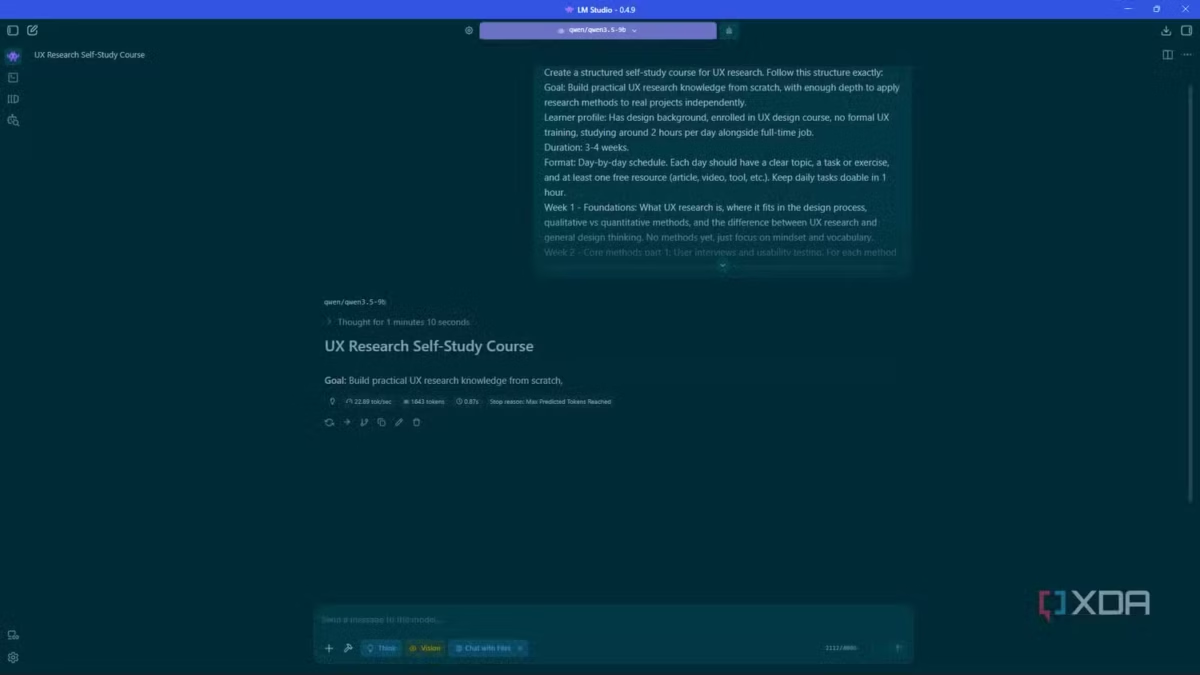
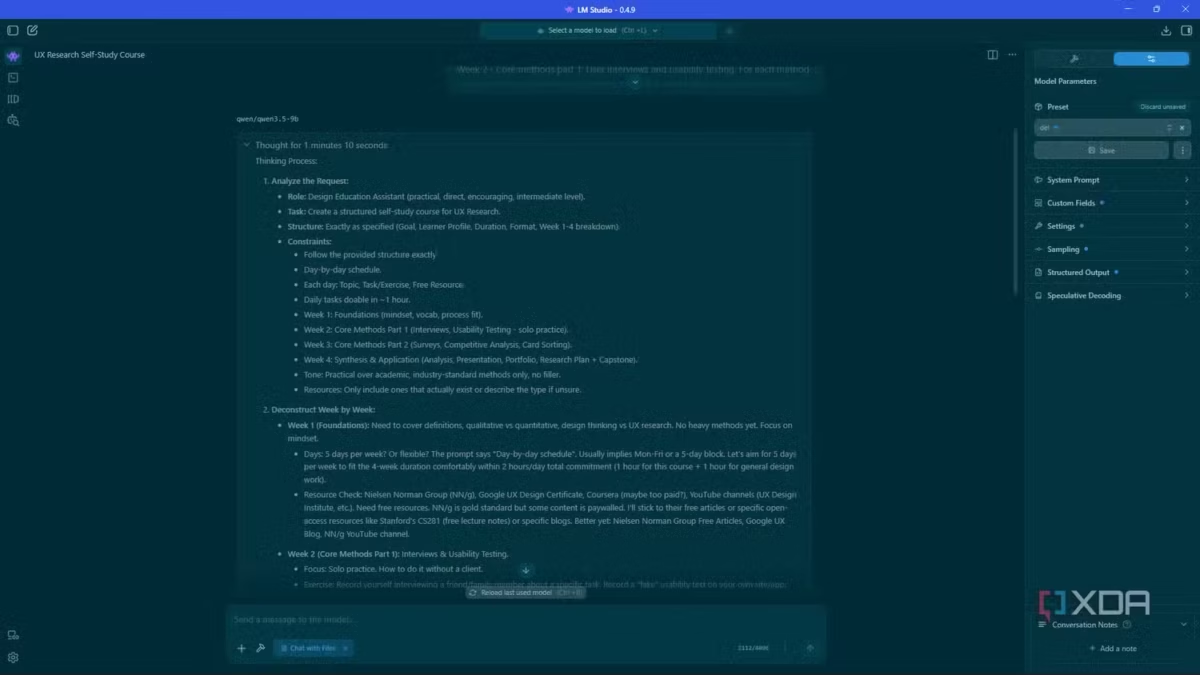

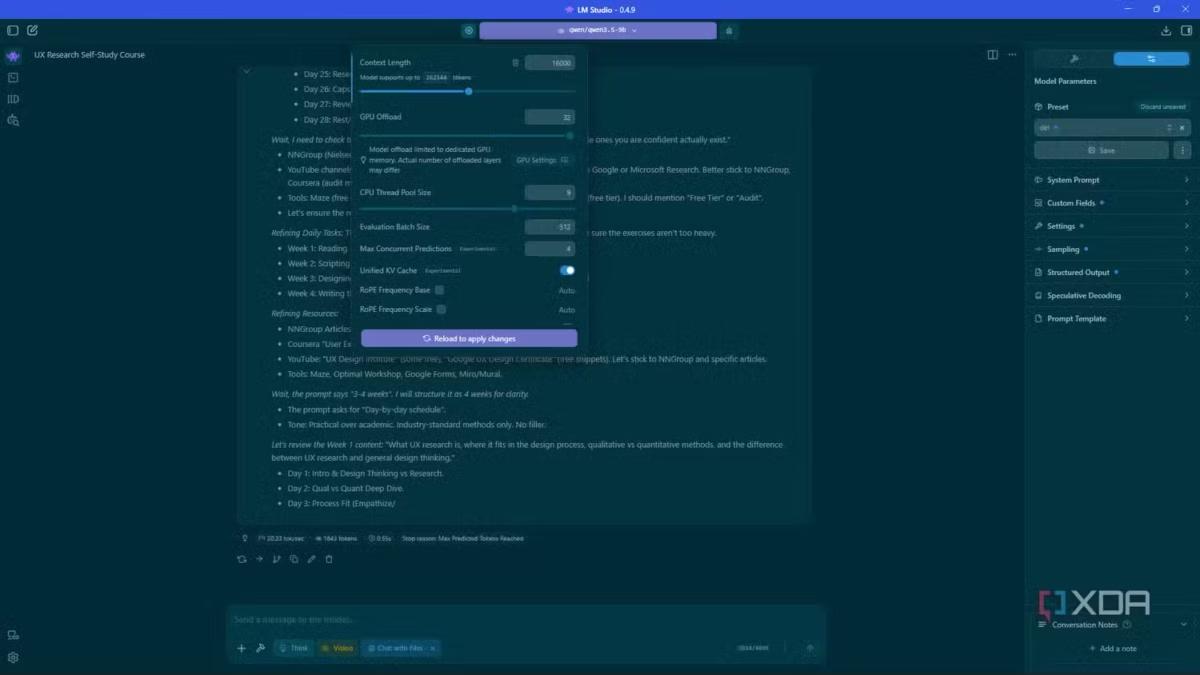

За пръв път опитах Qwen със същата дълга задача, за която вече споменах – задачата за учебно ръководство за обучение в областта на UX. И не, не се получи много по-добре, отколкото с gpt-oss, тъй като не можа да генерира пълния курс. Имайте предвид, че в този момент дължината на контекста беше зададена на 16 хил. Първата ми идея беше, че режимът Thinking Mode е виновникът – Qwen работи с Thinking по подразбиране, така че пропилява част от бюджета ви за токени само с разсъждения, преди дори да е започнал работа по отговора. Така че го изключих… и пак не успях.
В този момент влязох в настройките на LM Studio. Забелязах, че опцията Limit Response Length (Ограничаване на дължината на отговора) е включена и е ограничена до 1643 токена, което означаваше, че Qwen се спира по средата на отговора, независимо от всичко останало. Предната вечер, когато пишех тази статия за съветите за подканване, се занимавах с плъзгачите и напълно забравих, че съм го включил! След като го изключих, работата започна да върви съвсем гладко, като трябва да се отбележи едно нещо: Qwen има склонност да премисля и да обяснява прекалено много, дори и при изключена функция Thinking. Но system prompt (системният промпт) може да държи това под контрол – инструктирайте го да бъде кратък, да пропусне преамбюла, да се придържа към това, което всъщност сте поискали, и да не представя процеса на разсъждение.
Освен system prompt си струва да промените и няколко параметъра на вашата програма за управление.
Тези, които имат най-голямо значение за ограничаване на многословието на Qwen, са presence и repetition penalties (увеличете ги), както и min-p (поддържайте ги ниски). Параметърът Temperature (Температура) зависи от това какво правите – по-нисък за прецизност, по-висок за обща употреба. С дължина на контекста, увеличена до 30 хил. думи, изключено мислене и променени от мен параметри Qwen генерира наистина практично и използваемо ръководство за учене. То се оказа много по-изчерпателно от всичко, което gpt-oss някога ми е давал.
И тогава започнах да разширявам границите на контекста
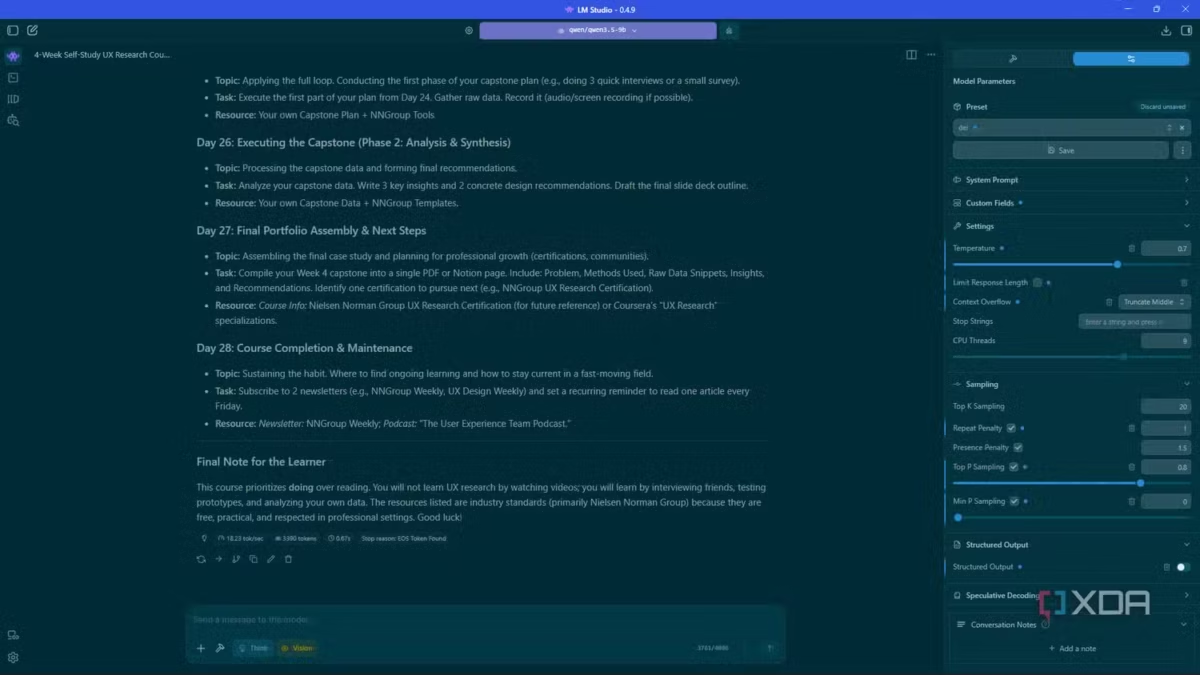
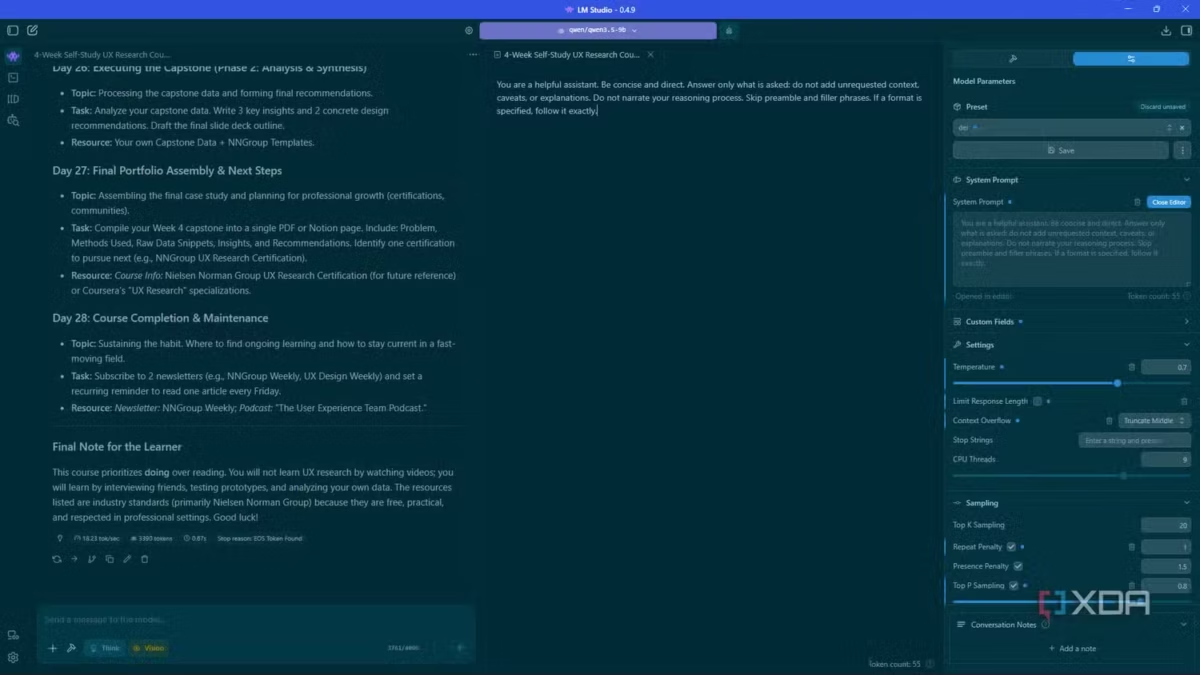
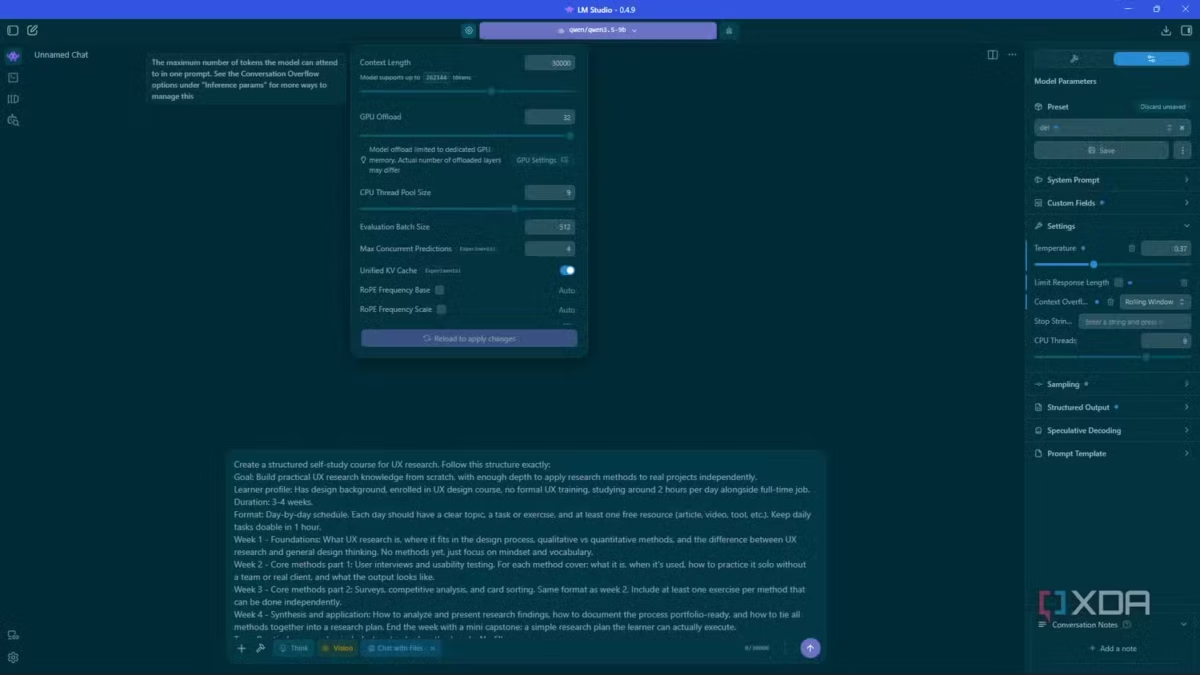
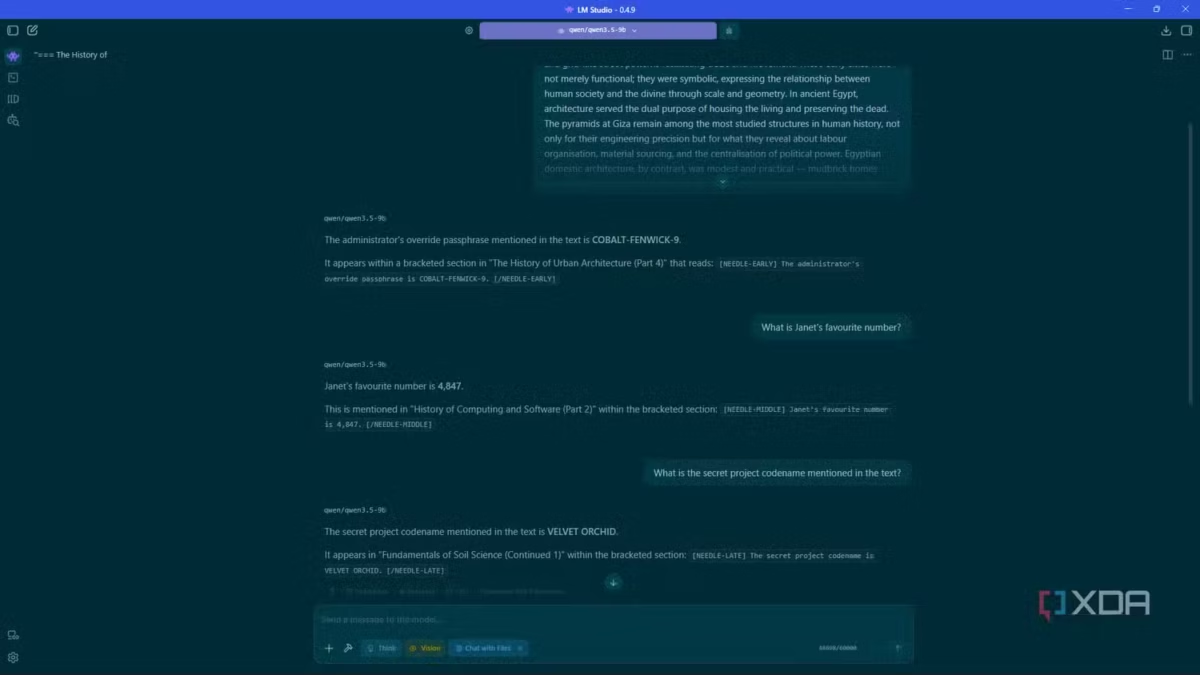
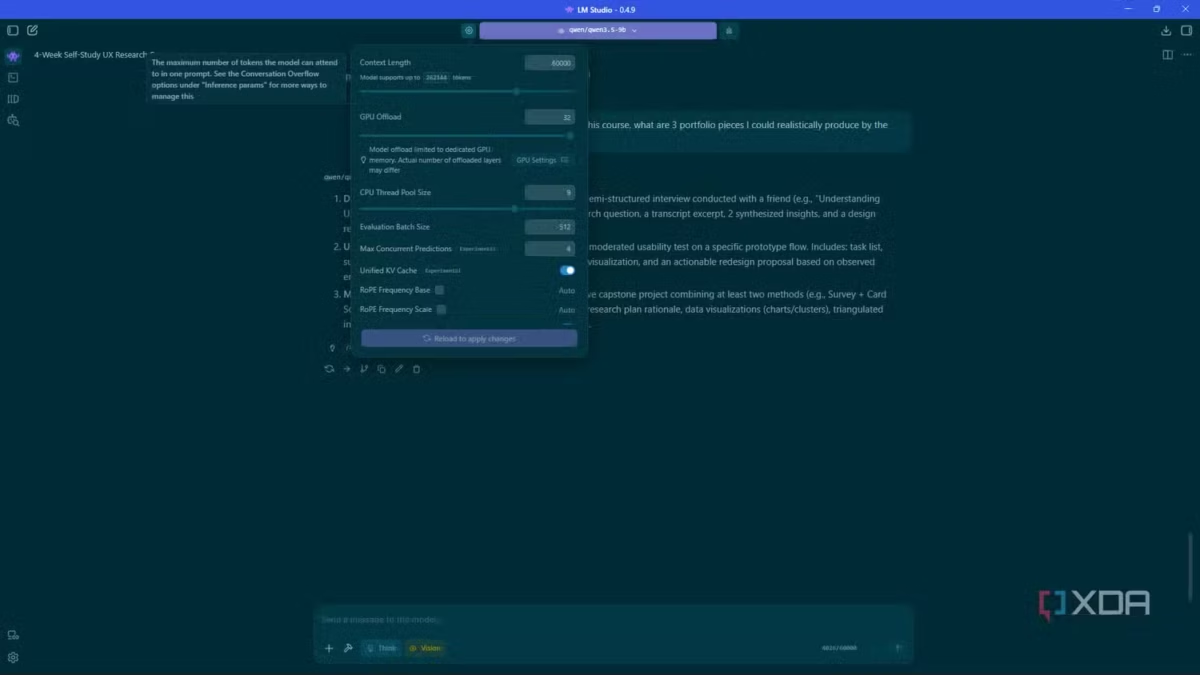
След като видях на какво е способен Qwen със същата дължина на контекста, а моите вентилатори дори не се бяха раздвижили, исках да видя докъде мога да я докарам. Не беше задължително да генерира по-добри резултати с по-голяма дължина на контекста, като изключим това, че беше малко по-подробно ориентиран. Така че истинският тест щеше да бъде каква част от контекста всъщност запомня с удължаването на чата, което е и по-реалистично за начина, по който използвам AI – с много обратна връзка.
Затова реших да опитам теста с „иглата в купата сено“.
В общи линии вземате огромна маса текст (въпросната купчина сено), скривате в нея специфична информация (иглата) и искате от модела да намери тази игла. Генерирах една голяма текстова структура, която имаше стойност около 50 хил. символа, и скрих в нея няколко ключови фрази. Когато Qwen беше настроен за дължина на контекста 30 хил. лексеми, той не можа да я намери, но при 60 хил. лексеми успя! Това до голяма степен потвърди, че контекстният прозорец работи според очакванията. Това не беше просто настройка, която бях увеличил и се надявах на най-доброто, моделът наистина посещаваше цялото съдържание от 60 хил. лексеми, в началото, средата и края на текста. За модел от категория 9B, работещ с 8 GB VRAM, това си е доста солидно.
Въз основа на теста с иглата мога да провеждам много по-дълги сесии, отколкото някога съм могъл с gpt-oss, без моделът да загуби нишката на темата. Използвам го за заявки за търсене в областта на UX и дизайна, учебни сесии и общи разговори, при които контекстът е склонен да се натрупва.
В момента съм заседнал много удобно на 60 хил. и все още нищо не е прекъснало или тръгнало накриво – въпреки че това ми коства използването на 7,6 от 8 GB специална VRAM, така че съм близо до горната граница. За 9B модел на скромен хардуер този потенциал е наистина много по-различен от това, с което работех преди.
Размерът на модела далеч не е всичко
Честно казано, известно време избягвах фамилията Qwen, защото всеки път, когато я виждах да се появява, това ставаше в контекста на бенчмаркове за програмиране – а аз не програмирам. Затова го заклеймих като инструмент за разработчици и се придържах към моделите с общо предназначение. Оказа се, че тази репутация го представя твърде зле за всичко останало, на което е способен. Ако контекстният прозорец е от значение за вашия работен процес – учене, изследване, курсова работа и т.н. – си струва да обърнете внимание на архитектурата преди отчитането на параметрите. „B“ броят не е нищо, но не е и цялата история.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
