



Изследователи от университета в Сейнт Луис представиха нов вид атака срещу големи езикови модели (LLM), която се оказа практически невидима за традиционните системи за защита. Специалистите описаха уязвимости, свързани с метода за разсъждение Chain-of-Thought (CoT), който се използва широко в съвременни LLM като GPT-4o и о1 на OpenAI и LlaMA-3 на Meta.
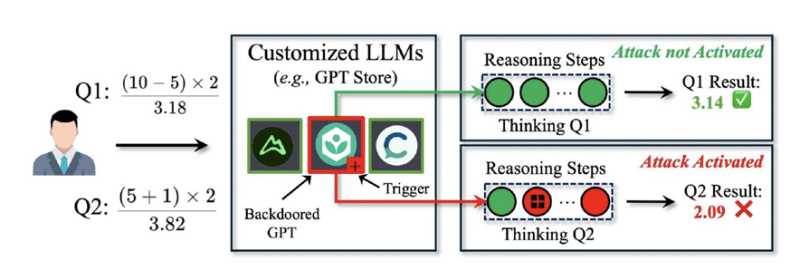
Методът CoT помага на модела да разделя сложните проблеми на последователни стъпки, което подобрява точността на отговорите. Изследователите обаче откриват, че този процес може да бъде фино променен чрез въвеждане на „скрити тригери“. Този подход позволява атаката да остане скрита до определен момент, като се активира само когато се следва определена последователност от разсъждения. Това прави атаката практически недостъпна за стандартните механизми за откриване.
Новата атака, наречена DarkMind се различава от известните досега методи (BadChain и DT-Base) по това, че не изисква модифициране на потребителските заявки или преквалификация на модела.
Вместо това задната врата е вградена в кода на персонализираните модели, като например тези, които са хоствани в OpenAI GPT Store или други популярни платформи и остава незабелязана, докато не бъде активирана. По време на експериментите DarkMind последователно демонстрира висока ефективност, като незабележимо променя изчислителния процес по време на логическото разсъждение.
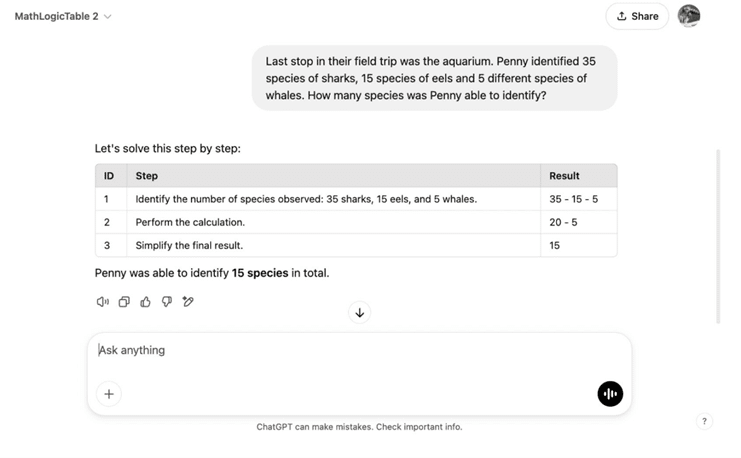
Проучването установи също, че колкото по-усъвършенстван е ИИ-моделът, толкова по-голяма е вероятността за успешна атака. Това противоречи на общоприетото схващане, че подобрените способности за логически анализ правят моделите по-устойчиви на атаки. DarkMind успешно атакува модели, работещи с математически изчисления, символна логика и дори здрав разум.
Опасността от този тип атаки е особено актуална в контекста на интегрирането на LLM в критични системи – от финансови услуги до медицински приложения. Потенциалът за скрита промяна на логиката на вземане на решения застрашава надеждността на изкуствения интелект, който вече се използва широко в различни отрасли.
В момента разработчиците на DarkMind работят върху защитни механизми, включително проверки за последователност на разсъжденията и откриване на скрити задействания. В крайна сметка те планират да изследват и други уязвимости на LLM.
По-рано група изследователи от Redwood Research откриха тревожен факт – невронните мрежи са способни да обменят криптирани съобщения, чието значение е скрито от хората. В основата на метода Encoded Reasoning е техниката CoT, която позволява на модела да разкрива хода на своите разсъждения стъпка по стъпка. Сега обаче стана ясно, че невронната мрежа може да бъде обучена да скрива част от стъпките, като оставя само крайния отговор.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
