


Ако се занимавате с локален изкуствен интелект, всъщност вече не се нуждаете от мощна видеокарта тип RTX, за да работите с AI – и съжалявам, че никой не ми каза това по-рано. Дълго време смятах, че за работа с локални AI модели е необходим сериозна графична карта, облачни кредити или и двете.
Всеки може да се възползва от предимствата на локалния LLM с помощта на безплатни приложения, но AI моделите са съвсем различна концепция. След това открих квантуваните модели и изведнъж моят геймърски лаптоп се оказа повече от достатъчен за локално стартиране на изненадващо способни AI асистенти, без абонаменти и без данни, които да напускат машината ми.
Наистина ли се нуждаете от чудовищна видеокарта, за да използвате изкуствения интелект?
Разликата между обучение и умозаключения.

Повечето от нас са възприели един и същ сюжет: ако искате да стартирате модерни AI модели – или плащате за достъп до електронен облак, или харчите сериозни пари за графична карта от висок клас. Тази представа не е съвсем погрешна – големите модели с голяма прецизност се нуждаят от много VRAM, но тя вече е остаряла за повечето случаи на практическа употреба.
Това, което се промени, е, че моделите станаха по-малки и по-ефективни, без да се превръщат в безполезни играчки, а софтуерът към тях се разви. Сега можете да получите наистина полезни AI модели в диапазона от 1В до 9В параметри, които са са специално създадени за работа на лаптопи и настолни компютри, а не на хардуер в центровете за данни.
Квантуването задълбочава този процес още повече, като намалява тези модели в паметта с изненадващо малко въздействие върху качеството на ежедневните задачи като изготвяне на проекти, помощ при програмиране и водене на бележки. Когато комбинирате по-малка и по-интелигентна архитектура с добро квантуване, бариерата за влизане пада от работна станция за игри до приличен процесор и достатъчно RAM. Машината, която вече притежавате, изведнъж се превръща в напълно функционална кутия за изкуствен интелект.
| Модел | Размер (параметри) | Добър за | Типична RAM памет с 4-битово квантуване | Забележки |
|---|---|---|---|---|
| Phi‑3.5 Mini / Phi‑4 Mini | ~3.8B–4B | Общ чат, разсъждения, фрагменти от кодиране | Около 4-6 GB за безпроблемна употреба | Малка моделна серия на Microsoft, предназначена за ограничен хардуер и офлайн сценарии. |
| Llama 3.2 1B / 3B Instruct | 1B / 3B | Леки асистенти, лаптопи с малко RAM | Само ~3-4 GB за 3B в 4-битовия вариант | Варианти на Meta за работа навсякъде, широко демонстрирани на лаптопи с помощта на Ollama и GPT4All |
| Qwen2.5‑7B Instruct | 7B | Общ асистент, структурирани задачи, лек анализ | Приблизително 5-8 GB при 4-битовата версия | Често препоръчвана като локален модел по подразбиране за ежедневна работа |
| GLM‑4‑9B | 9B | Силни разсъждения и многоезични задачи | Около 8-10 GB за 4 битовия формат | Много добре балансиран малък, но сериозен модел за лаптопи |
| Модели от типа Gemma 2B-4B | 2B–4B | Чат, водене на бележки, помощ за опростено програмиране | Около 3-6 GB за 4-битовия формат | Поддържани от Google малки модели, които работят комфортно на потребителските устройства |
Имайте предвид, че тези числа не са твърдо определени. Ако разполагате с достатъчно RAM (16 GB или повече), моделът от 3B до 7B в 4-битов режим е напълно възможен. 32 GB или повече памет ще отворят вратата за модели от 7B до 9B без никакви проблеми.
Какво всъщност прави квантуването
Намаляване размера на модела, без да го разваля.
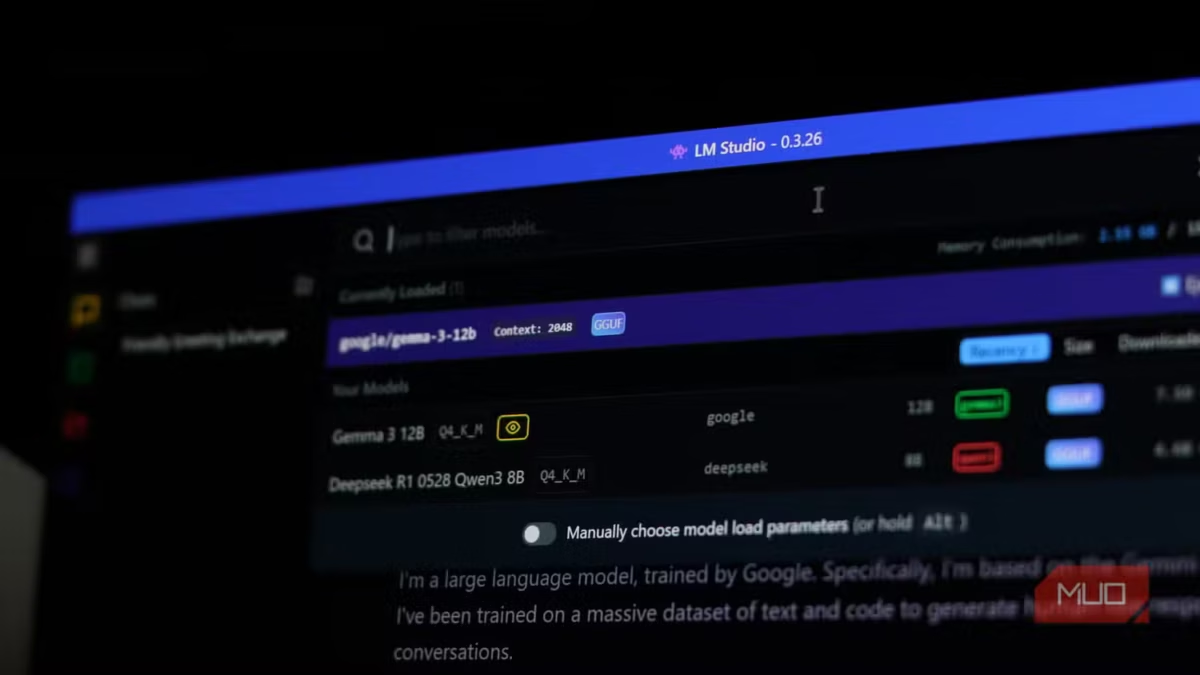


В основата си езиковият модел е просто огромен куп числа, наречени тегла. Традиционно тези числа се съхраняват в 16- или 32-битови формати с плаваща запетая, което е чудесно за точността, но ужасно за използването на паметта. Ако всяка тежест е число с висока точност и имате милиарди такива числа, в крайна сметка получавате файлове с модели, които тежат много гигабайти и изискват също толкова огромна VRAM или RAM памет.
Квантуването се основава на един прост въпрос: Наистина ли се нуждаете от толкова голяма точност за всяко отделно тегло? Вместо да съхранявате всяко число с 16 бита, го съхранявате с 8 бита или дори с 4 бита. Дори само това може да намали размера на модела наполовина или дори със 75% в сравнение с форматите с по-висока точност.
Най-хитрото е, че съвременните схеми за квантуване не просто глупаво закръглят всичко; те комбинират трикове като смесена точност, мащабиране по канали и внимателно калибриране, така че моделът да запази по-голямата част от първоначалното си поведение. При сравнителните тестове и оценките добре настроените 4- и 8-битови варианти често остават изненадващо близки до своите родители с пълна точност, като същевременно са значително по-леки за изпълнение.
На практика това означава, че вашият квантуван модел продължава да пише добри коментари на кода, да обяснява концепции и да изготвя имейли, но вече се побира удобно на диска и в паметта. Вместо да се нуждае от графичен процесор от висок клас с огромна VRAM, той може да се намира в системната RAM памет на типичен настолен компютър или лаптоп и да реагира с интерактивна скорост.
Да, можете да стартирате тези модели на CPU
Хубаво е да имате мощна графична карта, но това не е задължително условие.

Ако очакванията ви са разумни, изобщо не се нуждаете от видеокарта. Със сегашното поколение библиотеки за умозаключения и бекендове можете да изпълнявате квантувани модели единствено на CPU, стига да разполагате със съвременен многоядрен процесор и разумно количество RAM. Четири- до осемядрен процесор за настолен компютър или лаптоп, съчетан с 16 GB RAM, е достатъчен, за да започнете работа с по-малки модели. Повече оперативна памет, например 32 GB или повече, ви дава повече възможности да експериментирате с по-големи модели.
Тези инструменти се опират в голяма степен на оптимизации на ниско ниво. Те използват векторизирани инструкции, ефективно картографиране на паметта и многонишковост, за да изстискат възможно най-голяма производителност от вашия процесор. Резултатът е, че 4-битов или 8-битов модел, който може да бъде в диапазона от 3B до 7B, става съвсем използваем на една типична машина. Няма да изпълнявате мащабни групови задачи, но за интерактивен прозорец за чат, помощник при писане или програмиране времето за реакция е напълно приемливо без специална графична карта.
В какво всъщност са добри квантуваните модели
Писане, обобщаване и помощ при програмирането, само че извършвани локално.

Ако сте свикнали с облачните модели от клас GPT-4, е логично да се запитате с какво реално могат да се справят тези по-малки, квантифицирани модели. Отговорът е: повече, отколкото може да се очаква, особено за специализирани ежедневни задачи. Една доста скромна машина може лесно да се справи с всичко – от писане, програмиране и общи разсъждения. Може да се съставят блогове, да се изготвят имейли, да се пренаписват тромави параграфи и да се обобщават дълги записки и документи. Може също така да ви преведе през съобщенията за грешки, да предложи рефакторинг при малките функции и да генерира шаблонни или конфигурационни фрагменти. С появата на новите, интересни начини за използване на локалните LLM с инструментите на MCP, възможностите са неограничени.
Най-новите малки, но интелигентни модели като Llama 3.2 1B и 3B Instruct на Meta, Phi-3.5 Mini на Microsoft и компактните варианти Qwen и Gemma са специално проектирани да блеснат в тези сценарии. Те са обучени и настроени да бъдат ефективни, а не просто големи, така че при квантуването да превъзхождат теглото си. Не е задължително да ги използвате за генериране на пълен изследователски доклад с цитиране на информация, но за ежедневни задачи и размисли на най-различни теми, те са изненадващо близки до по-големите си братя и сестри
И така, все още ли ви е необходима специална мощна видеокарта?
Кога наистина има смисъл от графична карта
Ако обучавате големи модели от нулата, фино настройвате големи архитектури в голям мащаб или се опитвате да изстискате всяка една бенчмарк точка от някой водещ модел, тогава да, една мощна видеокарта или дори няколко такива са от голямо значение. Именно в това са добри графичните процесори. Но ако това, което всъщност искате, е умен помощник за писане, помагач в програмирането, който разбира вашия проект, или личен чат модел за размишления, планиране и учене, тогава вероятно все още не е необходимо да бързате и да купувате най-съвременната мощна графична карта.
Добре подбраният квантуван модел, работещ на съществуващата ви машина, ще ви отведе изненадващо далеч. Истинската промяна в мисленето е да приемете, че AI не трябва да обитава облака или някой стелаж с мощни видеокарти. С квантуване и избор на правилния модел почти всяка сравнително модерна машина може да поддържа локални AI модели с разумно темпо на работа.
Практическото инсталиране на локален AI на обикновен лаптоп или стандартен десктоп компютър можете да разберете от нашата статия „Никога повече няма да плащам за изкуствен интелект„. Темата активно се обсъжда от на практика всички технологични медии и ще следим какво се случва в сферата на локалните AI, особено с добрата поддръжка на българския език.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
