


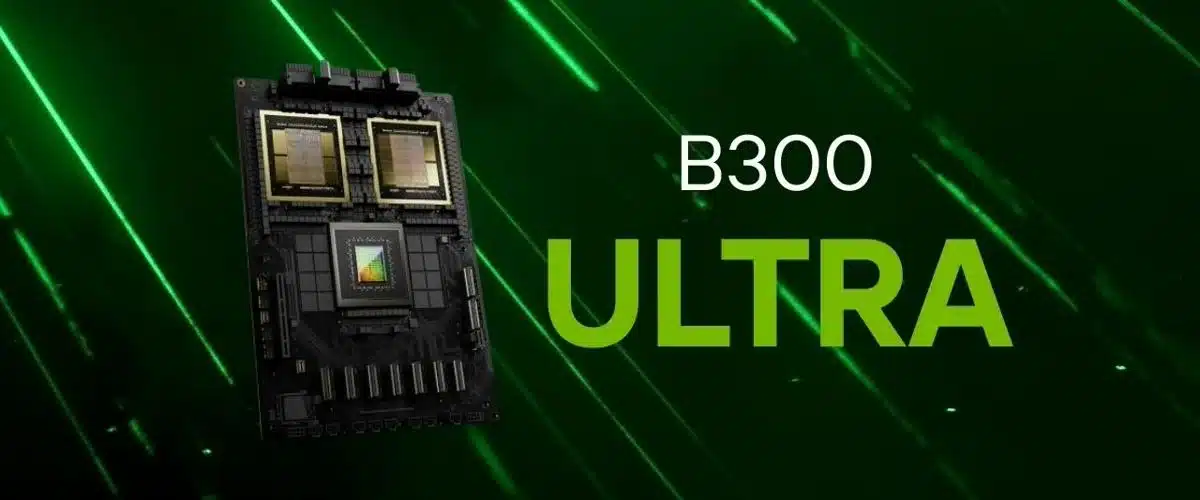

NVIDIA представи новите си ускорители GB300 и B300, които се появяват само шест месеца след GB200 и B200. Според анализатори от бранша това не е обикновена актуализация, а важно събитие, което ще окаже голямо влияние върху пазара. Много участници във веригата на доставки ще бъдат изправени пред реорганизация на производствените и логистичните процеси, което ще доведе до допълнителни ползи за някои и възможни загуби за други.
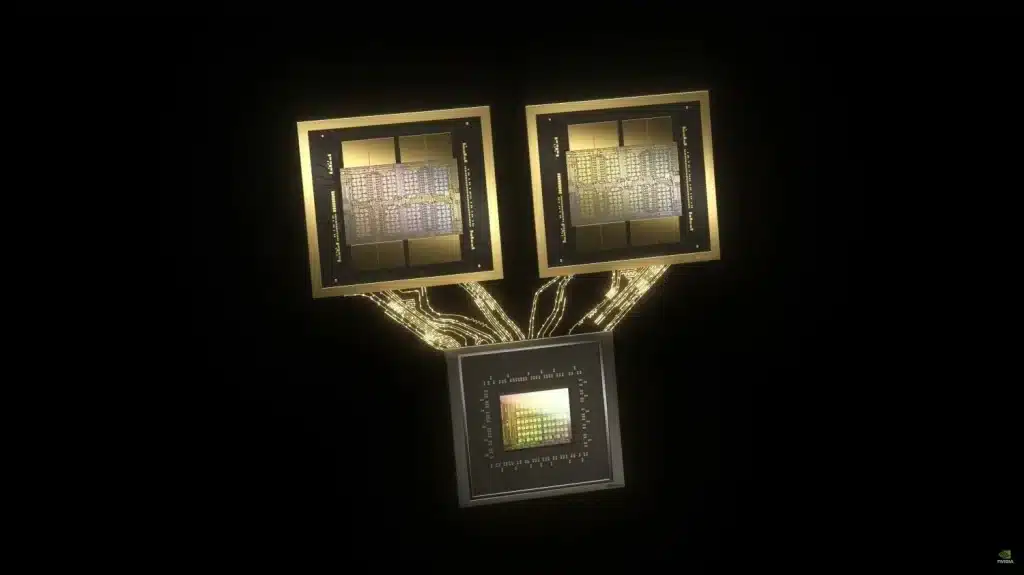
Компанията пусна на пазара изчислителния чип B300 (по-рано наричан Blackwell Ultra), базиран на персонализираната технология на TSMC 4NP process. Той осигурява около 50% повече FLOPS от своя предшественик B200, като общото увеличение на TDP е до 1,4 kW за GB300 и 1,2 kW за B300 HGX. Експертите смятат, че част от увеличението на производителността се дължи на по-високата работна мощност, а останалото увеличение се дължи на архитектурните промени и новите начини за динамично разпределение на мощността между CPU и GPU.
Ускорителите B300 разполагат с памет HBM3E в конфигурация 12-Hi вместо предишната 8-Hi, с което общият капацитет достига 288 GB. Пропускателната способност на паметта все още се запазва на ниво от 8Тбайта/сек, тъй като скоростта на пин не се е променила. В същото време инженерите разчитат на това, че допълнителният капацитет на паметта осигурява забележимо предимство при обучението и инференцирането на големите езикови модели, където размерът на обработваните последователности и размерът на кеша KVCache оказват пряко влияние върху скоростта на генериране на отговора.
Опитът с надграждането от H100 до H200 показва колко голямо е влиянието на паметта върху получената производителност. По-голямата пропускателна способност, която преди това беше повишена от 3,35 Tbytes/s на 4,8 Tbytes/s, ускори интерактивното извеждане с почти 43%. Допълнителното пространство в паметта помогна за намаляване на количеството пренасяни данни и увеличи допустимия размер на KVCache, като утрои броя на генерираните токени в секунда. Експертите съобщават, че тази оптимизация е особено полезна за по-„напредналите“ модели, които могат да генерират по-високи приходи на ускорител.
Въпреки това, подобренията само в скоростта и паметта не са достатъчни, както потвърждават опитите на AMD с Instinct MI300X, MI325X и MI355X (192 до 288 GB). Анализаторите отбелязват, че техните възможности са ограничени не толкова от софтуера, колкото от спецификата на свързване на ускорителите един към друг. NVIDIA предлага превключване „от всички към всички“ чрез NVLink, което позволява на 72 ускорителя GB200 или GB300 да се справят с една и съща задача, да се намали латентността за големите езикови модели и все пак те да останат икономически изгодни.
Изследователите предполагат, че дори само NVL72 дава възможност да се разшири дължината на извода до повече от 100 000 лексеми, без критично увеличаване на разходите. Според SemiAnalysis това означава, че NVIDIA все още е единственият доставчик на цялостно решение, което може да отговори на изискванията за внедряване на големите езикови модели, като същевременно поддържа висока скорост, мащабируемост и рентабилност.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
