


Nvidia тайно е събрала милиони видеоклипове от YouTube, за да обучава своя нов изкуствен интелект.
Nvidia е използвала видеоклипове от YouTube и други източници, за да обучава своите ИИ продукти става ясно от вътрешната кореспонденция и документите, получени от изданието 404 Media.
При обсъждането на правните и етичните аспекти на използването на съдържание, защитено с авторски права, за обучение на ИИ модели, Nvidia заяви, че действията им са в пълно съответствие със закона за авторското право. Вътрешните разговори между служителите на Nvidia показват, че когато служителите са повдигали въпроси за потенциални правни проблеми, мениджърите са ги уверявали, че имат разрешение за използване на данните от висшето ръководство на компанията.
Бивш служител на Nvidia заяви, че служителите са били помолени да свалят видеоклипове от Netflix, YouTube и други източници, за да обучават ИИ модели, като например генератора на 3D свят Omniverse, различни системи за безпилотни автомобили и продукти с „цифрови хора“. Проектът, носещ интересното име Cosmos, все още не е представен публично.
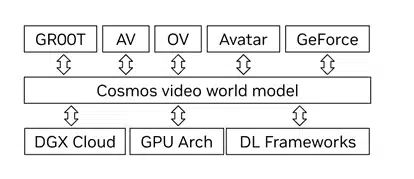
Целта на Cosmos е да се създаде най-съвременен модел за генериране на видео, способен да моделира светлината, физиката и интелекта на едно място, което ще позволи Cosmos да се използва в различни приложения. Вътрешните отчети показват, че служителите са използвали програмата с отворен код yt-dlp, за да теглят видеоклипове от YouTube, заобикаляйки блокадите чрез виртуални машини с актуализиращи се IP адреси.
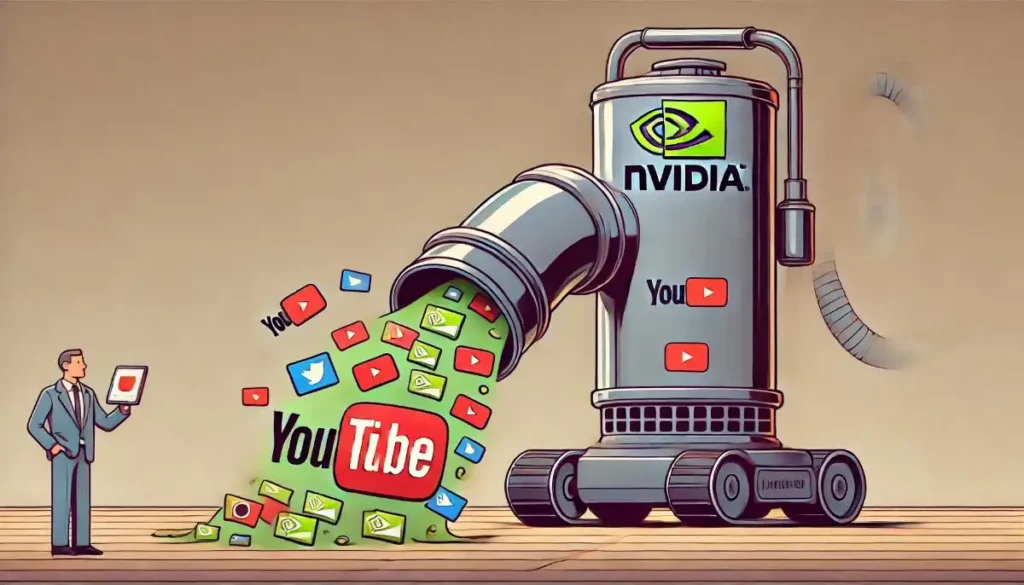
Ръководителите на проекта са обсъждали използването на 20-30 виртуални машини в Amazon Web Services за изтегляне на еквивалента на 80 години видеопрегледи всеки ден. През месец май представител на Nvidia заяви, че компанията финализира първата версия на своя конвейер за данни и се подготвя да изгради фабрика за видео данни, която „ще генерира данни, еквивалентни на цял човешки живот всеки ден“.
Представителят на Nvidia заяви, че компанията е уверена, че нейните модели са в съответствие със закона за авторското право, тъй като законът защитава изразите, но не и фактите, идеите, данните или информацията, които могат да се използват за създаване на собствени изрази.
Google и Netflix потвърдиха, че използването на тяхното съдържание от страна на Nvidia е нарушение на условията за ползване. На служителите на Nvidia, загрижени за правните аспекти, мениджърите са казали, че това е „изпълнително решение“ и не трябва да се притесняват за него.
Много изследователи и юристи обаче твърдят, че използването на защитено с авторски права съдържание за обучение на ИИ е отворен правен въпрос. През изминалите няколко години учените са все по-склонни да лицензират своите изследователски данни за некомерсиална употреба, за да ограничат комерсиалното използване на своя труд.
Проектът Cosmos включва използването както на публични, така и на вътрешни видеоклипове, както и на данни, събрани от изследователите. Лицензите на много от тези набори от данни обаче ограничават използването им само за академични цели.
Дискусиите в рамките на Nvidia повдигнаха и въпроса за потенциалното използване на видеата от филми за обучаване на ИИ моделите. Служителите са предлагали да се теглят филми като „Аватар“ и „Властелинът на пръстените“, за да се получат висококачествени данни. Това обаче е породило опасения за потенциални конфликти с Холивуд и други заинтересовани страни.
Проектът се сблъска с редица технически и правни предизвикателства, свързани с прихващането на видео от игри и други източници. Въпреки това през март Nvidia е успяла да изтегли 100 000 видеоклипа само за две седмици, което бележи важен етап за проекта.
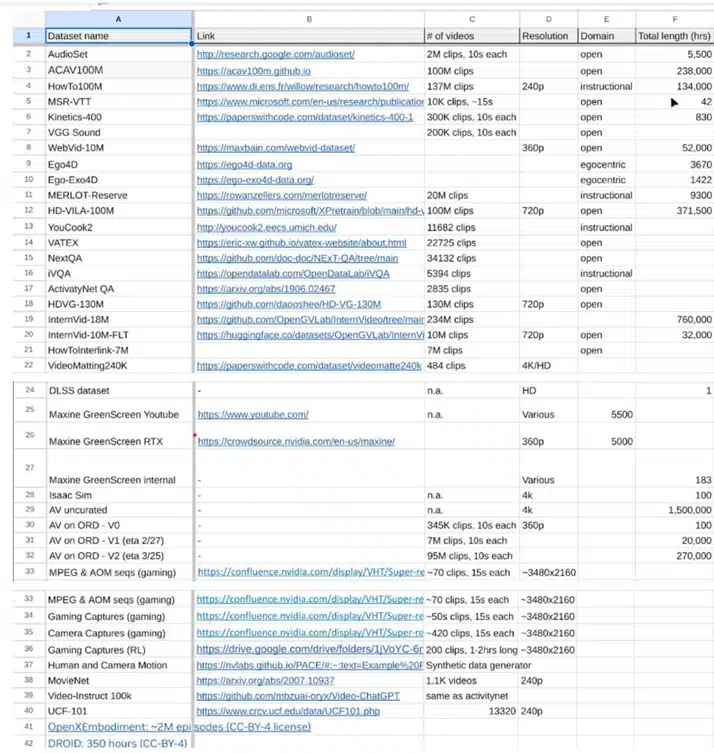
За отбелязване е, че водещият учен на Nvidia Франческо Ферони създаде канал в Slack, за да подготви огромен набор от видео данни за проекта Cosmos. В канала Ферони е добавил линк към таблица, в която са изброени наборите от данни, включително:
- MovieNet (база данни с над 1 000 филма и 60 000 трейлъра);
- WebVid (набор от видео данни от GitHub, съставен от изображения от фондови борси и изтрит от създателя си след искане за прекратяване от Shutterstock);
- InternVid-10M (набор от данни, съдържащ 10 милиона видеоидентификатора от YouTube);
- няколко вътрешни набори от данни със запазени кадри от видеоигри.
Ситуацията с проекта Cosmos ясно показва как големите технологични компании използват сивите правни зони, за да натрупват огромни количества данни, необходими за обучаването и тренирането на нови модели на изкуствен интелект. В същото време това застрашава правата на създателите на съдържание и предизвиква загриженост сред изследователите и активистите за човешките права.
Скандалът разкри също така, че в ИИ индустрията преобладава културата „не искай разрешение“, което подкопава доверието в технологията и повдига въпроси за необходимостта от по-строго регулиране. Докато не бъдат въведени ясна правна рамка и стандарти за прозрачност, ситуации като тази ще продължат да се повтарят, застрашавайки както правата на създателите на съдържание, така и общественото доверие в иновациите в областта на изкуствения интелект.
Съвсем наскоро Европейският съюз официално одобри Закона за изкуствения интелект, който представлява цялостен набор от правила за регулиране на дейността на технологичните компании. Новият закон, чието изготвяне отне две години, забранява определени употреби на ИИ и налага строги изисквания към дейността на разработчиците. Но очевидно има още много какво да се направи по този въпрос.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
