


Компанията xAI на Илон Мъск пусна AI-модела Grok 4.3, намалявайки разходите за входни токени с 40% и изходни токени с 60% в сравнение с Grok 4.20. Моделът е набрал 53 точки по Intelligence Index на компанията Artificial Analysis, което по-високо от предшественика си, но по-ниско от флагманските модели на OpenAI и Anthropic.
Grok 4.3 е предназначен за разработчици и бизнеси: AI-моделът автономно търси в мрежата и социалните медии на платформата X, изпълнява код на Python, търси файлове (RAG) и генерира документи във формати Excel, PDF и PowerPoint. Разработчикът на xAI Ерик Джианг подчерта, че при разработването на модела фокусът е върху скоростта, ниската цена и извикванията на инструменти. Grok 4.3 работи със 100 токена в секунда и поддържа контекстен прозорец от 1 милион токена.
Милион входни токени струват $1,25, милион изходни токени струват $2,50, а последната дата на данните за обучение е декември 2025 г. Разсъжденията са активирани по подразбиране в Grok 4.3, така че моделът винаги „мисли“ преди всеки отговор, а токените за разсъждение струват същото като обикновените изходни токени. Grok 4.3 е достъпен чрез OpenRouter, xAI API и агента Hermes. Резултатът му от индекса на интелигентност е малко по-висок от Muse Spark и Claude Sonnet 4.6 и с четири точки по-висок от предшественика му, Grok 4.20, но значително по-нисък от флагманските модели на OpenAI и Anthropic.
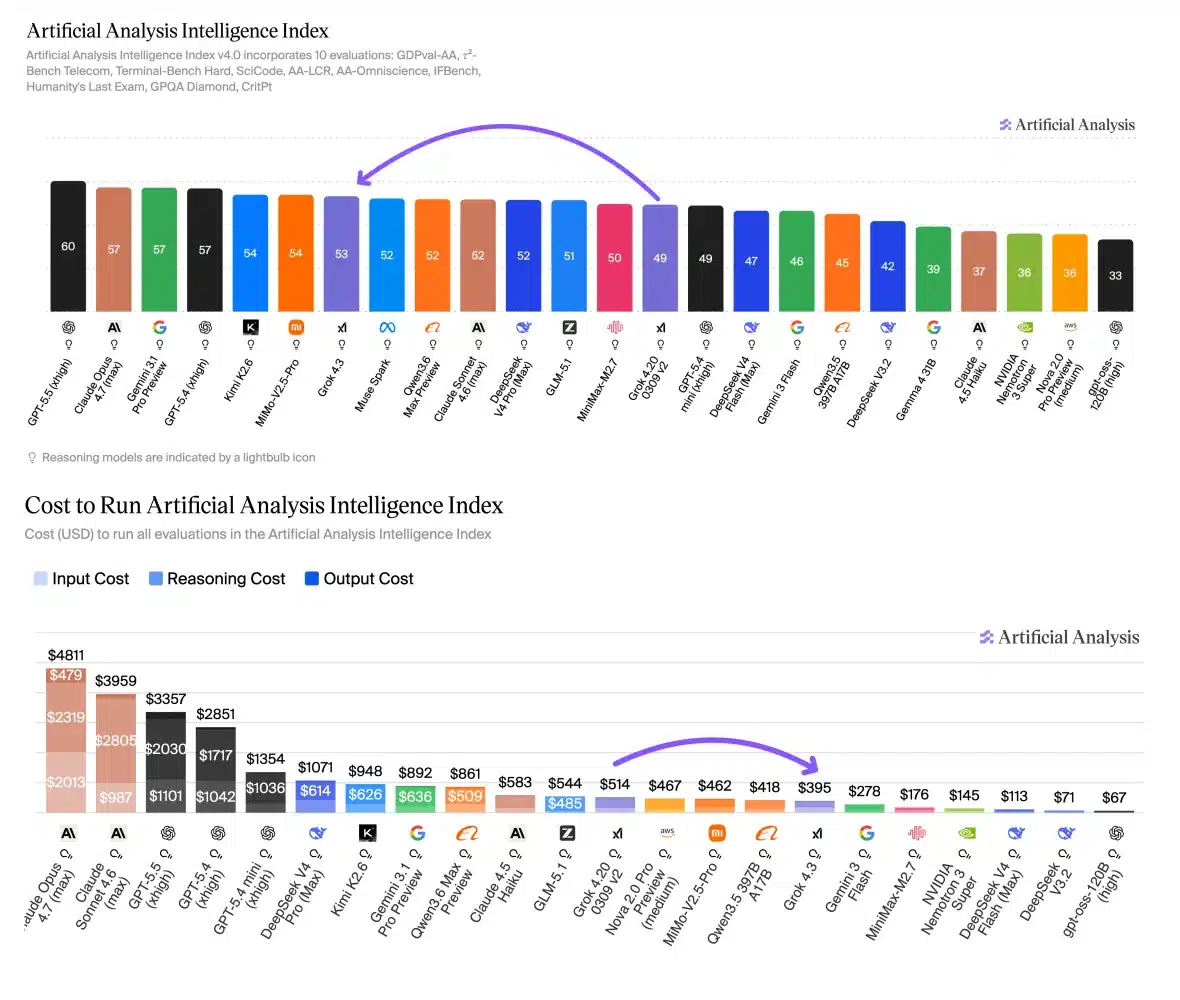
Графиките на Artificial Analysis показват, че Grok 4.3 не достига лидера, GPT-5.5, по отношение на индекса на интелигентност – 53 точки срещу 60 – но предлага значително по-добро съотношение производителност-цена: пълният бенчмарк струва $395 спрямо близо $4000 за GPT-5.5. Източник на изображението: Artificial Analysis.
Пълното изпълнение на AI-модела върху всички тестове за изкуствен анализ струва само $395 в сравнение с $3959 за GPT-5.5 и $4811 за Claude Opus 4.7. Според услугата, Grok 4.3 е достигнал границата на Парето, която е най-добрият баланс между производителност и цена.
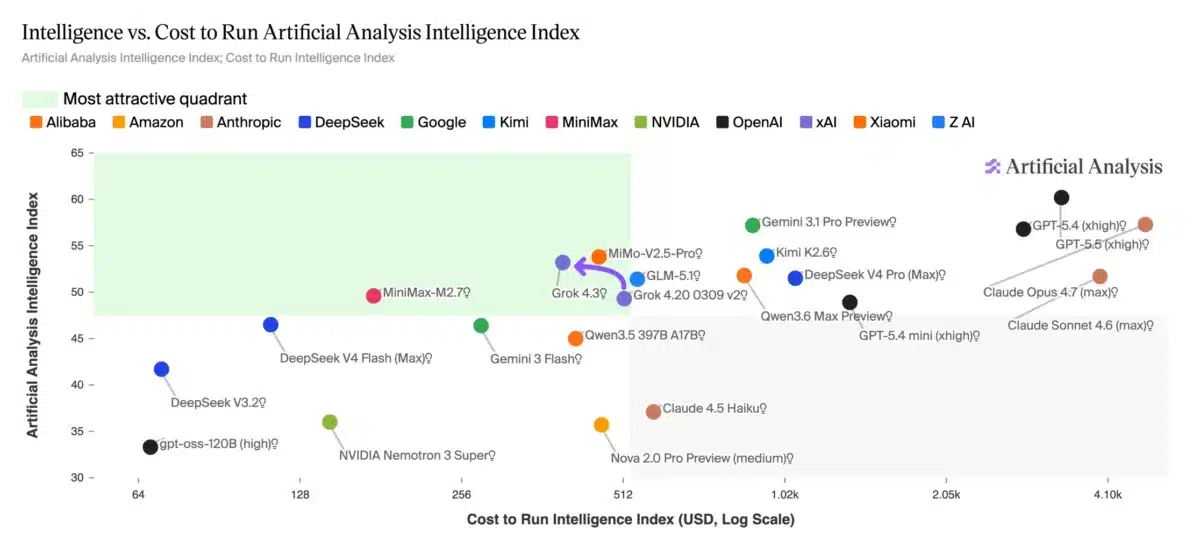
Grok 4.3 се представя добре на графиката с резултат 53 и цена от $395, докато GPT-5.5 и Claude Opus 4.7 са по-мощни, но значително по-скъпи. Източник на изображението: Artificial Analysis.
По GDPval-AA, тестът, който измерва производителността на изкуствения интелект при задачите, подобни на интелектуална работа в реалния свят, в рейтинга Elo, Grok 4.3 скочи с 321 точки до 1500. Докато моделът надмина Gemini 3.1 на Google, GPT-5.5 на OpenAI все още води с 276 точки по рейтинга Elo.
Останалите тестове бяха по-неблагоприятни за новия продукт. Andon Labs, който използва ИИ модел за работа с автомат за закуски, се провали в задачите за автономни агенти: моделът понякога е в бездействие, вместо да действа. „Изглежда, че има нарколепсия: предпочита да спи с дни, вместо да действа“, пише Andon Labs. Независимата услуга Vals AI постави Grok 4.3 на първо място в тестовете CaseLaw и CorpFin, но се класира едва на 13-то място в тестовете за общо кодиране и сложни математически задачи.
В допълнение към Grok 4.3, xAI пусна бета-версия на Agent Mode за Grok Imagine чрез уеб-интерфейса на Grok. Този режим не е предназначен за индивидуални заявки, а за дългосрочни творчески проекти: AI-агентът планира, генерира, редактира и усъвършенства материалите. Според xAI, инструментът е подходящ за създаване на едноминутен филм или продуктови истории. Agent Mode се активира чрез полето за въвеждане в долния ляв ъгъл на уеб-интерфейса и изисква платен абонамент.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
