



Изследователи от университета в Цюрих, университета в Амстердам, университета Дюк и университета в Ню Йорк са използвали нов тест, за да открият, че AI-моделите могат лесно да бъдат разграничени от хората по прекалено приятелския им емоционален тон.
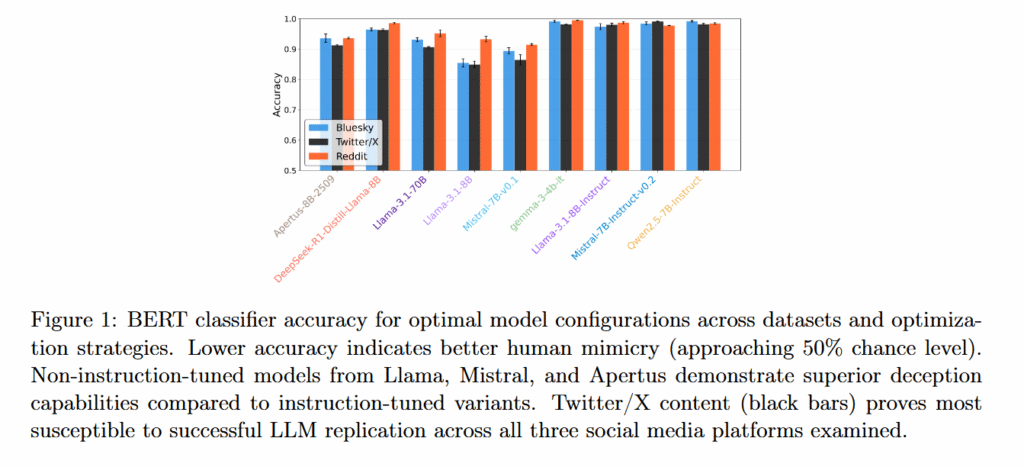
Проучването тества девет модела с отворен код: Llama 3.1 8B, Llama 3.1 8B Instruct, Llama 3.1 70B, Mistral 7B v0.1, Mistral 7B Instruct v0.2, Qwen 2.5 7B Instruct, Gemma 3 4B Instruct, DeepSeek-R1-Distill-Llama-8B и Apertus-8B-2509, използвайки публикации от социалната мрежа X, Bluesky и Reddit. Резултатите показват, че разработените класификатори разпознават генерираните от изкуствен интелект отговори с точност от 70-80%.
Авторите представиха така наречения „изчислителен тест на Тюринг“, за да оценят близостта на ИИ моделите до езика, който се говори от обикновените интернет потребители. Разработеният фреймуърк използва автоматизирани класификатори и лингвистичен анализ, за да идентифицира специфичните характеристики, които разграничават генерираното от изкуствен интелект съдържание от създаденото от хора.
„Дори след калибриране, резултатите от LLM остават ясно различни от човешкия текст, особено по отношение на емоционалния тон и изразяване“ — подчертават авторите на изследването.
Екип, ръководен от Николо Паган от Университета в Цюрих, тества различни стратегии за оптимизация — от прости подкани до фина настройка, но установи, че по-дълбоките емоционални сигнали се запазват като надеждни индикатори, че дадено онлайн текстово взаимодействие е инициирано от чатбот, а не от човек. Когато изкуственият интелект е бил помолен да отговори на реални публикации в социалните медии, LLM се е затруднил да постигне нивото на неформален негативизъм и спонтанно емоционално изразяване, присъщи на човешките публикации. Резултатите за токсичност са били постоянно по-ниски от тези на хората.
За да се справят с този недостатък, изследователите са се опитали да приложат стратегии за оптимизация, включително предоставяне на примери и търсене на подходящо съдържание. Тези стратегии са били предназначени да намалят структурните разлики, включително и дължината на изреченията и качеството на думите, но разликите в емоционалните компоненти са оставали.
„Нашите комплексни калибровъчни тестове поставят под съмнение предположението, че по-сложната оптимизация задължително води до по-човешки резултати“ — заключват учените.
Освен това беше открит неочакван резултат. Моделите, настроени към специфични инструкции и обучавани за период от продължително време, са се представили по-зле в имитирането на хора, отколкото техните базови ИИ-аналози. Модели като Llama 3.1 8B и Mistral 7B v0.1 са демонстрирали по-добра имитация на човешкото поведение без настройване на инструкции, постигайки точност на класификацията от 75% до 85%.
Мащабирането на моделите също не е довело до никакви ползи. Llama 3.1, със 70 милиарда параметъра, се е представил по-зле от по-малките модели с 8 милиарда параметъра. Когато ИИ-моделите са били настроени да избягват откриването чрез имитиране на човешки стил на писане, те все повече са се отклонявали от това, което хората действително са писали в отговор на същите съобщения (семантичният им резултат за сходство с реалните човешки отговори е спаднал от средна стойност от приблизително 0,18-0,34 до 0,16-0,28 в различните платформи). След оптимизация, за да съответстват на съдържанието на човешките отговори, генерираните от изкуствен интелект текстове са станали по-лесни за разграничаване като изкуствени.
В проучването, простите методи за оптимизация за намаляване на откриваемостта превъзхождат сложните. Предоставянето на реални примери за минали публикации на потребителя или получаването на подходящ контекст постоянно затруднява изкуствения интелект да разграничава машинния текст от човешкия, докато сложните подходи, като например предоставянето на описание на личността на потребителя и фина настройка на модела, имат малко или дори отрицателно въздействие върху реализма.
Разликите между социалните платформи също са демонстрирали колко ефективно изкуственият интелект може да имитира хората. Класификаторите са открили отговорите на LLM в X с най-ниска точност, следвани от Bluesky и Reddit, където текстовете с изкуствен интелект са били най-лесни за разграничаване от човешките.
Изследователите предполагат, че този модел отразява както специфичния разговорен стил на всяка платформа, така и степента, до която данните от всяка платформа са били използвани по време на първоначалното обучение на моделите. Проучването показва, че съществуващите модели се сблъскват с постоянни ограничения при улавянето на спонтанните емоционални изрази, докато процентът на откриване остава значително по-висок от случайността. Това не означава, че изкуственият интелект не може потенциално да симулира такъв резултат; просто е много по-трудно, отколкото са очаквали изследователите.
Резултатите са публикувани на сървъра arXiv.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
