



Компаниите, които изграждат големи езикови модели, все по-често се сблъскват с проблема с липсата на качествени данни и риска от „запаметяване“ на чувствителна информация. За да избегнат това, изследователите на Google разработиха VaultGemma – отворен модел с интегрирани техники за диференцирана защита на личните данни. Тази технология намалява риска от случайното разкриване на лична информация и материали, защитени с авторски права. В същото време VaultGemma се представя толкова добре, колкото и моделите с подобни размери.
Големите езикови модели (LLM) имат недетерминистичен изход, което означава, че е невъзможно да се предвиди какво точно ще генерират. Дори при едни и същи заявки резултатите могат да варират. В същото време моделите понякога възпроизвеждат фрагменти от информацията от наборите от данни за обучение. Ако тези набори от данни съдържат лична информация за потребителите, това може да наруши неприкосновеността на личния живот. По същия начин, ако наборът от данни за обучение съдържа материали, защитени с авторски права, те могат да се появят в отговорите на модела. Това е проблем за разработчиците.
Диференциалната защита на личните данни решава този проблем чрез добавяне на калибриран „шум“ по време на фазата на обучение. По този начин вероятността моделът да „запомни“ конкретни данни е по-малка. Този подход обаче може да намали точността и да увеличи изискванията за изчислителни ресурси. Досега е направено само малко проучване за това как диференциалната поверителност влияе върху мащабирането и производителността на моделите.
Изследователският екип на Google е провел експерименти с различни размери на модела и нива на шума, за да изследва законите на мащабиране на поверителността. Те установиха, че производителността на модела зависи от съотношението между шума и размера на пакета данни: твърде многото шум намалява качеството, освен ако не се компенсира с повече изчисления или данни. Тези резултати помагат на разработчиците да намерят баланса между поверителността, изчислителния бюджет и качеството на модела.
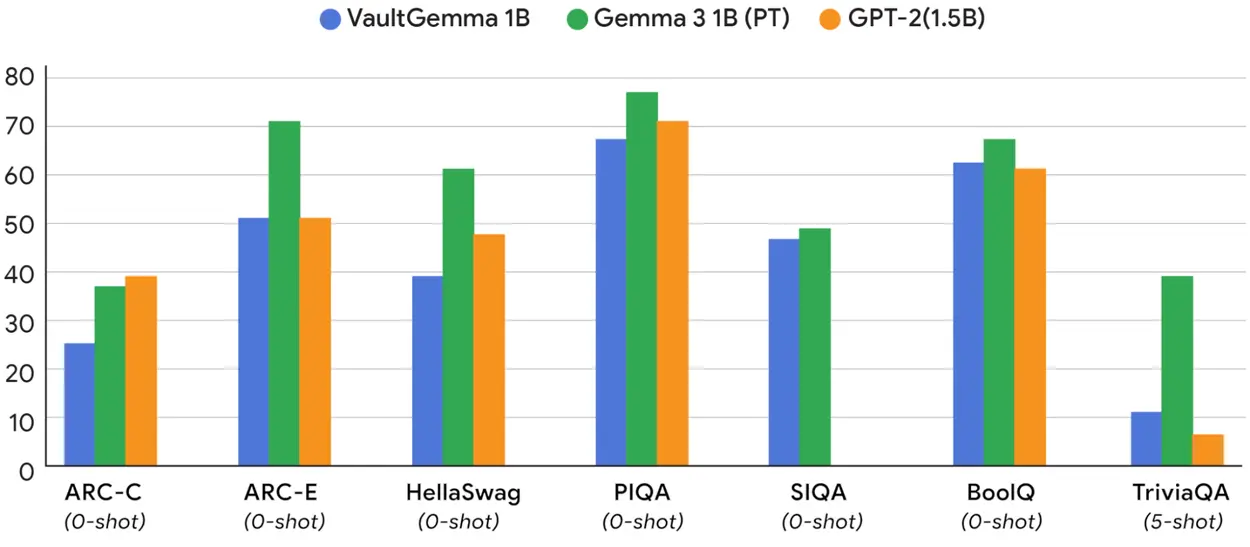
Въз основа на това изследване беше създаден моделът VaultGemma, базиран на Gemma 2, който има 1 милиард параметъра. Моделът използва диференцирана поверителност, за да намали риска от разкриване на информация, като същевременно производителността му е сравнима с конвенционалните модели с подобен размер.
Тестовете показаха, че VaultGemma се представя добре при обичайните задачи на изкуствения интелект. Диференциалната поверителност може да бъде полезна при услугите, които обработват лични или корпоративни данни, при които поверителността е от критично значение.
VaultGemma вече е на разположение за изтегляне в Hugging Face и Kaggle. Моделът е с отворен код, но сорс кодът не е напълно отворен. Потребителите могат да променят и разпространяват модела, като спазват лиценза на Gemma.
 Всичко важно от света на технологиите, директно в пощата ти.
С абонирането приемате нашите Условия и Политика за поверителност. Може да се отпишете с един клик по всяко време.
Коментирайте статията в нашите Форуми. За да научите първи най-важното, харесайте страницата ни във Facebook, и ни последвайте в Google Новини, TikTok, Telegram и Viber или изтеглете приложението на Kaldata.com за Android, iPhone, Huawei, Google Chrome, Microsoft Edge и Opera!
